# Unsicherheit in Supply Chains und Pooling {#sec-unsicherheit-pooling}
::: {.lernziele}
**Lernziele**
Nach diesem Kapitel können Sie …
- Quellen und Auswirkungen von Unsicherheit in Supply Chains **erläutern**,
- Nachfrageunsicherheit, implizierte Unsicherheit und Reaktionsfähigkeit **voneinander abgrenzen**,
- den Effekt von Risikopooling auf Nachfragevarianz und Sicherheitsbestände **analysieren**,
- zentrale und dezentrale Bestandsstrukturen unter Unsicherheit **vergleichen und beurteilen**,
- das **Quadratwurzelgesetz des Pooling** algebraisch **herleiten**, in R **implementieren** und seine Voraussetzungen **kritisch einordnen**,
- Zufallszahlen in R **erzeugen**, mit `set.seed()` **reproduzierbar** machen, einfache **Monte-Carlo-Simulationen** durchführen und empirische Verteilungen mit `ecdf()` **auswerten**.
**Literatur zur Vertiefung**
- Pooling, Nachfragevariabilität und Bestandsentscheidungen: @cachon2024matching, Kapitel 10–13.
- Sicherheitsbestände, Servicegrade und Inventory-Management: @silver2017inventory, Kapitel 6–8.
:::
```{r}
#| label: ch6-setup
#| message: false
#| warning: false
# Pakete für dieses Kapitel: Datenmanipulation, Visualisierung, Tabellen
library(tidyverse)   # dplyr, tidyr, ggplot2, purrr, ...
library(kableExtra)  # formatierte Tabellen für HTML/PDF
# MASS wird nicht geladen (würde dplyr::select() überdecken); Aufruf über MASS::mvrnorm()

# Die im Buch wiederverwendeten SCM-Funktionen (u.a. pooling_safety_stock(),
# simuliere_tS(), tS.lager()) liegen gebündelt in R/scm_functions.R
source("../R/scm_functions.R")
source("../R/scm_helpers.R")     # Darstellungshilfen (Farben, Tabellen, Formatierung)
```
Kapitel [-@sec-standort-1] und [-@sec-standort-2] haben gezeigt, wie Standorte und Netzwerke **unter der Annahme bekannter, fixer Nachfragen** geplant werden. In der Realität ist diese Annahme fast nie erfüllt: Nachfrage schwankt von Periode zu Periode, Lieferzeiten variieren, und Kapazitäten müssen lange im Voraus festgelegt werden, bevor überhaupt bekannt ist, wie viel tatsächlich benötigt wird. Dieses Kapitel behandelt, wie Supply Chains mit dieser **Unsicherheit** umgehen — durch geeignete Quantifizierung, durch Sicherheitsbestände und, als zentrales Gestaltungsprinzip, durch **Pooling**: die Bündelung von Kapazitäten oder Lagerbeständen, um Nachfrageschwankungen gegenseitig auszugleichen.
Als durchgehendes Anwendungsbeispiel dient wieder die fiktive **SushiFresh GmbH**, ein regionaler Hersteller frischer Sushi-Boxen im Rhein-Main-Gebiet, der täglich sechs Supermarkt-Filialen in Wiesbaden, Mainz, Frankfurt, Rüsselsheim, Darmstadt und Offenbach beliefert. Kapitel [-@sec-standort-2] endete mit einer offenen Frage: Das Warehouse Location Problem empfahl einen zentralen Standort in **Raunheim**, ließ aber offen, ob ein zweiter Standort hinzukommen sollte – die Kostenunterschiede waren gering, und ein wichtiger Effekt blieb unberücksichtigt: die **Bestände**, die zur Absicherung gegen Nachfrageschwankungen vorgehalten werden müssen. Dieses Kapitel knüpft genau dort an. Es fragt, wie hoch der Sicherheitsbestand bei einer zentralen Versorgung aus einer **Zentralküche in Raunheim** ausfällt – und wie stark er sich vom Fall unterscheidet, in dem jede Filiale eigenständig disponiert.
Der rote Faden dieses Kapitels lässt sich in drei Schritten zusammenfassen. Zunächst wird geklärt, **woher** Unsicherheit kommt und wie sie sich systematisch einordnen lässt (implizierte Unsicherheit). Anschließend wird gezeigt, wie sich Unsicherheit **quantitativ bepuffern** lässt — über Sicherheitsbestände, die an einen gewünschten Servicegrad gekoppelt sind. Und schließlich wird das eigentliche Kernthema entfaltet: Wie lässt sich der dafür nötige Puffer **verringern**, ohne den Servicegrad zu senken? Die Antwort — Pooling — wird dabei an zwei strukturell verwandten, aber ökonomisch unterschiedlichen Beispielen durchgespielt: an **Produktionskapazitäten** (Pilotphase von SushiFresh, in der zwei Küchen flexibel füreinander einspringen) und an **Lagerbeständen** (die sechs Filialen, die nach der Zentralisierungsentscheidung aus Kapitel [-@sec-standort-2] nun von einem gemeinsamen Werk aus versorgt werden). Beide Anwendungen laufen am Ende auf dieselbe mathematische Struktur hinaus, die im **Quadratwurzelgesetz des Pooling** kulminiert.
## Die Natur der Unsicherheit in Supply Chains
### Nachfrageunsicherheit und implizierte Unsicherheit
Jede Supply Chain muss zwei Dinge gleichzeitig leisten: Sie muss **effizient** sein (niedrige Kosten) und **reaktionsfähig** (schnelle, zuverlässige Verfügbarkeit). Wie stark eine Supply Chain auf Reaktionsfähigkeit statt auf Kosteneffizienz ausgelegt sein sollte, hängt von der **implizierten Unsicherheit** (*implied uncertainty*) ab, die sie zu bewältigen hat [@chopra2025supply, Kap. 2]. Implizierte Unsicherheit ist dabei nicht einfach gleichbedeutend mit "die Nachfrage ist schwer vorherzusagen" — sie ergibt sich aus dem **Zusammenspiel zweier Quellen**:
1. **Nachfrageunsicherheit**: Wie stark schwankt die tatsächliche Nachfrage um ihren Erwartungswert? Salz oder Grundnahrungsmittel haben eine sehr stabile, gut prognostizierbare Nachfrage; Modeartikel oder Unterhaltungselektronik mit kurzen Lebenszyklen dagegen kaum.
2. **Liefervariabilität**: Wie zuverlässig sind Beschaffungsmengen und -zeiten? Beton oder Kohle lassen sich praktisch beliebig und pünktlich liefern; Halbleiter oder Fangerträge in der Fischerei unterliegen dagegen erheblichen Schwankungen.
Produkte mit niedriger Nachfrage- und Liefervariabilität werden als **funktional** bezeichnet — sie lassen sich in **effizienten** (kostenoptimierten) Supply Chains mit geringen Puffern verwalten. Produkte mit hoher Variabilität gelten als **innovativ** und benötigen **reaktionsfähige** Supply Chains mit Kapazitäts- und Bestandspuffern, um Fehlmengen zu vermeiden. Dazwischen liegen **hybride** Güter. Diese Einteilung ist als *Implied Uncertainty Spectrum* bekannt: An einem Ende stehen Güter wie Salz oder Grundnahrungsmittel, am anderen Ende Fashion-Artikel oder neueste Telefonchips. SushiFresh' Sushi-Boxen liegen dabei klar im **hybriden bis innovativen** Bereich: Die Nachfrage selbst ist nicht extrem volatil, wird aber durch Wetter, Wochentag und Feiertage spürbar beeinflusst — hinzu kommt eine **sehr kurze Haltbarkeit** (frischer Fisch, Reis, keine Lagerfähigkeit über Tage hinweg), die Fehlmengen und Überproduktion beide besonders teuer macht. Für eine Supply-Chain-Managerin oder einen -Manager ist die zentrale Konsequenz: **Die Wahl der Lagerhaltungsstrategie, der Kapazitätsauslegung und der Sicherheitsbestände muss zur implizierten Unsicherheit des jeweiligen Produkts passen** — ein Standardprodukt und ein Frischeprodukt wie eine Sushi-Box erfordern grundsätzlich unterschiedliche Antworten auf Unsicherheit.
### Das Grunddilemma: fixe Kapazität, variable Nachfrage
Der Kern des Problems liegt in einer zeitlichen Asymmetrie: Kapazitäten — Fabrikhallen, Lagerflächen, Personal, Maschinen — müssen **ex ante**, also lange bevor die tatsächliche Nachfrage bekannt ist, festgelegt werden. Die Nachfrage selbst realisiert sich dagegen **ex post**. Aus dieser Asymmetrie folgt ein **struktureller Mismatch**, der sich nicht durch bessere Planung allein beseitigen lässt: Ist die realisierte Nachfrage $d$ höher als die verfügbare Kapazität $C$, entstehen entgangene Umsätze (*Lost Sales*); ist $d$ niedriger als $C$, entstehen Leerkosten durch ungenutzte Kapazität. Nur im Grenzfall $d \approx C$ — der bei zufälliger Nachfrage so gut wie nie exakt eintritt — wären beide Effekte gleichzeitig vermieden.
Um diesen Mechanismus zu veranschaulichen, ist es hilfreich, Nachfrage nicht als einzelne Zahl, sondern als **Zufallsvariable** zu behandeln. R bietet dafür ein durchgängiges Konzept für Wahrscheinlichkeitsverteilungen, das im Folgenden eingeführt wird.
::: {.r-exkurs}
**R-Exkurs: Wahrscheinlichkeitsverteilungen in R — `rnorm()`, `dnorm()`, `pnorm()`, `qnorm()`**
Für jede in R implementierte Wahrscheinlichkeitsverteilung — hier die **Normalverteilung** $\mathcal{N}(\mu, \sigma^2)$ — existiert eine Familie von vier Funktionen mit demselben Namensstamm (`norm`), die sich nur im Anfangsbuchstaben unterscheiden. Diese vier Buchstaben stehen für vier grundsätzlich verschiedene Fragestellungen:
| Funktion | Frage, die sie beantwortet | Rückgabewert |
|---|---|---|
| `rnorm(n, mean, sd)` | "Gib mir `n` **zufällige** Realisierungen" | Zufallszahlen |
| `dnorm(x, mean, sd)` | "Wie **dicht/wahrscheinlich** ist der Wert `x`?" | Dichte $f(x)$ |
| `pnorm(q, mean, sd)` | "Mit welcher Wahrscheinlichkeit ist der Wert $\leq$ `q`?" | Verteilungsfunktion $F(q)$ |
| `qnorm(p, mean, sd)` | "Welcher Wert wird mit Wahrscheinlichkeit `p` **nicht überschritten**?" | Quantil $F^{-1}(p)$ |
`pnorm()` und `qnorm()` sind zueinander invers: `pnorm()` geht von einem Wert zu einer Wahrscheinlichkeit, `qnorm()` von einer Wahrscheinlichkeit zurück zu einem Wert. Genau dieses Quantil $F^{-1}(\alpha)$ wird später bei der Berechnung von Sicherheitsbeständen zentral sein.
```{r}
#| label: ch6-rnorm-demo
#| message: false
# Angenommene taegliche Nachfrage nach Sushi-Boxen in der Filiale Wiesbaden
# sei N(mu = 120, sigma = 25) verteilt (siehe Filialtabelle weiter unten)
mu_d    <- 120
sigma_d <- 25

# r*: 5 zufällige Nachfragerealisierungen ziehen
rnorm(5, mean = mu_d, sd = sigma_d)
# d*: Wie wahrscheinlich (dicht) ist eine Nachfrage von genau 120 Boxen (dem Mittelwert)?
dnorm(120, mean = mu_d, sd = sigma_d)
# p*: Mit welcher Wahrscheinlichkeit liegt die Nachfrage bei höchstens 150 Boxen?
pnorm(150, mean = mu_d, sd = sigma_d)
# q*: Welche Boxenmenge wird mit 95 % Wahrscheinlichkeit nicht überschritten?
qnorm(0.95, mean = mu_d, sd = sigma_d)
```
Die letzte Zeile liefert bereits die Denkfigur, die später den Sicherheitsbestand definiert: **Ein Lagerbestand in Höhe dieses Quantils deckt die Nachfrage mit der gewünschten Wahrscheinlichkeit ab.** Mit rund 161 Boxen müsste die Filiale Wiesbaden also bevorratet sein, um die tägliche Nachfrage mit 95 %iger Wahrscheinlichkeit vollständig zu decken.
:::
Zufallszahlen, die einmal gezogen wurden, sind bei jedem erneuten Aufruf von `rnorm()` anders — das ist für Sensitivitätsanalysen erwünscht, macht aber Ergebnisse schwer nachvollziehbar und nicht reproduzierbar. Für Lehrbeispiele, Übungen und auch für die Fehlersuche in eigenem Code ist es deshalb wichtig, den Zufallszahlengenerator kontrollieren zu können.
::: {.r-exkurs}
**R-Exkurs: Reproduzierbare Zufallszahlen mit `set.seed()`**
R erzeugt "Zufallszahlen" technisch gesehen deterministisch über einen **Pseudozufallszahlengenerator**: Ausgehend von einem internen Zustand (dem *seed*) wird eine Folge von Zahlen berechnet, die statistisch wie echte Zufallszahlen aussieht. Wird der seed mit `set.seed(n)` auf einen festen Wert `n` gesetzt, liefert jeder nachfolgende Aufruf von `rnorm()`, `rpois()`, `sample()` etc. **exakt dieselbe Folge** — unabhängig davon, wer den Code wann ausführt.
```{r}
#| label: ch6-setseed-demo
# Ohne set.seed(): zwei Aufrufe liefern (praktisch sicher) unterschiedliche Werte
rnorm(3)
rnorm(3)
# Mit identischem seed vor jedem Aufruf: exakt reproduzierbare Ergebnisse
set.seed(2026)
rnorm(3)
set.seed(2026)
rnorm(3)   # identisch zur vorherigen Zeile
```
Für alle folgenden Simulationen in diesem Kapitel wird `set.seed()` konsequent verwendet, damit die berichteten Zahlen und Abbildungen exakt nachvollziehbar bleiben.
:::
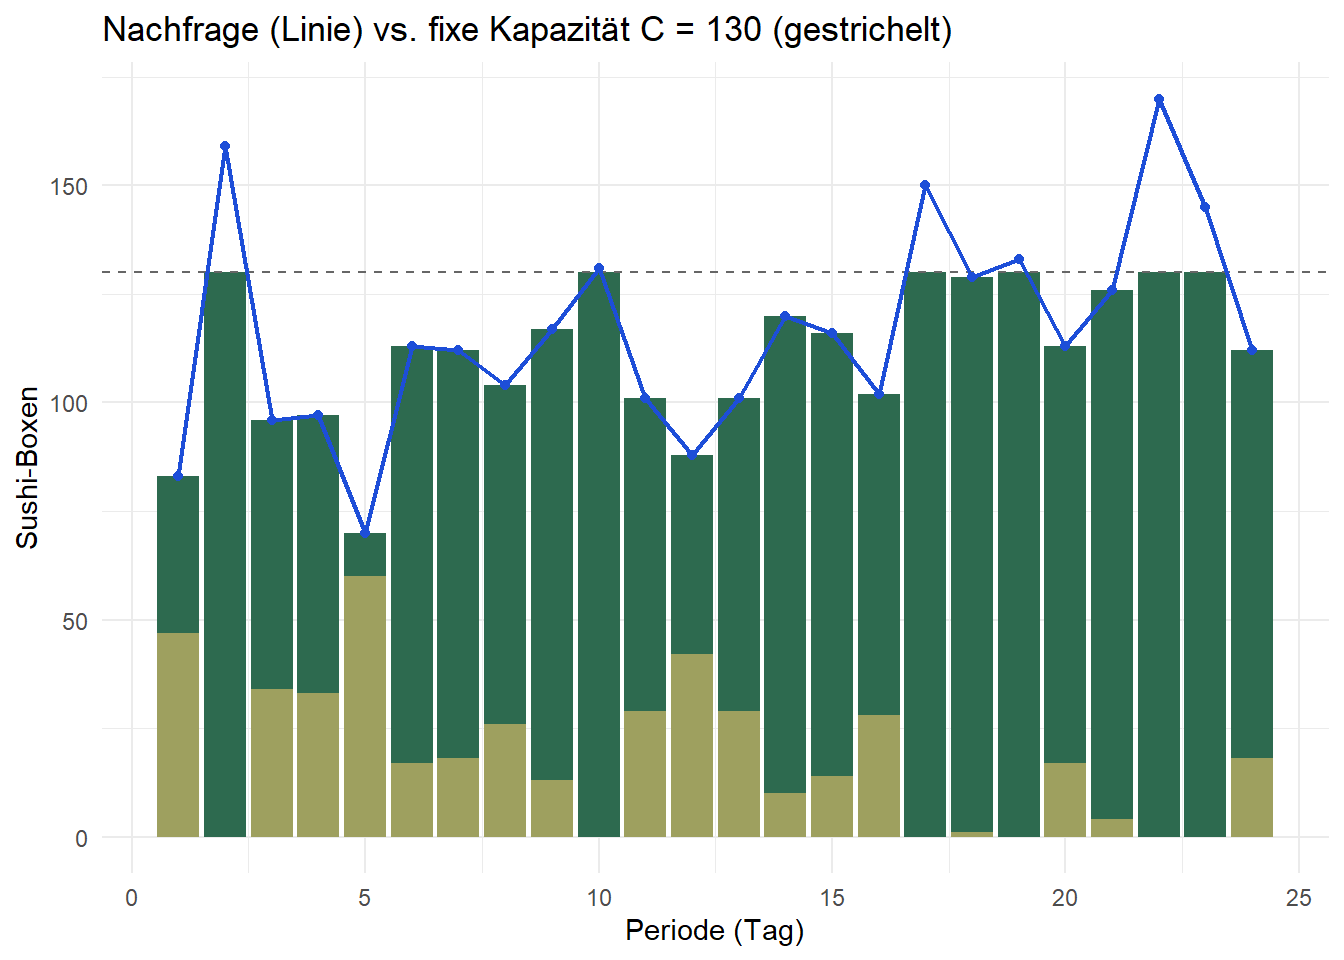
Mit diesem Werkzeug lässt sich der eingangs beschriebene Mismatch zwischen Kapazität und Nachfrage direkt simulieren. Angenommen, die (heute zentrale) Produktion für die Filiale Wiesbaden hätte — als sie in einer früheren Ausbaustufe noch eigenständig disponiert wurde — eine feste Kapazität von $C = 130$ Boxen pro Tag, während die tatsächliche Nachfrage normalverteilt mit $\mu = 120$ und $\sigma = 25$ um diese Kapazität schwankt:
```{r}
#| label: ch6-mismatch-sim
#| fig-cap: "Mismatch zwischen fixer Kapazität und stochastischer Nachfrage (Filiale Wiesbaden)"
set.seed(12)             # reproduzierbare Simulation
n_perioden <- 24
C <- 130                 # fixe Kapazität (Boxen/Tag)

demand_mismatch <- tibble(
  periode        = 1:n_perioden,
  # Nachfrage ziehen, auf ganze Zahlen runden, negative Werte ausschließen
  nachfrage      = pmax(40, round(rnorm(n_perioden, mu_d, sigma_d))),
  produktion     = pmin(nachfrage, C),        # tatsächlich Verkauftes
  fehlmenge      = pmax(0, nachfrage - C),    # Lost Sales
  leerkapazitaet = pmax(0, C - nachfrage)     # ungenutzte Kapazität
)

ggplot(demand_mismatch, aes(x = periode)) +
  # Balken: Produktion (dunkel) + Leerkapazität (hell) bis zur Kapazitätsgrenze
  geom_col(aes(y = produktion), fill = "#2D6A4F") +
  geom_col(aes(y = leerkapazitaet, group = 1), fill = "#E9C46A", alpha = 0.6,
           position = position_nudge(y = 0)) +
  geom_hline(yintercept = C, linetype = "dashed", color = "grey40") +
  geom_line(aes(y = nachfrage), color = "#1D4ED8", linewidth = 0.8) +
  geom_point(aes(y = nachfrage), color = "#1D4ED8") +
  labs(x = "Periode (Tag)", y = "Sushi-Boxen",
       title = "Nachfrage (Linie) vs. fixe Kapazität C = 130 (gestrichelt)") +
  theme_minimal()
# Anteil der Perioden mit Fehlmenge bzw. mit Leerkapazität
mean(demand_mismatch$fehlmenge > 0)
mean(demand_mismatch$leerkapazitaet > 0)
```
Obwohl die Kapazität mit 130 Boxen deutlich über der erwarteten Nachfrage von 120 Boxen liegt, treten in diesem Simulationslauf an 25 % der Tage **Fehlmengen** und an 75 % der Tage **Leerkapazität** auf — je nachdem, ob die zufällige Realisierung über oder unter der Kapazitätsgrenze liegt. Das ist keine Folge schlechter Planung, sondern eine unvermeidliche Konsequenz der Kombination aus fixer Kapazität und stochastischer Nachfrage. Bei einem Frischeprodukt wie einer Sushi-Box wiegt das besonders schwer: Leerkapazität bedeutet hier nicht nur ungenutzte Maschinenzeit, sondern bei Überproduktion auch **Lebensmittelverschwendung**, während Fehlmengen unmittelbar zu entgangenem Umsatz und enttäuschten Filialpartnern führen. Genau dieses Dilemma begegnet SushiFresh auch anderswo: an Feiertagen mit Nachfragespitzen, bei plötzlichen Wetterumschwüngen oder bei kurzfristigen Werbeaktionen einzelner Filialen.
Die zentrale gestalterische Frage dieses Kapitels lautet daher: **Wie lässt sich dieser Mismatch — ohne zusätzliche physische Kapazität — verringern?** Eine der wirkungsvollsten Antworten ist Pooling.
## Kapazitätspooling: Risikoausgleich bei Produktionskapazitäten
### Formen des Pooling im Überblick
Der Begriff **Pooling** (auch *Risikoausgleich* oder *risk pooling*) bezeichnet allgemein die Bündelung von Ressourcen, Beständen oder Nachfragen, um zufällige Schwankungen gegenseitig auszugleichen. In der Literatur werden dabei typischerweise mehrere Ausprägungen unterschieden [vgl. @silver2017inventory, Kap. 6; @simchilevi2010operations]:
- **Standort-/Bestandspooling**: mehrere regionale Läger werden zu einem Zentrallager zusammengelegt (Fokus dieses Kapitels, siehe Abschnitt zum Lagerbestandspooling — bei SushiFresh die Konsolidierung der Versorgung auf eine Zentralküche, wie sie Kapitel [-@sec-standort-2] nahelegt).
- **Kapazitätspooling**: mehrere Produktionsanlagen werden so flexibilisiert, dass sie füreinander einspringen können (Fokus des folgenden Abschnitts).
- **Produktpooling**: mehrere Produktvarianten werden möglichst lange als ein gemeinsames, undifferenziertes Zwischenprodukt geführt und erst spät im Wertschöpfungsprozess final konfiguriert (*Postponement*).
- **Kapazitäts-/Komponentenpooling durch Standardisierung**: gemeinsame Bauteile oder Module werden über mehrere Endprodukte hinweg genutzt, wodurch sich deren Bedarfe in der Beschaffung poolen (bei SushiFresh z. B. eine gemeinsame Reis- oder Nori-Beschaffung für alle Boxvarianten).
Alle diese Varianten folgen demselben statistischen Grundprinzip, das im weiteren Verlauf dieses Kapitels am Beispiel von Kapazitäten und anschließend von Lagerbeständen formal hergeleitet wird. Wir beginnen mit einem Blick zurück in die Gründungsphase von SushiFresh, lange bevor die Entscheidung aus Kapitel [-@sec-standort-2] fiel.
### Ausgangssituation: zwei Pilotküchen, keine Flexibilität
In der Gründungsphase belieferte SushiFresh zunächst nur zwei Pilotstandorte — die heutigen Filialen **Wiesbaden** und **Mainz** — jeweils über eine eigene, kleine Produktionsküche direkt vor Ort [Struktur des Beispiels vgl. @cachon2024matching, Kap. 17]. Jede Küche war ausschließlich für ihren eigenen Standort eingerichtet — es gab **keine technologische Flexibilität**. Beide Küchen hatten dieselbe Kapazität $C^1 = C^2 = 90$ Boxen pro Tag. Über zwölf (Pilot-)Monate wurden folgende Nachfragen beobachtet:
```{r}
#| label: ch6-pooling-data
C1 <- C2 <- 90   # Kapazität je Küche (Boxen pro Tag, Pilotphase)

cp_data <- tibble(
  Monat = 1:12,
  dA    = c(78, 79, 92, 76, 95, 104, 87, 92, 91, 85, 96, 93),  # Nachfrage Pilotstandort Wiesbaden
  dB    = c(102, 92, 93, 87, 80, 97, 90, 76, 89, 86, 89, 93)   # Nachfrage Pilotstandort Mainz
)

# Ohne Pooling: jede Küche bedient ausschließlich ihren eigenen Standort,
# Absatz ist durch die Kapazität nach oben gedeckelt
cp_data <- cp_data |>
  mutate(xA = pmin(dA, C1),
         xB = pmin(dB, C2))

# Mittlere Nachfrage, mittlerer Absatz und Auslastung je Küche
cp_data |>
  summarise(E_dA = mean(dA), E_dB = mean(dB),
            E_xA = mean(xA), E_xB = mean(xB),
            Auslastung_1 = mean(xA) / C1, Auslastung_2 = mean(xB) / C2)
```
Beide Küchen sind mit rund 96–97 % gut ausgelastet, und der Lieferservicegrad (Anteil der Nachfrage, der tatsächlich beliefert wird) liegt bereits über 97 %. Dennoch entstehen **in Summe über das Jahr** sowohl Fehlmengen (wenn die Nachfrage über 90 liegt) als auch Leerkapazität (wenn sie darunterliegt) — ein direktes Beispiel für den im vorigen Abschnitt beschriebenen strukturellen Mismatch, diesmal auf zwei parallele Pilotküchen angewendet.
### Einseitiges und zweiseitiges Kapazitätspooling
Die entscheidende Frage lautet: Kann eine Küche aushelfen, wenn der jeweils andere Standort überlastet ist? Angenommen, die Küche Wiesbaden wird technisch so aufgerüstet, dass sie **zusätzlich** zu ihrem eigenen Standort auch Boxen für Mainz produzieren kann (**einseitiges Pooling**). Sobald an einem Tag die Nachfrage in Mainz die Kapazität von Küche Mainz übersteigt ($d^B_t > C^2$) und Küche Wiesbaden noch freie Kapazität hat ($d^A_t < C^1$), springt sie ein:
$$
x_t^{1} = d_t^A + \min\bigl(C^1 - d_t^A;\; d_t^B - C^2\bigr), \qquad x_t^{2B} = C^2
$$
```{r}
#| label: ch6-pooling-onesided
cp_pool_1 <- cp_data |>
  mutate(
    # Küche Wiesbaden deckt zunächst den eigenen Standort, produziert bei
    # freier Kapazität zusätzlich für Mainz
    x1A = pmin(dA, C1),
    x1B = ifelse(dB > C2 & dA < C1, pmin(C1 - dA, dB - C2), 0),
    x1  = x1A + x1B,
    x2B = pmin(C2, dB),
    xB  = x2B + x1B                 # gesamter Absatz in Mainz
  )

cp_pool_1 |>
  summarise(Auslastung_Kueche1 = mean(x1) / C1,
            Servicegrad_Mainz  = mean(xB) / mean(dB))
```
Der Lieferservicegrad in Mainz steigt bereits durch dieses **einseitige** Aushelfen spürbar. Lässt man zusätzlich auch die Küche Mainz bei Bedarf für Wiesbaden einspringen (**zweiseitiges Pooling**), wird die Trennung zwischen Küchen und Standorten faktisch aufgehoben:
```{r}
#| label: ch6-pooling-twosided
cp_pool <- cp_data |>
  mutate(
    x1A = pmin(dA, C1),
    x1B = ifelse(dB > C2 & dA < C1, pmin(C1 - dA, dB - C2), 0),
    x1  = x1A + x1B,
    x2B = pmin(C2, dB),
    x2A = ifelse(dA > C1 & dB < C2, pmin(C2 - dB, dA - C1), 0),
    x2  = x2A + x2B,
    xA  = x1A + x2A,
    xB  = x1B + x2B
  )

cp_pool |>
  summarise(Auslastung_1 = mean(x1) / C1, Auslastung_2 = mean(x2) / C2,
            Servicegrad_Wiesbaden = mean(xA) / mean(dA),
            Servicegrad_Mainz     = mean(xB) / mean(dB))
```
```{r}
#| label: ch6-kpi-table
#| tbl-cap: "Kennzahlenvergleich: kein Pooling vs. ein- vs. zweiseitiges Pooling (Pilotphase SushiFresh)"
# Absolute Lost Sales über alle 12 Monate, je Szenario
kpi_df <- tibble(
  Kennzahl = c("Auslastung Küche Wiesbaden (%)", "Auslastung Küche Mainz (%)",
               "Verkaufsquote Wiesbaden (%)", "Verkaufsquote Mainz (%)",
               "Lost Sales gesamt (Boxen)"),
  Dezentral = c(round(mean(cp_data$xA) / C1 * 100, 1),
                round(mean(cp_data$xB) / C2 * 100, 1),
                round(sum(cp_data$xA) / sum(cp_data$dA) * 100, 1),
                round(sum(cp_data$xB) / sum(cp_data$dB) * 100, 1),
                sum(cp_data$dA - cp_data$xA) + sum(cp_data$dB - cp_data$xB)),
  Pooling_einseitig = c(round(mean(cp_pool_1$x1) / C1 * 100, 1),
                round(mean(cp_pool_1$x2B) / C2 * 100, 1),
                round(sum(cp_pool_1$x1A) / sum(cp_data$dA) * 100, 1),
                round(sum(cp_pool_1$xB) / sum(cp_data$dB) * 100, 1),
                sum(cp_data$dA - cp_pool_1$x1A) + sum(cp_data$dB - cp_pool_1$xB)),
  Pooling_zweiseitig = c(round(mean(cp_pool$x1) / C1 * 100, 1),
                round(mean(cp_pool$x2) / C2 * 100, 1),
                round(sum(cp_pool$xA) / sum(cp_data$dA) * 100, 1),
                round(sum(cp_pool$xB) / sum(cp_data$dB) * 100, 1),
                sum(cp_data$dA - cp_pool$xA) + sum(cp_data$dB - cp_pool$xB))
)

kbl(kpi_df,
    col.names = c("Kennzahl", "Dezentral", "Pooling (einseitig)", "Pooling (zweiseitig)"),
    align = c("l", "r", "r", "r")) |>
  kable_styling(bootstrap_options = c("condensed", "striped"), full_width = TRUE)
```
Das Muster ist eindeutig: **Kapazitätspooling verbessert alle Servicekennzahlen gleichzeitig** — höhere Auslastung, höhere Verkaufsquote, weniger Lost Sales — und das, **ohne dass eine einzige zusätzliche Produktionseinheit an Kapazität geschaffen wurde**. Der Effekt entsteht allein dadurch, dass sich positive und negative Abweichungen der beiden Standorte von ihrer jeweiligen Kapazität teilweise gegenseitig ausgleichen: Ist Wiesbaden schwach und Mainz stark ausgelastet, kann die freie Kapazität der Küche Wiesbaden dorthin fließen, wo sie gebraucht wird. Dieser **Risikoausgleichseffekt** (engl. *risk pooling*) ist das verbindende Prinzip, das in diesem Kapitel für Kapazitäten, für Lagerbestände und schließlich formal über das Quadratwurzelgesetz behandelt wird.
Pooling ist allerdings nicht kostenlos: Es setzt **technologische Flexibilität** (Küchen müssen für mehrere Standorte produzieren und just-in-time zwischen ihnen umdisponieren können) und zusätzliche **logistische Koordination** voraus. Genau diese Kosten-Nutzen-Abwägung — verteilte, flexible Kapazität versus ein einziges, effizientes Zentralwerk — ist es letztlich auch, die für SushiFresh die Wahl zwischen einem und mehreren Produktionsstandorten prägt (Kapitel [-@sec-standort-2]). Je mehr Standorte eingebunden werden sollen, desto komplexer und teurer wird die Flexibilität, was zur Frage führt, wie Pooling bei vielen Standorten sinnvoll organisiert werden kann, ohne dass jeder Standort buchstäblich für jeden anderen einspringen kann.
### Chaining: Pooling-Nutzen ohne vollständige Flexibilität
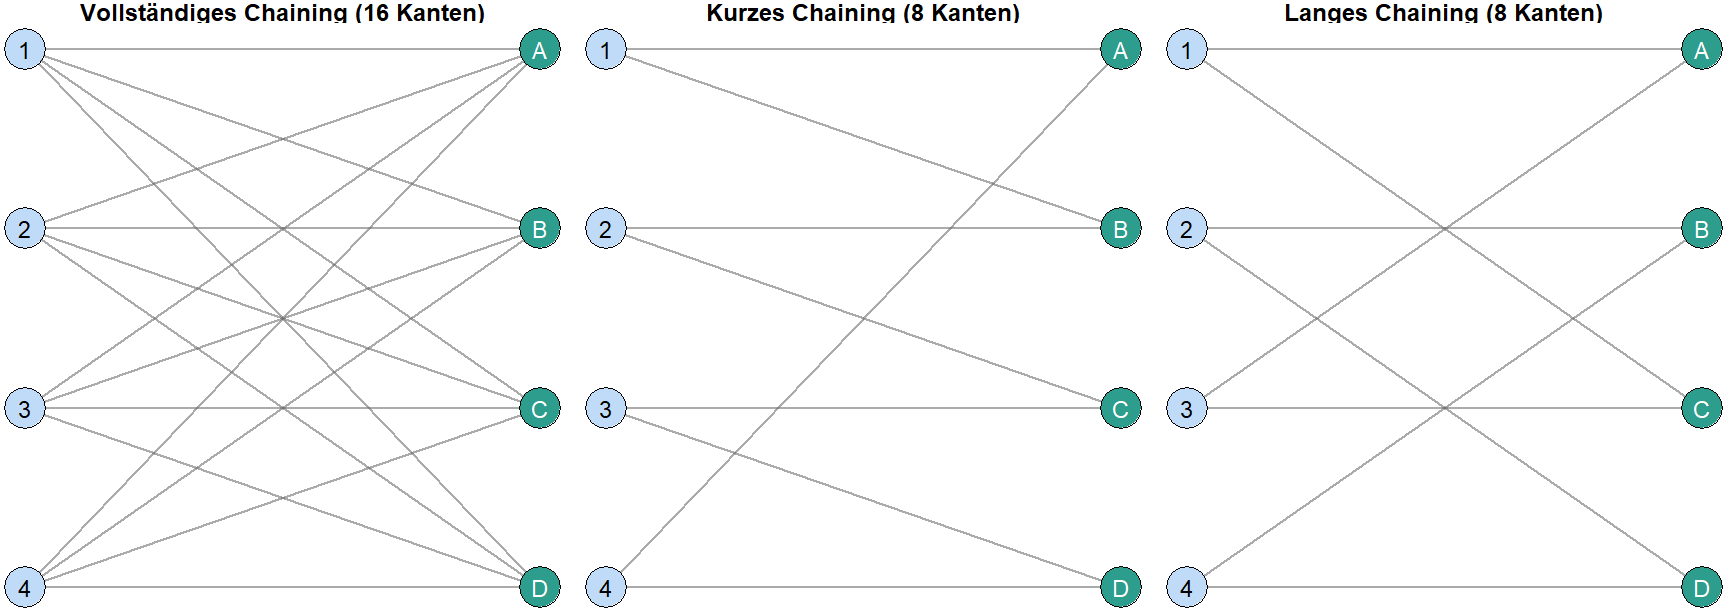
Bei $n$ Werken und $n$ Märkten wäre **vollständiges Pooling** gleichbedeutend damit, dass jedes Werk jeden Markt beliefern kann — bei vier Werken und vier Märkten also $n \times n = 16$ mögliche Werk-Markt-Verbindungen. Das ist in der Praxis meist unwirtschaftlich, weil jedes Werk in jede zusätzliche Produkttechnologie investieren müsste. Die überraschende Erkenntnis der Pooling-Theorie [vgl. @cachon2024matching, Kap. 17] lautet jedoch: **Man muss nicht vollständig poolen, um fast den vollen Nutzen zu erzielen.** Es genügt, die Werke und Märkte zu einer **Kette** (*chain*) zu verbinden, in der jedes Werk genau zwei Märkte und jeder Markt genau zwei Werke bedienen kann:
```{r}
#| label: ch6-chaining-diagram
#| fig-cap: "Drei Chaining-Strategien im Vergleich: vollständiges, kurzes und langes Chaining"
#| fig-width: 9
#| fig-height: 3.2
plants  <- tibble(id = paste0("Werk ", 1:4), lbl = as.character(1:4), x = 0, y = c(4, 3, 2, 1))
markets <- tibble(id = LETTERS[1:4], lbl = LETTERS[1:4], x = 1, y = c(4, 3, 2, 1))

# Vollstaendiges Chaining: jedes Werk mit jedem Markt verbunden (n x n Kanten)
edges_full <- expand_grid(from = plants$id, to = markets$id) |>
  mutate(chaining = "Vollständiges Chaining (16 Kanten)")

# Kurzes Chaining: jedes Werk bedient seinen "eigenen" Markt plus den direkten
# Nachbarn im Ring (2 Kanten je Werk, 2n Kanten insgesamt)
edges_short <- tibble(
  from     = rep(plants$id, 2),
  to       = c(markets$id, markets$id[c(2, 3, 4, 1)]),
  chaining = "Kurzes Chaining (8 Kanten)"
)

# Langes Chaining: wie kurzes Chaining, aber der zweite Markt ist zwei Positionen
# weiter im Ring entfernt -> mehr Marktabdeckung je Werk bei gleicher Kantenzahl
edges_long <- tibble(
  from     = rep(plants$id, 2),
  to       = c(markets$id, markets$id[c(3, 4, 1, 2)]),
  chaining = "Langes Chaining (8 Kanten)"
)

edges_all <- bind_rows(edges_full, edges_short, edges_long) |>
  left_join(plants  |> rename(x0 = x, y0 = y), by = c("from" = "id")) |>
  left_join(markets |> rename(x1 = x, y1 = y), by = c("to"   = "id")) |>
  mutate(chaining = factor(chaining, levels = c("Vollständiges Chaining (16 Kanten)",
                                                 "Kurzes Chaining (8 Kanten)",
                                                 "Langes Chaining (8 Kanten)")))

ggplot(edges_all) +
  geom_segment(aes(x = x0, y = y0, xend = x1, yend = y1),
               color = "grey40", alpha = 0.55,
               arrow = arrow(length = unit(0.12, "cm"))) +
  geom_point(data = plants,  aes(x = x, y = y), size = 7, shape = 21, fill = "#BFDBF7") +
  geom_point(data = markets, aes(x = x, y = y), size = 7, shape = 21, fill = "#2D9E8E") +
  geom_text(data = plants,  aes(x = x, y = y, label = lbl), size = 3) +
  geom_text(data = markets, aes(x = x, y = y, label = lbl), size = 3, color = "white") +
  facet_wrap(~chaining) +
  theme_void() +
  theme(strip.text = element_text(face = "bold", size = 9))
```
Beim **kurzen Chaining** bedient jedes Werk seinen eigenen Markt sowie den direkten Nachbarmarkt im Ring; beim **langen Chaining** liegt der zweite bediente Markt zwei Positionen weiter entfernt. Beide Varianten benötigen nur $2n$ statt $n^2$ Verbindungen — bei vier Werken also 8 statt 16 —, erreichen aber empirisch einen großen Teil des Pooling-Nutzens von vollständiger Flexibilität, weil ein lokaler Nachfrageüberschuss über die Kette an das nächste Werk mit freier Kapazität weitergereicht werden kann. Dieses Prinzip — als **Chaining** bekannt geworden durch die Praxis der General-Motors-Werksallokation — ist ein Beispiel dafür, dass der Grenznutzen von zusätzlicher Flexibilität **stark abnimmt**: Die ersten paar zusätzlichen Verbindungen bringen den größten Teil des Pooling-Effekts, vollständige Flexibilität bringt nur noch einen kleinen zusätzlichen Zugewinn bei stark steigenden Kosten.
Für ein Unternehmen wie SushiFresh mit sechs Filialen wäre Chaining eine denkbare Zwischenlösung gewesen — etwa mehrere kleinere Regionalküchen, von denen jede zwei benachbarte Filialen beliefern kann. Wenn sich das Unternehmen stattdessen für die volle Zentralisierung auf einen einzigen Standort entscheidet, ist das keine Widerlegung des Chaining-Prinzips, sondern das Ergebnis einer konkreten Kosten-Nutzen-Abwägung: Bei kurzen Distanzen im Rhein-Main-Gebiet und relativ geringen Zusatzkosten für Zentrallogistik überwiegt der volle Pooling-Nutzen die Konsolidierungskosten. Für weiter verteilte Netzwerke oder bei hohen Transportkosten fällt diese Abwägung oft anders aus — dann ist eine partielle Flexibilisierung wie Chaining die wirtschaftlichere Wahl. Der (abnehmende) Grenznutzen zusätzlicher Verbindungen muss dabei stets den (meist linear oder sogar progressiv steigenden) Grenzkosten zusätzlicher Umrüstfähigkeit gegenübergestellt werden — eine klassische Kosten-Nutzen-Abwägung, wie sie bereits aus der Diskussion der Zielkonflikte in Kapitel [-@sec-logistikkosten] bekannt ist.
## Sicherheitsbestände: Bestellpunktverfahren und Servicegrad
Pooling wirkt nicht nur zwischen parallelen Standorten, sondern auch **über die Zeit**: Sicherheitsbestände gleichen Nachfrageschwankungen innerhalb einer Wiederbeschaffungszeit aus. Bevor der Pooling-Effekt bei Lagerbeständen behandelt wird, muss zunächst geklärt werden, wie ein Sicherheitsbestand überhaupt bemessen wird.
### Das Bestellpunktverfahren (t, S)-Politik
Ein verbreitetes Verfahren zur Bestandssteuerung ist die **periodische Bestellpunktpolitik** — auch $(t, S)$-Politik genannt: In festen Zeitabständen $t$ wird der aktuelle **disponible Bestand** (physischer Bestand plus bereits offene, aber noch nicht eingetroffene Bestellungen, minus Fehlmengen) auf ein fixes **Zielniveau** $S$ (*order-up-to level*) aufgefüllt. Zwischen Bestellung und Wareneingang vergeht dabei stets die **Wiederbeschaffungszeit** $wbz$. Der **Sicherheitsbestand** $sb$ ergibt sich als Differenz zwischen diesem Zielniveau und dem erwarteten Bedarf während der *Risikoperiode* (Bestellintervall plus Wiederbeschaffungszeit):
$$
sb = S - \mu \cdot (t + wbz)
$$
wobei $\mu$ die erwartete Nachfrage pro Periode ist. Je höher $S$ über diesem erwarteten Bedarf liegt, desto größer der Puffer gegen positive Nachfrageausschläge — aber desto höher auch die Kapitalbindung. Tritt innerhalb der Risikoperiode tatsächlich mehr Nachfrage auf, als der verfügbare Bestand deckt, entsteht eine **Fehlmenge**: Je nachdem, wie das Unternehmen damit umgeht, wird zwischen **Backorders** (die Nachfrage wird verzögert, aber vollständig nachgeliefert, sobald wieder Bestand verfügbar ist) und **Lost Sales** (nicht gedeckte Nachfrage geht unwiederbringlich verloren) unterschieden. Beide Fälle unterscheiden sich in der Fortschreibung des Nettobestands: Bei Backordering darf der Nettobestand vorübergehend negativ werden, bei Lost Sales bleibt er nach unten bei Null begrenzt.
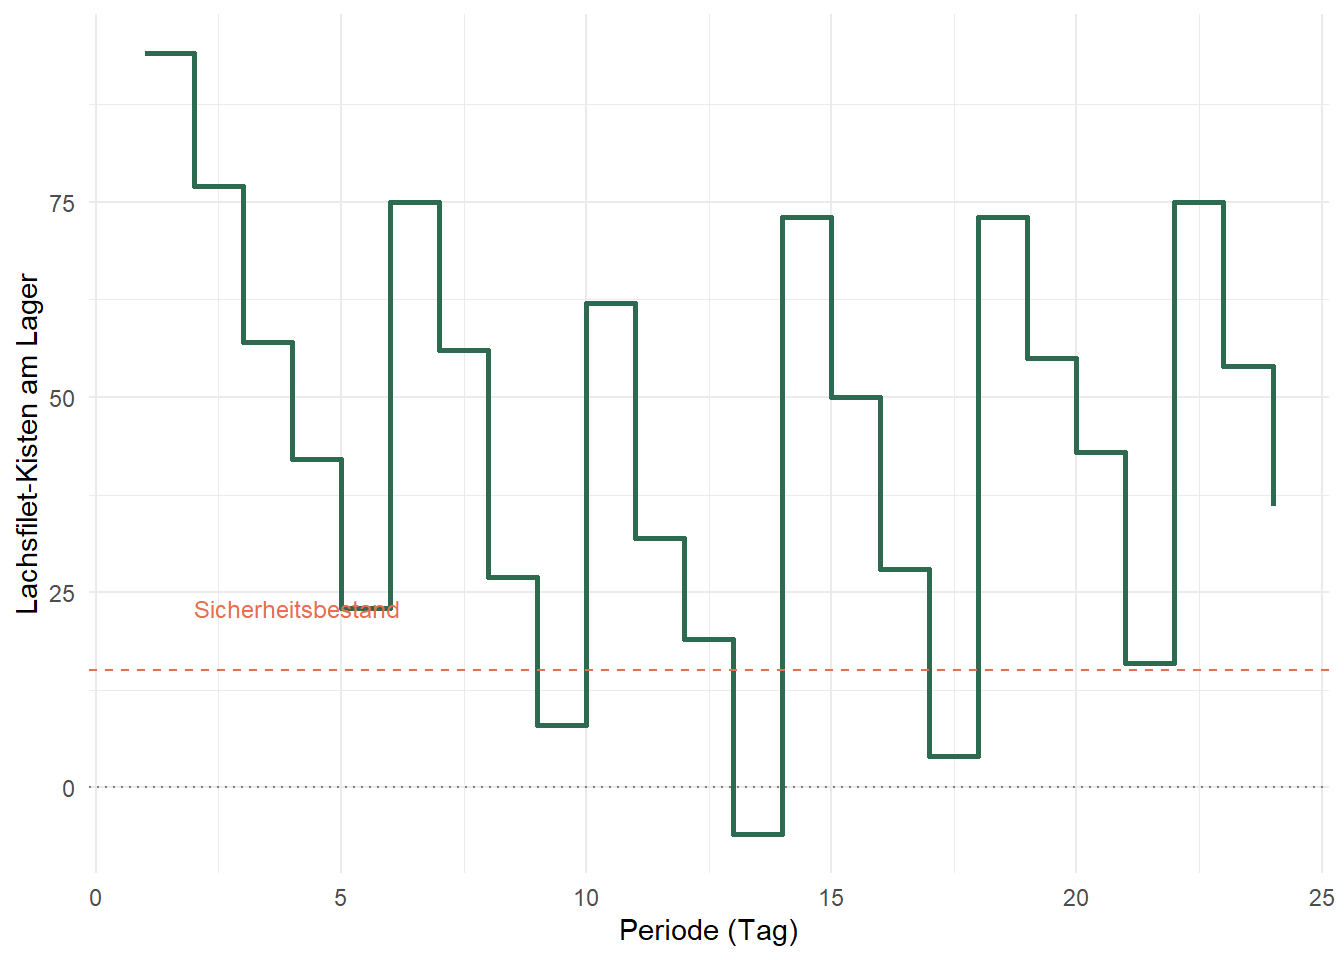
Bei SushiFresh betrifft dieses Verfahren nicht die fertigen Sushi-Boxen selbst (die sind, wie erwähnt, kaum lagerfähig), sondern die **Rohwarenbeschaffung** an der Zentralküche in Raunheim: Frisches Lachsfilet wird nicht täglich, sondern periodisch bei einem Fischgroßhändler bestellt und kurzfristig auf Kühlung vorgehalten. Die Simulationsfunktionen `simuliere_tS()` und `tS.lager()` in `R/scm_functions.R` bilden genau diese Logik nach: Sie schreiben periodenweise Bedarf, Bestellungen, Lieferungen und resultierenden Bestand fort und unterscheiden dabei explizit zwischen physischem Bestand, Nettobestand und disponiblem Bestand (physischer Bestand zuzüglich bereits offener, aber noch nicht eingetroffener Bestellungen). Wie diese Fortschreibung im Detail funktioniert, muss hier nicht nachgebaut werden — wichtig ist, das **Ergebnis** interpretieren zu können:
```{r}
#| label: ch6-ts-lager-sim
#| fig-cap: "Simulierter Lachsfilet-Bestandsverlauf an der Zentralküche Raunheim unter (t, S)-Politik"
set.seed(42)                      # reproduzierbare Nachfrageziehung
n     <- 24                       # Simulationshorizont (Perioden = Tage)
lam   <- 20                       # mittlerer Tagesverbrauch an Lachsfilet-Kisten (Poisson-verteilt)
t     <- 4                        # Bestellintervall beim Fischgroßhändler (Tage)
S     <- 135                      # Order-up-to-Level (Kisten)
wbz   <- 2                        # Wiederbeschaffungszeit (Tage)
l.ini <- 120                      # Anfangsbestand (Kisten)

sb <- S - (t + wbz) * lam         # Sicherheitsbestand nach obiger Formel
sb
# Periodenbedarfe ziehen (Poisson passt gut zu diskreten Kisten-Stückzahlen)
verbrauch <- rpois(n, lambda = lam)

# Fertige Simulationsfunktion aus scm_functions.R anwenden
res <- tS.lager(d = verbrauch, t = t, S = S, l.ini = l.ini, wbz = wbz) |>
  as_tibble() |>
  mutate(Periode = row_number())

ggplot(res, aes(x = Periode, y = Lagerbestand)) +
  geom_step(color = "#2D6A4F", linewidth = 0.9) +
  geom_hline(yintercept = sb, linetype = "dashed", color = "#E76F51") +
  geom_hline(yintercept = 0, linetype = "dotted", color = "grey50") +
  annotate("text", x = 2, y = sb + 8, label = "Sicherheitsbestand", color = "#E76F51",
           hjust = 0, size = 3.2) +
  labs(x = "Periode (Tag)", y = "Lachsfilet-Kisten am Lager") +
  theme_minimal()
# Minimaler Bestand über den Simulationshorizont
min(res$Lagerbestand)
```
In dieser Simulation fällt der Lachsfilet-Bestand in Periode 13 kurzzeitig unter Null — es kommt trotz eines rechnerischen Sicherheitsbestands von 15 Kisten zu einer **Fehlmenge**, weil der tatsächlich gezogene Verbrauch in mehreren aufeinanderfolgenden Tagen über dem Mittelwert lag. Das illustriert bereits den zentralen Punkt: Ein Sicherheitsbestand, der auf dem *Erwartungswert* basiert, schützt **nicht garantiert**, sondern nur **mit einer bestimmten Wahrscheinlichkeit** vor Fehlmengen. Diese Wahrscheinlichkeit muss explizit gewählt werden — das führt zum Konzept des Servicegrads.
::: {.vertiefung}
**Theorie-Vertiefung: Normalverteilung, z-Transformation und Quantile**
Viele Formeln dieses und der folgenden Kapitel beruhen auf der Normalverteilung. Ihre **Dichtefunktion** $f(x) = \frac{1}{\sigma\sqrt{2\pi}} \exp\!\left(-\frac{(x-\mu)^2}{2\sigma^2}\right)$ beschreibt, wie sich die Wahrscheinlichkeitsmasse um den Mittelwert $\mu$ verteilt; die **Verteilungsfunktion** $F(x) = P(X \leq x) = \int_{-\infty}^x f(t)\,dt$ gibt die kumulierte Wahrscheinlichkeit an. Für die Praxis sind drei Eigenschaften zentral:
1. **68–95–99,7-Regel:** Im Intervall $\mu \pm \sigma$ liegen rund 68,3 %, in $\mu \pm 2\sigma$ rund 95,4 % und in $\mu \pm 3\sigma$ rund 99,7 % der Wahrscheinlichkeitsmasse.
2. **z-Transformation:** Jede normalverteilte Zufallsvariable $X \sim \mathcal{N}(\mu,\sigma^2)$ lässt sich über $Z = (X-\mu)/\sigma$ in die **Standardnormalverteilung** $\mathcal{N}(0,1)$ überführen. Es gilt $P(X \leq x) = \Phi\big((x-\mu)/\sigma\big)$, wobei $\Phi$ die Verteilungsfunktion der Standardnormalverteilung ist. Deshalb genügt eine einzige Tabelle (oder die R-Funktion `pnorm()`) für alle Normalverteilungen.
3. **Symmetrie:** $\Phi(-z) = 1 - \Phi(z)$; eine Tabelle für $z \geq 0$ reicht daher aus.
Die Umkehrung liefert das **Quantil** $z_\alpha = \Phi^{-1}(\alpha)$ (in R: `qnorm(alpha)`): den Wert, der mit Wahrscheinlichkeit $\alpha$ nicht überschritten wird. Aus $P(D \leq S) = \alpha$ folgt $S = \mu + z_\alpha\,\sigma$ und damit der Sicherheitsbestand $sb = z_\alpha \cdot \sigma$. Die wichtigsten Werte:
```{r}
#| label: ch6-z-tabelle
tibble(Servicegrad = c(0.90, 0.95, 0.975, 0.99, 0.999),
       z_alpha = round(qnorm(Servicegrad), 3))
```
Beispiel aus der Vorlesung: Bei $D \sim \mathcal{N}(500, 80^2)$ und $\alpha = 95\,\%$ ergibt sich $sb = 1{,}645 \cdot 80 \approx 132$ Stück. Anschaulich: Wer seinen Servicegrad von 95 % auf 99 % erhöhen will, muss den Sicherheitsbestand um den Faktor $2{,}326/1{,}645 \approx 1{,}41$ steigern – die letzten Prozentpunkte Lieferbereitschaft sind wegen der dünnen Verteilungsränder besonders teuer.
:::
### Der $\alpha$-Servicegrad und die empirische Verteilungsfunktion
Der **$\alpha$-Servicegrad** (auch *Lieferbereitschaftsgrad*) ist definiert als die Wahrscheinlichkeit, während der Risikoperiode **keine** Fehlmenge zu erleiden:
$$
\alpha = P(D \leq S)
$$
Dabei ist $D$ die (zufällige) Nachfrage während der Risikoperiode und $S$ der verfügbare Bestand zu deren Beginn. Der $\alpha$-Servicegrad ist eine **Ereigniswahrscheinlichkeit**: Er beantwortet die Frage "Wie oft, über viele Risikoperioden hinweg, tritt überhaupt keine Fehlmenge auf?" — unabhängig davon, wie groß eine Fehlmenge im Fehlerfall ausfällt. Daneben wird in der Praxis häufig auch der **$\beta$-Servicegrad** (*Versorgungsgrad*) verwendet, der stattdessen den **mengenmäßigen** Anteil der Nachfrage misst, der direkt aus dem Bestand bedient werden kann: $\beta = 1 - E[\text{Fehlmenge}]/E[\text{Nachfrage}]$. Ein hoher $\alpha$-Servicegrad schließt seltene, aber dafür große Fehlmengen nicht aus — für die meisten operativen Zwecke ist $\alpha$ dennoch die gebräuchlichere und leichter zu kommunizierende Kennzahl, weshalb sie im Folgenden im Mittelpunkt steht. Ist die Verteilung von $D$ unbekannt, lässt sich $\alpha$ direkt aus historischen Beobachtungen schätzen — über die **empirische Verteilungsfunktion**.
::: {.r-exkurs}
**R-Exkurs: Die empirische Verteilungsfunktion mit `ecdf()`**
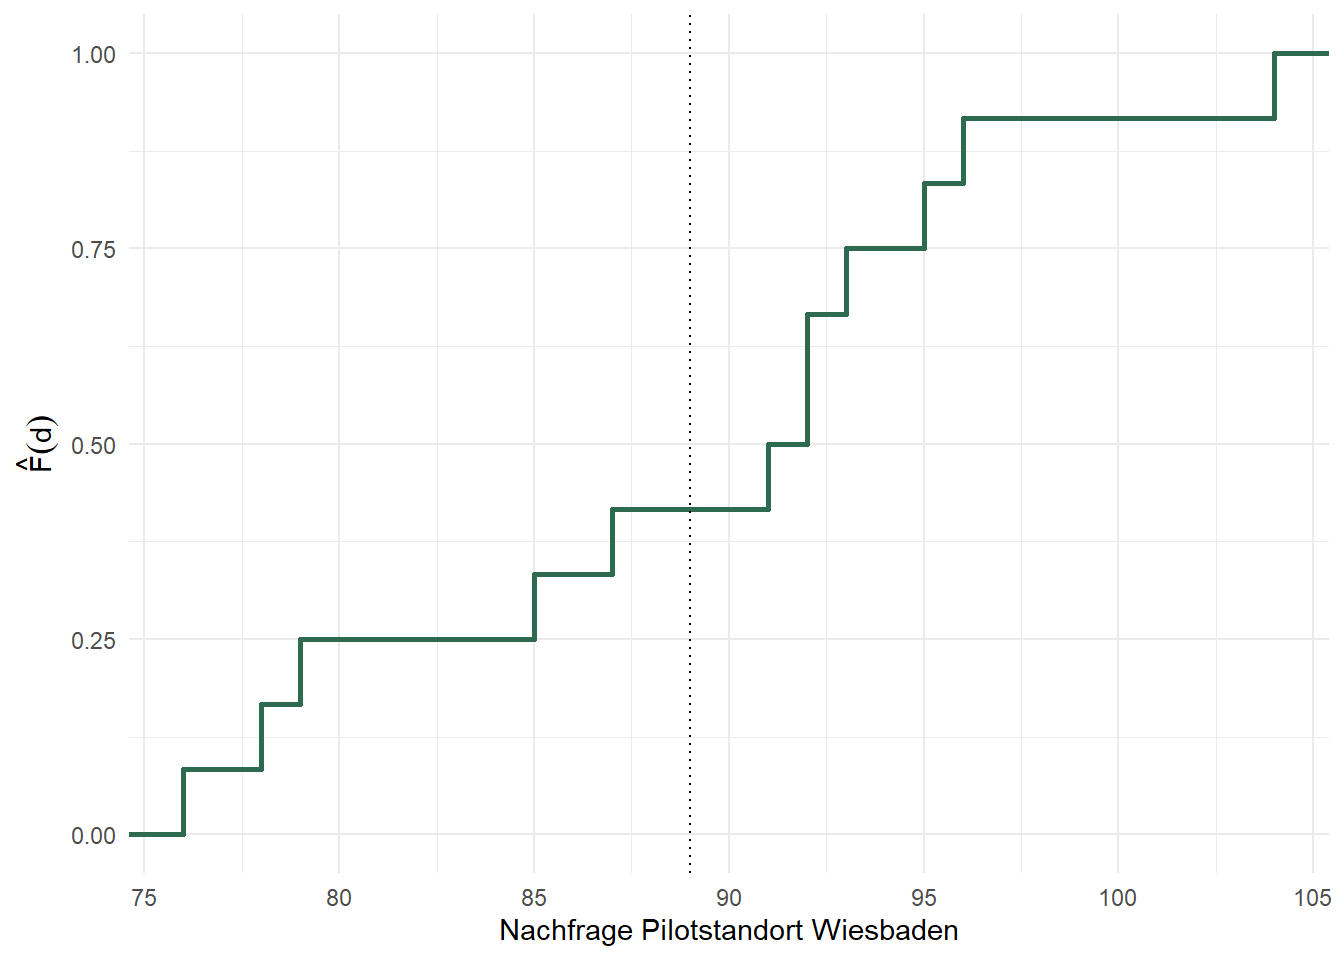
Für eine Stichprobe $x_1, \dots, x_n$ gibt die empirische Verteilungsfunktion (*empirical cumulative distribution function*, ECDF) an, welcher **Anteil** der Beobachtungen kleiner oder gleich einem Wert $x$ ist:
$$
\hat{F}(x) = \frac{1}{n}\sum_{i=1}^{n} \mathbb{1}(x_i \leq x)
$$
In R liefert `ecdf(x)` diese Funktion nicht als Tabelle, sondern als **aufrufbares R-Objekt** — man kann sie also wie eine Funktion an beliebigen Stellen auswerten:
```{r}
#| label: ch6-ecdf-demo
#| fig-cap: "Empirische Verteilungsfunktion der Nachfrage am Pilotstandort Wiesbaden"
F_A <- ecdf(cp_data$dA)      # ECDF-Objekt aus den 12 Pilot-Monatswerten Wiesbaden

# F_A ist aufrufbar wie jede andere Funktion:
F_A(90)                      # Anteil der Monate mit Nachfrage <= 90
ggplot(cp_data, aes(x = dA)) +
  stat_ecdf(geom = "step", color = "#2D6A4F", linewidth = 0.9) +
  geom_vline(xintercept = mean(cp_data$dA), linetype = "dotted") +
  labs(x = "Nachfrage Pilotstandort Wiesbaden", y = expression(hat(F)(d))) +
  theme_minimal()
```
Die Umkehrung — "welcher Wert wird mit Wahrscheinlichkeit $\alpha$ nicht überschritten?" — liefert `quantile(x, probs = alpha)`. Damit lässt sich der zu einem gewünschten Servicegrad passende Bestand **direkt aus den Daten** ablesen, ganz ohne Verteilungsannahme.
:::
Formal gilt: Gesucht ist der kleinste Bestand $S$, für den $\hat{F}(S) \geq \alpha$ — also das empirische $\alpha$-Quantil $S = \hat{F}^{-1}(\alpha)$. Für die Nachfragedaten des Pilotstandorts Wiesbaden ergibt sich:
```{r}
#| label: ch6-alpha-quantile
alpha_niveaus <- c(0.75, 0.90, 0.95)

sb_tabelle <- tibble(
  alpha = alpha_niveaus,
  # empirisches Quantil je Servicegrad-Niveau (Typ 1: "nächstgrößere Beobachtung")
  S     = map_dbl(alpha_niveaus, ~ quantile(cp_data$dA, probs = .x, type = 1))
) |>
  mutate(sb = S - mean(cp_data$dA))   # Sicherheitsbestand = Quantil minus Mittelwert

sb_tabelle
```
Ein Servicegrad von 75 % erfordert also nur 4 Boxen Sicherheitsbestand, während ein Servicegrad von 95 % bereits 15 Boxen verlangt. Dieser stark **überproportionale** Zusammenhang — die letzten Prozentpunkte Servicegrad sind überproportional teuer — ist eine direkte Folge der Form der Nachfrageverteilung und wird uns in ähnlicher Form beim Newsvendor-Modell in @sec-newsvendor wiederbegegnen (dort erneut am Beispiel der Filiale Frankfurt).
## Lagerbestandspooling: Risikoausgleich über Standorte hinweg
### Dezentrale vs. zentrale Lagerhaltung
Die entscheidende Frage lautet nun: Was passiert mit dem benötigten Sicherheitsbestand, wenn die beiden Pilotstandorte Wiesbaden und Mainz **nicht** von getrennten Küchen, sondern von einem **gemeinsamen Zentralwerk** aus beliefert werden? Im dezentralen Fall muss jeder Standort seinen eigenen Sicherheitsbestand vorhalten — in Summe also $sb_{Wiesbaden} + sb_{Mainz}$. Im zentralen Fall genügt ein Sicherheitsbestand für die **aggregierte** Nachfrage $D_0 = D_{Wiesbaden} + D_{Mainz}$:
```{r}
#| label: ch6-pooling-ecdf-vergleich
alpha <- 0.95

# Dezentral: Sicherheitsbestand je Standort, dann aufsummiert
S_A <- quantile(cp_data$dA, alpha, type = 1);  sb_A <- S_A - mean(cp_data$dA)
S_B <- quantile(cp_data$dB, alpha, type = 1);  sb_B <- S_B - mean(cp_data$dB)
sb_dezentral <- sb_A + sb_B

# Zentral: ein Sicherheitsbestand fuer die Summennachfrage Wiesbaden + Mainz
dTotal <- cp_data$dA + cp_data$dB
S_T    <- quantile(dTotal, alpha, type = 1)
sb_zentral <- S_T - mean(dTotal)

tibble(Konfiguration = c("Dezentral (Wiesbaden + Mainz getrennt)", "Zentral (gepoolt)"),
       Sicherheitsbestand = c(sb_dezentral, sb_zentral),
       Einsparung_Prozent = c(0, round((1 - sb_zentral / sb_dezentral) * 100, 1)))
```
Allein durch die Zusammenlegung der beiden Pilotküchen sinkt der benötigte Sicherheitsbestand um rund 18 % — bei **identischer** Ausfallwahrscheinlichkeit von 5 %. Dieser Effekt beruht nicht auf zusätzlicher Information oder besserer Prognose, sondern rein auf einem statistischen Prinzip: Zufällige Abweichungen einzelner Standorte von ihrem Mittelwert gleichen sich in der **Summe** teilweise aus, solange die Nachfragen nicht perfekt positiv korreliert sind.
### Formale Herleitung bei normalverteilter Nachfrage
Um diesen Effekt algebraisch zu fassen, seien die Nachfragen zweier Standorte normalverteilt: $D_1 \sim \mathcal{N}(\mu_1, \sigma_1^2)$ und $D_2 \sim \mathcal{N}(\mu_2, \sigma_2^2)$, mit Korrelation $\rho = \text{Cor}(D_1, D_2)$. Der Sicherheitsbestand am dezentralen Standort $i$ beträgt bei Servicegrad $\alpha$ jeweils $sb_i = z_\alpha \cdot \sigma_i$ (mit $z_\alpha = \Phi^{-1}(\alpha) =$ `qnorm(alpha)`), in Summe also:
$$
sb_{dez} = z_\alpha \cdot (\sigma_1 + \sigma_2)
$$
Für die Summe zweier (gemeinsam) normalverteilter Zufallsvariablen gilt ein Satz aus der Wahrscheinlichkeitsrechnung: Die Summe ist wieder normalverteilt, mit einer Varianz, die auch die Kovarianz zwischen $D_1$ und $D_2$ berücksichtigt:
$$
D_0 = D_1 + D_2 \sim \mathcal{N}\!\left(\mu_1 + \mu_2,\; \sigma_1^2 + \sigma_2^2 + 2\rho\,\sigma_1\sigma_2\right)
$$
Der zentrale Sicherheitsbestand ergibt sich damit als:
$$
sb_{zen} = z_\alpha \cdot \sqrt{\sigma_1^2 + \sigma_2^2 + 2\rho\,\sigma_1\sigma_2}
$$
Der entscheidende Vergleich ist $sb_{zen}$ gegen $sb_{dez}$ in Abhängigkeit von $\rho$. Drei Grenzfälle verdeutlichen die Bandbreite:
| Korrelation | Zentraler Sicherheitsbestand |
|:---:|:---|
| $\rho = -1$ (perfekt gegenläufig) | $z_\alpha \cdot \lvert \sigma_1 - \sigma_2 \rvert$ |
| $\rho = 0$ (unkorreliert) | $z_\alpha \cdot \sqrt{\sigma_1^2 + \sigma_2^2}$ |
| $\rho = +1$ (perfekt gleichläufig) | $z_\alpha \cdot (\sigma_1 + \sigma_2) = sb_{dez}$ |
Da für nichtnegative $\sigma_1, \sigma_2$ stets $\lvert \sigma_1 - \sigma_2\rvert \leq \sqrt{\sigma_1^2+\sigma_2^2} \leq \sigma_1+\sigma_2$ gilt, folgt: **Pooling lohnt sich immer, solange $\rho < 1$ ist — und der Nutzen ist umso größer, je negativer die Korrelation.** Nur wenn beide Standorte exakt gleichläufig schwanken ($\rho = +1$), bringt Pooling keinerlei Vorteil, weil sich dann kein Ausgleich einstellen kann.
Diese Formel lässt sich unmittelbar auf mehr als zwei Standorte verallgemeinern: Für $n$ Standorte mit individuellen $\sigma_i$ und (für den Unabhängigkeitsfall) $\rho_{ij} = 0$ für alle $i \neq j$ gilt einfach $sb_{zen} = z_\alpha \cdot \sqrt{\sum_i \sigma_i^2}$. Genau diese Verallgemeinerung ist es, die im nächsten Abschnitt auf das **Kerngeschäft von SushiFresh** — die sechs realen Filialen — angewendet wird.
### Anwendung: Der Sicherheitsbestand für die sechs SushiFresh-Filialen
Bei einer Konsolidierung, wie sie Kapitel [-@sec-standort-2] nahelegt, werden nicht mehr nur zwei Pilotstandorte, sondern alle **sechs Filialen** von einer einzigen Zentralküche in Raunheim aus versorgt. Für jede Filiale ist die tägliche Nachfrage näherungsweise normalverteilt, mit folgenden (aus den Verkaufsdaten geschätzten) Parametern:
```{r}
#| label: ch6-sushifresh-filialen
filialen <- tibble(
  Filiale = c("Wiesbaden", "Mainz", "Frankfurt", "Rüsselsheim", "Darmstadt", "Offenbach"),
  mu      = c(120, 150, 280, 90, 110, 95),
  sigma   = c(25, 30, 55, 20, 24, 22)
)

filialen |>
  summarise(Filialen = n(), Gesamtnachfrage = sum(mu), Summe_Sigma = sum(sigma))
```
Frankfurt ist dabei mit Abstand die größte **und** volatilste Filiale — mit $\mu = 280$ und $\sigma = 55$ steht sie für knapp ein Drittel der Gesamtnachfrage, aber für fast ein Drittel der gesamten Streuung. Die zentrale Frage lautet nun: Wie hoch ist der Sicherheitsbestand in einer Zentralküche bei einem angestrebten Servicegrad von $\alpha = 95\,\%$ — verglichen mit dem hypothetischen Fall, dass jede Filiale weiterhin eigenständig disponieren würde? Unter der (vorerst vereinfachenden) Annahme unabhängiger Filialnachfragen ($\rho_{ij} = 0$) lässt sich das direkt mit `qnorm()` berechnen:
```{r}
#| label: ch6-sushifresh-kernergebnis
alpha  <- 0.95
z_a    <- qnorm(alpha)          # kritischer z-Wert, mit qnorm() verifiziert
z_a
# Dezentral: Summe der einzelnen Sicherheitsbestaende
sb_dezentral_sf <- z_a * sum(filialen$sigma)
sb_dezentral_sf
# Zentral (gepoolt, Unabhaengigkeitsannahme): Wurzel aus der Summe der Varianzen
sigma_gepoolt <- sqrt(sum(filialen$sigma^2))
sigma_gepoolt
sb_zentral_sf <- z_a * sigma_gepoolt
sb_zentral_sf
# Relative Einsparung durch die Zentralisierung
einsparung_sf <- (1 - sb_zentral_sf / sb_dezentral_sf) * 100
round(c(dezentral = sb_dezentral_sf, zentral = sb_zentral_sf, einsparung_pct = einsparung_sf), 1)
```
Das Ergebnis ist eindeutig: Müsste jede Filiale ihren eigenen Sicherheitsbestand vorhalten, wären dafür **289,5 Boxen** nötig. In einer gemeinsamen Zentralküche genügen dagegen **127,5 Boxen**, um denselben 95-%-Servicegrad zu erreichen — eine **Reduktion um 56,0 %**. Als Gegenprobe zur eigenhändig hergeleiteten Formel dient die generische, gleichlautende Funktion `pooling_safety_stock()` aus `R/scm_functions.R` — allerdings mit einer wichtigen Einschränkung: Sie unterstellt $n$ **identische** Standorte mit gemeinsamem $\sigma$, während die SushiFresh-Filialen unterschiedlich groß und unterschiedlich volatil sind. Als Näherungs-Gegenprobe lässt sich daher prüfen, welchen zentralen Sicherheitsbestand die Funktion für $n = 6$ Standorte mit der **durchschnittlichen** Streuung liefern würde:
```{r}
#| label: ch6-sushifresh-gegenprobe
sigma_mean <- mean(filialen$sigma)   # 176 / 6 = 29,33 -- "durchschnittliche" Filiale
sigma_mean
# Idealisierter Vergleichsfall: 6 identische Filialen mit sigma = sigma_mean
ideal_fall <- pooling_safety_stock(n = 6, sigma = sigma_mean, z = z_a)
ideal_fall
```
Der idealisierte Vergleichsfall (sechs **identische** Filialen mit $\sigma = 29{,}33$) liefert eine Einsparung von `r round((1 - qnorm(0.95)*sqrt(6)*mean(c(25,30,55,20,24,22)) / (qnorm(0.95)*6*mean(c(25,30,55,20,24,22))))*100,1)` % — bemerkenswerterweise **mehr** als die tatsächlich berechneten 56,0 % für die echten, heterogenen SushiFresh-Filialen. Das mag zunächst überraschen, folgt aber direkt aus einer mathematischen Eigenschaft: Für eine **fest vorgegebene Summe** $\sum_i \sigma_i$ wird die Summe der Quadrate $\sum_i \sigma_i^2$ **minimal**, wenn alle $\sigma_i$ gleich groß sind (das ist eine direkte Konsequenz der Ungleichung vom quadratischen und arithmetischen Mittel). Jede Abweichung von dieser Gleichverteilung — wie die dominante, überdurchschnittlich volatile Filiale Frankfurt mit $\sigma = 55$ — **vergrößert** $\sum_i \sigma_i^2$ gegenüber dem idealisierten Fall und damit auch den gepoolten Sicherheitsbestand $\sigma_{zen}$. Der Pooling-**Nutzen** ist also am größten, wenn viele **ähnlich große** Standorte gepoolt werden; ein einzelner, dominanter Ausreißer-Standort wie Frankfurt "verdünnt" den relativen Diversifikationsvorteil, weil er das Gesamtrisiko weniger gleichmäßig auf die sechs Standorte verteilt, als es die Idealannahme unterstellt. Diese Erkenntnis ist für die Standortplanung wichtig: Ein Netzwerk aus **vielen ähnlich großen** Filialen profitiert relativ stärker vom Pooling als ein Netzwerk mit einem dominanten Großstandort.
::: {.callout-note}
Die beiden Zahlen 289,5 und 127,5 Boxen sind der Sicherheitsbestand **zusätzlich** zur erwarteten Nachfrage von 845 Boxen/Tag (siehe Filialtabelle weiter oben). Sie beziffern damit exakt den Effekt, den eine Zentralisierung auf die Kapitalbindung im Sicherheitsbestand hat — unabhängig von den (in Kapitel [-@sec-standort-1] und [-@sec-standort-2] behandelten) Standort- und Transportkosten.
:::
::: {.fallstudie}
**Fallstudie: Was ist die Pooling-Einsparung für SushiFresh wert?**
Kapitel [-@sec-standort-2] hatte gezeigt, dass die Kostenunterschiede zwischen einer Zentralküche in Raunheim und einer Zweistandortlösung (Raunheim + Wiesbaden-Erbenheim) im Zahlenbeispiel nur rund 7.000 € pro Jahr betragen. Lässt sich der Pooling-Effekt in dieselbe Währung übersetzen? Bei Frischware bedeutet "Sicherheitsbestand" nichts anderes als **bewusste Mehrproduktion**, von der am Abend ein Teil unverkauft bleibt. Die erwartete Restmenge bei einer Produktionsmenge $q = \mu + z\,\sigma$ lässt sich mit der Normalverlustfunktion aus Kapitel [-@sec-newsvendor] berechnen: $E[(q-D)^+] = \sigma \cdot \big(\varphi(z) + z\,\Phi(z)\big)$. Mit den Überdeckungskosten von 3 € je unverkaufter Box (Kapitel [-@sec-newsvendor]) ergibt sich:
```{r}
#| label: ch6-pooling-wert
z   <- qnorm(0.95)
L_minus <- dnorm(z) + z * pnorm(z)          # E[(q-D)^+] / sigma bei q = mu + z*sigma
c_o <- 3                                    # EUR je unverkaufter Box

rest_dezentral <- sum(filialen$sigma) * L_minus     # Summe ueber sechs Filialen
rest_zentral   <- sigma_gepoolt * L_minus           # eine gepoolte Nachfrage

tibble(
  Variante = c("Dezentral (jede Filiale einzeln)", "Zentral (gepoolt)"),
  Restmenge_Boxen_pro_Tag = round(c(rest_dezentral, rest_zentral), 1),
  Kosten_EUR_pro_Jahr     = round(c(rest_dezentral, rest_zentral) * c_o * 365)
)
```
Die Differenz liegt bei weit über hunderttausend Euro pro Jahr und übersteigt die 7.000 € Kostenunterschied aus dem Standortmodell um ein Vielfaches. Bereits wenige eingesparte unverkaufte Boxen pro Tag (7.000 € / 365 Tage / 3 € ≈ 6–7 Boxen) würden genügen, um die Zentralisierung zu rechtfertigen. Eine wichtige Einschränkung gilt allerdings: Der volle Effekt entsteht nur, wenn die Zentralküche die Boxen erst **nach** Beobachtung der Filialnachfrage auf die Filialen verteilen kann – etwa durch eine zweite Tour am Mittag, auf der Ware nachgeliefert wird. Werden dagegen alle Boxen morgens fest auf die Filialen verteilt, müssen die Filialen jeweils einzeln abgesichert werden, und der Pooling-Effekt reduziert sich auf die vorgelagerten Rohwaren (Fisch, Reis), die in der Zentralküche gemeinsam disponiert werden. Die Organisation der Distribution entscheidet also darüber, wie viel vom theoretischen Pooling-Nutzen tatsächlich realisiert wird – ein gutes Beispiel für das Zusammenspiel von strategischer Standortwahl und operativer Steuerung.
:::
### Korrelationseffekte: Wenn Filialen nicht unabhängig sind
Die bisherige Rechnung unterstellt **unabhängige** Filialnachfragen. In der Praxis ist das selten exakt erfüllt: Geografisch benachbarte Filialen teilen sich häufig **gemeinsame Nachfragetreiber** — etwa dasselbe Wetter, denselben Feiertagskalender oder regionale Events. Wiesbaden und Mainz etwa liegen nur durch den Rhein getrennt; Frankfurt und Offenbach grenzen direkt aneinander. Wie stark schwächt eine solche **positive Korrelation** den Pooling-Effekt ab?
::: {.r-exkurs}
**R-Exkurs: Einfache Monte-Carlo-Simulation mit `replicate()`**
Eine **Monte-Carlo-Simulation** beantwortet eine analytisch mühsame oder unbekannte Frage, indem sie das zugrunde liegende Zufallsexperiment **sehr oft wiederholt** und die interessierende Kennzahl über alle Wiederholungen mittelt. In R übernimmt `replicate(n, ausdruck)` dabei die Wiederholungsschleife: Es wertet `ausdruck` `n`-mal aus und sammelt die Ergebnisse — eine kompaktere Alternative zu einer expliziten `for`-Schleife mit manueller Ergebnisspeicherung.
Zunächst wird eine Hilfsfunktion gebraucht, die zwei **korrelierte** normalverteilte Nachfragen erzeugt. Der Standardtrick dazu: Aus zwei *unabhängigen* Standardnormalvariablen $z_1, z_2$ lässt sich eine mit $z_1$ korrelierte Variable $z_1' = \rho\, z_1 + \sqrt{1-\rho^2}\, z_2$ konstruieren — deren Korrelation mit $z_1$ ist exakt $\rho$.
```{r}
#| label: ch6-monte-carlo-korrelation
# Erzeugt n Perioden mit korrelierter Nachfrage an zwei Standorten
simuliere_pooled_demand <- function(n, mu1, mu2, sigma1, sigma2, rho) {
  z1 <- rnorm(n)                             # unabhaengige Standardnormalvariable
  z2 <- rho * z1 + sqrt(1 - rho^2) * rnorm(n)  # mit z1 korrelierte Variable (Korrelation = rho)
  tibble(
    d1 = mu1 + sigma1 * z1,
    d2 = mu2 + sigma2 * z2,
    d0 = d1 + d2                             # gepoolte (zentrale) Nachfrage
  )
}

set.seed(2026)

# Monte-Carlo-Simulation: Wiesbaden und Mainz, geografische Nachbarn mit
# angenommener Korrelation rho = 0.3 (z.B. gemeinsames Wetter/Feiertage).
# 1000-mal je 30 Tage simulieren, jeweils den empirischen Sicherheitsbestand
# der GEPOOLTEN Nachfrage bei alpha = 95% bestimmen
sb_mc <- replicate(1000, {
  sim <- simuliere_pooled_demand(n = 30, mu1 = 120, mu2 = 150,
                                  sigma1 = 25, sigma2 = 30, rho = 0.3)
  quantile(sim$d0, 0.95) - mean(sim$d0)
})

mean(sb_mc)                                                    # Monte-Carlo-Schaetzer
qnorm(0.95) * sqrt(25^2 + 30^2 + 2 * 0.3 * 25 * 30) # analytischer Wert zum Vergleich
```
Der über 1000 Wiederholungen gemittelte simulierte Sicherheitsbestand liegt in der erwarteten Größenordnung des analytisch berechneten Werts — die (durch die kleine Stichprobe von 30 Tagen je Wiederholung bedingte) Restabweichung ist eine bekannte Eigenschaft von Quantilsschätzern und **bestätigt** die Formel, ohne dass die Normalverteilungsannahme explizit in eine geschlossene Lösung eingesetzt werden muss. Dieses Vorgehen ist besonders wertvoll, wenn (wie im letzten Abschnitt dieses Kapitels) die tatsächliche Verteilung von der Normalverteilung abweicht und keine geschlossene Formel mehr existiert.
:::
Der direkte Vergleich zeigt den Effekt der Korrelation zwischen Wiesbaden und Mainz besonders deutlich: Ohne Korrelation ($\rho = 0$) läge der zentrale Sicherheitsbestand beider Filialen bei $z_\alpha\sqrt{25^2+30^2} \approx$ `r round(qnorm(0.95)*sqrt(25^2+30^2),1)` Boxen; mit der angenommenen Korrelation von $\rho = 0{,}3$ steigt er auf rund `r round(qnorm(0.95)*sqrt(25^2+30^2+2*0.3*25*30),1)` Boxen — der Pooling-Vorteil gegenüber $sb_{dez} =$ `r round(qnorm(0.95)*(25+30),1)` Boxen schrumpft von `r round((1-sqrt(25^2+30^2)/(25+30))*100,1)` % auf nur noch `r round((1-sqrt(25^2+30^2+2*0.3*25*30)/(25+30))*100,1)` %.
Dieselbe Logik lässt sich auf das **gesamte Sechs-Filialen-Netzwerk** übertragen — mit `MASS::mvrnorm()` für mehrdimensionale, korrelierte Normalverteilungen. Angenommen, jeweils benachbarte Filialpaare sind mit $\rho = 0{,}3$ korreliert (Wiesbaden–Mainz, Frankfurt–Offenbach, Rüsselsheim–Darmstadt), alle übrigen Paare bleiben unkorreliert:
```{r}
#| label: ch6-mvrnorm-korrelation-netzwerk
#| message: false
# Korrelationsmatrix: 1 auf der Diagonalen, 0.3 fuer die drei Nachbarpaare
R_mat <- diag(6)
nachbarpaare <- list(c(1, 2), c(3, 6), c(4, 5))   # (Wiesbaden,Mainz), (Frankfurt,Offenbach), (Ruesselsheim,Darmstadt)
for (paar in nachbarpaare) R_mat[paar[1], paar[2]] <- R_mat[paar[2], paar[1]] <- 0.3
rownames(R_mat) <- colnames(R_mat) <- filialen$Filiale
R_mat
# Kovarianzmatrix = Korrelationsmatrix skaliert mit den Sigma-Werten
Sigma_mat <- outer(filialen$sigma, filialen$sigma) * R_mat

# Analytischer zentraler Sicherheitsbestand bei Korrelation:
# Var(Summe) = Summe aller Eintraege der Kovarianzmatrix
sb_zentral_korreliert <- z_a * sqrt(sum(Sigma_mat))
sb_zentral_korreliert
# Monte-Carlo-Gegenprobe mit MASS::mvrnorm()
set.seed(2026)
sim_netzwerk <- MASS::mvrnorm(n = 100000, mu = filialen$mu, Sigma = Sigma_mat)
d0_netzwerk  <- rowSums(sim_netzwerk)
sb_mc_netzwerk <- quantile(d0_netzwerk, 0.95) - mean(d0_netzwerk)
sb_mc_netzwerk
# Pooling-Einsparung mit vs. ohne Nachbarschaftskorrelation
tibble(
  Szenario = c("Unabhaengig (rho = 0)", "Benachbarte Filialen korreliert (rho = 0.3)"),
  SB_zentral = c(sb_zentral_sf, sb_zentral_korreliert),
  Einsparung_Prozent = c(round(einsparung_sf, 1),
                          round((1 - sb_zentral_korreliert / sb_dezentral_sf) * 100, 1))
)
```
Analytische Formel und Monte-Carlo-Simulation stimmen auch im sechsdimensionalen Fall sehr gut überein. Inhaltlich zeigt sich: Sobald geografisch benachbarte Filialen positiv korrelieren, sinkt die Pooling-Einsparung von 56,0 % auf rund 51 % — der Risikoausgleich funktioniert also weiterhin, aber spürbar schwächer, weil ein Teil der scheinbar "zufälligen" Nachfrageschwankungen in Wahrheit gemeinsame, nicht ausgleichbare Ursachen hat (z. B. schlägt ein verregnetes Wochenende in Wiesbaden und Mainz gleichzeitig auf die Nachfrage durch). Für die Praxis folgt daraus: Bei der Abschätzung des Pooling-Nutzens sollte die Korrelationsstruktur zwischen den zusammengelegten Standorten nicht ignoriert werden — sie lässt sich aus historischen Verkaufsdaten direkt schätzen (`cor()`) und in die obige Kovarianzmatrix einsetzen.
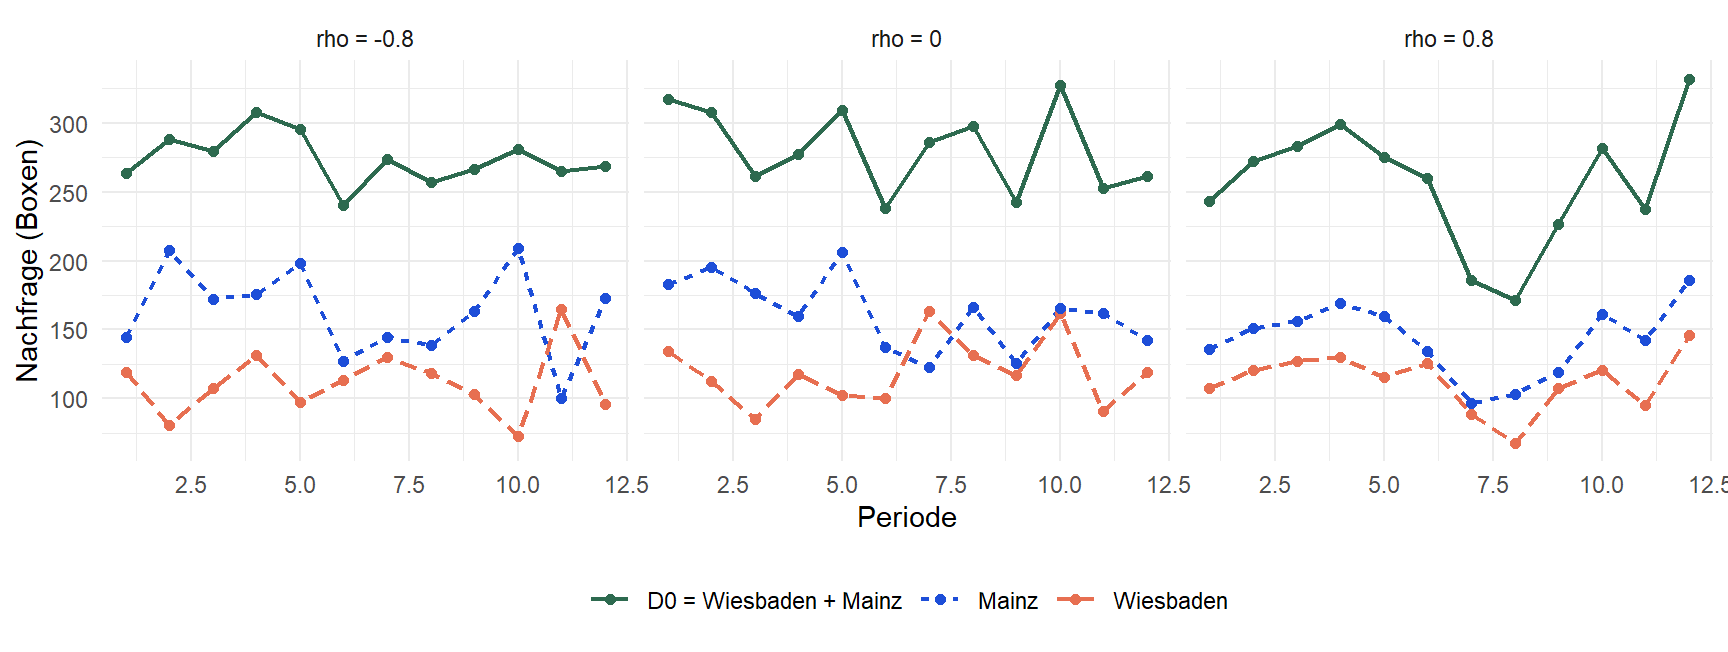
Die folgende Abbildung veranschaulicht den Korrelationseffekt noch einmal anhand von drei simulierten Nachfrageverläufen für Wiesbaden und Mainz mit identischen Randverteilungen, aber unterschiedlicher Korrelation:
```{r}
#| label: ch6-korrelation-zeitreihen
#| fig-cap: "Gepoolte Nachfrage D0 = Wiesbaden + Mainz bei unterschiedlicher Korrelation"
#| fig-width: 9
#| fig-height: 3.4
set.seed(43)
rho_werte <- c(-0.8, 0, 0.8)

sim_rho <- map_dfr(rho_werte, function(rho) {
  simuliere_pooled_demand(12, 120, 150, 25, 30, rho) |>
    mutate(periode = row_number(), rho_label = paste0("rho = ", rho))
})

sim_rho_long <- sim_rho |>
  pivot_longer(cols = c(d1, d2, d0), names_to = "reihe", values_to = "wert") |>
  mutate(reihe = recode(reihe, d1 = "Wiesbaden", d2 = "Mainz", d0 = "D0 = Wiesbaden + Mainz"))

ggplot(sim_rho_long, aes(x = periode, y = wert, color = reihe, linetype = reihe)) +
  geom_line(linewidth = 0.8) +
  geom_point(size = 1.6) +
  facet_wrap(~rho_label) +
  scale_color_manual(values = c("Wiesbaden" = "#E76F51", "Mainz" = "#1D4ED8", "D0 = Wiesbaden + Mainz" = "#2D6A4F")) +
  labs(x = "Periode", y = "Nachfrage (Boxen)", color = NULL, linetype = NULL) +
  theme_minimal() +
  theme(legend.position = "bottom")
```
Bei **negativer** Korrelation ($\rho = -0{,}8$) verläuft die Summenkurve $D_0$ auffällig glatter als jede der beiden Einzelreihen — Ausschläge nach oben bei Wiesbaden fallen tendenziell mit Ausschlägen nach unten bei Mainz zusammen und heben sich auf. Bei **positiver** Korrelation ($\rho = +0{,}8$) verstärken sich die Schwankungen dagegen gegenseitig, und $D_0$ schwankt sichtbar stärker. Genau dieser Unterschied in der *Glattheit* der Summenreihe ist die anschauliche Entsprechung der oben hergeleiteten Formel.
## Das Quadratwurzelgesetz des Pooling
Die bisherige Herleitung galt für Standorte mit potenziell unterschiedlicher Streuung und Korrelation. Ein besonders häufiger und lehrreicher Spezialfall liegt vor, wenn $n$ **identische, unabhängige** Standorte gepoolt werden — jeder mit derselben Streuung $\sigma$ und $\rho = 0$ untereinander. Dieser Fall führt auf das berühmte **Quadratwurzelgesetz des Pooling** [vgl. @simchilevi2010operations; @silver2017inventory, Kap. 6].
### Herleitung
Bei $n$ unabhängigen, identisch verteilten Standorten mit Streuung $\sigma$ beträgt der **dezentrale** Gesamtsicherheitsbestand schlicht die Summe der $n$ Einzelbestände:
$$
sb_{dez} = n \cdot z_\alpha \cdot \sigma
$$
Für die **zentrale** Variante addieren sich unter Unabhängigkeit ($\rho = 0$) die Varianzen der $n$ Standorte zur Gesamtvarianz $n \cdot \sigma^2$. Die Standardabweichung der gepoolten Nachfrage ist folglich **nicht** $n\sigma$, sondern nur:
$$
\sigma_{zen} = \sqrt{n \cdot \sigma^2} = \sqrt{n}\cdot \sigma
$$
und damit
$$
sb_{zen} = z_\alpha \cdot \sqrt{n}\cdot \sigma
$$
Das Verhältnis der beiden Sicherheitsbestände ist bemerkenswert einfach:
$$
\frac{sb_{zen}}{sb_{dez}} = \frac{z_\alpha \sqrt{n}\,\sigma}{n\, z_\alpha\, \sigma} = \frac{1}{\sqrt{n}}
$$
Der zentrale Sicherheitsbestand wächst also nur mit der **Quadratwurzel** der Standortanzahl, während der dezentrale Bestand **linear** mit $n$ wächst. Je mehr Standorte gepoolt werden, desto größer die relative Einsparung — der **Pooling-Faktor** $\sqrt{n}$ beschreibt genau diesen Effekt.
Warum addieren sich unter Unabhängigkeit gerade die **Varianzen** und nicht etwa die Standardabweichungen? Das folgt aus einem Grundsatz der Wahrscheinlichkeitsrechnung: Für unabhängige Zufallsvariablen $X_1, \dots, X_n$ gilt stets $\text{Var}(X_1 + \dots + X_n) = \text{Var}(X_1) + \dots + \text{Var}(X_n)$, während die Standardabweichung als Quadratwurzel der Varianz gerade **nicht** additiv ist. Genau dieser Unterschied zwischen additiven Varianzen und subadditiven Standardabweichungen ist der mathematische Kern des gesamten Pooling-Effekts — nicht nur im Spezialfall $\rho=0$, sondern, wie oben gezeigt, auch allgemein über den Kovarianzterm $2\rho\sigma_1\sigma_2$. Wie das SushiFresh-Beispiel mit den sechs heterogenen Filialen demonstriert hat, ist die Annahme identischer, unabhängiger Standorte eine **Idealisierung**: Sind reale Standorte unterschiedlich groß (unterschiedliches $\sigma_i$, wie bei Frankfurt) oder korreliert (wie bei benachbarten Filialen), fällt die tatsächliche Einsparung geringer aus als die reine $\sqrt{n}$-Formel für den idealisierten Fall suggeriert — die allgemeinere Formel mit individuellen $\sigma_i$ und Korrelationen aus dem vorigen Abschnitt ist dann die korrekte Grundlage.
### Eigene Implementierung des Quadratwurzelgesetzes
Weil die Herleitung so kompakt ist, lohnt es sich, die Formel **selbst als R-Funktion nachzubauen**, bevor die fertige Version aus `scm_functions.R` verwendet wird:
```{r}
#| label: ch6-sqrt-law-eigenbau
# Eigene Implementierung des Quadratwurzelgesetzes
mein_pooling_sb <- function(n, sigma, z) {
  ss_individual        <- z * sigma            # Sicherheitsbestand je Standort
  ss_total_dezentral    <- n * ss_individual    # Summe ueber alle n Standorte
  sigma_zentral         <- sqrt(n) * sigma      # gepoolte Standardabweichung
  ss_zentral            <- z * sigma_zentral    # zentraler Sicherheitsbestand
  einsparung_prozent    <- (1 - ss_zentral / ss_total_dezentral) * 100

  list(ss_total_dezentral = ss_total_dezentral,
       ss_zentral         = ss_zentral,
       einsparung_prozent = round(einsparung_prozent, 1),
       pooling_faktor     = sqrt(n))
}

# Idealisierter Referenzfall: 6 (identische) Filialen mit der DURCHSCHNITTLICHEN
# Streuung sigma_mean = 176/6 = 29,33 der SushiFresh-Filialen
mein_pooling_sb(n = 6, sigma = sigma_mean, z = qnorm(0.95))
# Vergleich mit der fertigen Funktion aus R/scm_functions.R
pooling_safety_stock(n = 6, sigma = sigma_mean, z = qnorm(0.95))
```
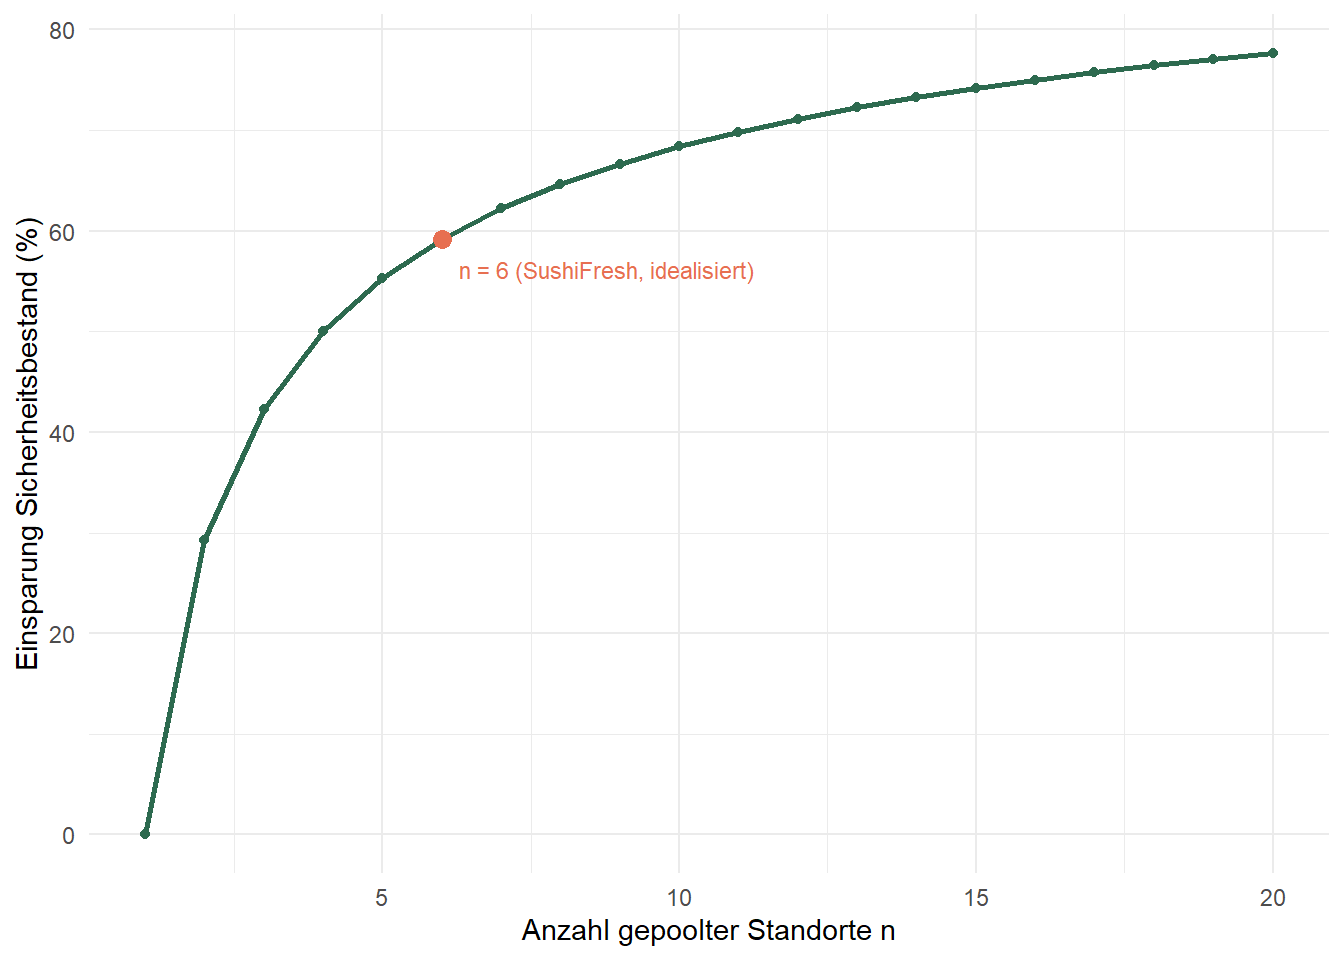
Beide Implementierungen liefern identische Ergebnisse: Bei sechs idealisiert **identischen** Standorten mit $\sigma = 29{,}33$ und $\alpha = 95\,\%$ ergibt sich eine Einsparung von rund 59,2 % — spürbar mehr als die 56,0 %, die für die tatsächlichen, heterogenen SushiFresh-Filialen berechnet wurden (siehe vorheriger Abschnitt). Mit wachsendem $n$ nimmt die relative Einsparung im idealisierten Fall weiter zu, allerdings mit **abnehmender Grenzrate** — der Sprung von $n=1$ auf $n=4$ bringt mehr zusätzliche Einsparung als der Sprung von $n=16$ auf $n=20$:
```{r}
#| label: ch6-sqrt-law-plot
#| fig-cap: "Relative Einsparung an Sicherheitsbestand als Funktion der Standortanzahl n (idealisiert, sigma = 29,33)"
n_seq <- 1:20

einsparung_df <- tibble(n = n_seq) |>
  mutate(einsparung = map_dbl(n, ~ pooling_safety_stock(.x, sigma = sigma_mean, z = qnorm(0.95))$savings_pct))

ggplot(einsparung_df, aes(x = n, y = einsparung)) +
  geom_line(color = "#2D6A4F", linewidth = 1) +
  geom_point(color = "#2D6A4F") +
  geom_point(data = filter(einsparung_df, n == 6), color = "#E76F51", size = 3) +
  annotate("text", x = 6.3, y = einsparung_df$einsparung[6] - 3,
           label = "n = 6 (SushiFresh, idealisiert)", hjust = 0, size = 3, color = "#E76F51") +
  labs(x = "Anzahl gepoolter Standorte n", y = "Einsparung Sicherheitsbestand (%)") +
  theme_minimal()
```
Dieser abnehmende Grenznutzen ist der ökonomische Grund, warum Unternehmen in der Praxis selten beliebig viele Lagerstandorte vollständig zentralisieren: Die ersten wenigen zusammengelegten Standorte bringen den größten Effekt, während weitere Zentralisierung nur noch kleine zusätzliche Einsparungen bei gleichzeitig steigenden Transport- und Koordinationskosten bringt (analog zum Chaining-Argument weiter oben). Zudem gilt das Quadratwurzelgesetz in dieser einfachen Form nur unter der Annahme **unabhängiger** Nachfrage ($\rho=0$) und **identischer** Standorte — bei positiv korrelierten oder unterschiedlich großen Standorten fällt die Einsparung, wie in den vorigen Abschnitten gezeigt, entsprechend geringer aus.
## Grenzen der Normalverteilungsannahme: eine simulierte Tagesnachfrage-Zeitreihe
Die bisherigen Beispiele beruhten auf der Annahme (near-)normalverteilter Nachfrage oder auf kleinen, überschaubaren Datensätzen. Reale Verkaufsdaten sind selten so gutmütig: Feiertage, Sonderaktionen oder Wetterumschwünge erzeugen gelegentlich **Nachfragespitzen**, die eine einfache Normalverteilungsannahme verletzen. Als Abschluss dieses Kapitels wird dieser Effekt an einer **simulierten** Tagesnachfrage-Zeitreihe für die Filialen Frankfurt und Offenbach untersucht — bewusst synthetisch erzeugt (mit `set.seed()` reproduzierbar), aber mit gelegentlichen, gemeinsamen "Feiertags-Spitzen", die typische Eigenschaften realer Verkaufsdaten nachbilden:
```{r}
#| label: ch6-simulierte-realistische-daten
#| message: false
set.seed(616)
n_tage <- 250

# Basis-Tagesnachfrage: normalverteilt um die bekannten Filial-Parameter,
# aber mit etwas geringerer "Grundstreuung", da die Spitzentage separat
# hinzugefuegt werden
frankfurt <- pmax(30, round(rnorm(n_tage, mean = 280, sd = 55 * 0.7)))
offenbach <- pmax(10, round(rnorm(n_tage, mean = 95,  sd = 22 * 0.7)))

# Gemeinsame Nachfragetreiber: an 6 zufaelligen Tagen (Feiertage, Events)
# schlagen BEIDE Filialen gleichzeitig deutlich staerker aus
spitzentage <- sample(seq_len(n_tage), size = 6)
frankfurt[spitzentage] <- frankfurt[spitzentage] + round(runif(6, 220, 420))
offenbach[spitzentage] <- offenbach[spitzentage] + round(runif(6, 70, 150))

sim_df <- tibble(tag = seq_len(n_tage), Frankfurt = frankfurt, Offenbach = offenbach,
                  Pool = frankfurt + offenbach)

sim_df |>
  summarise(mu_Frankfurt = mean(Frankfurt), sig_Frankfurt = sd(Frankfurt),
            mu_Offenbach = mean(Offenbach), sig_Offenbach = sd(Offenbach),
            rho = cor(Frankfurt, Offenbach))
```
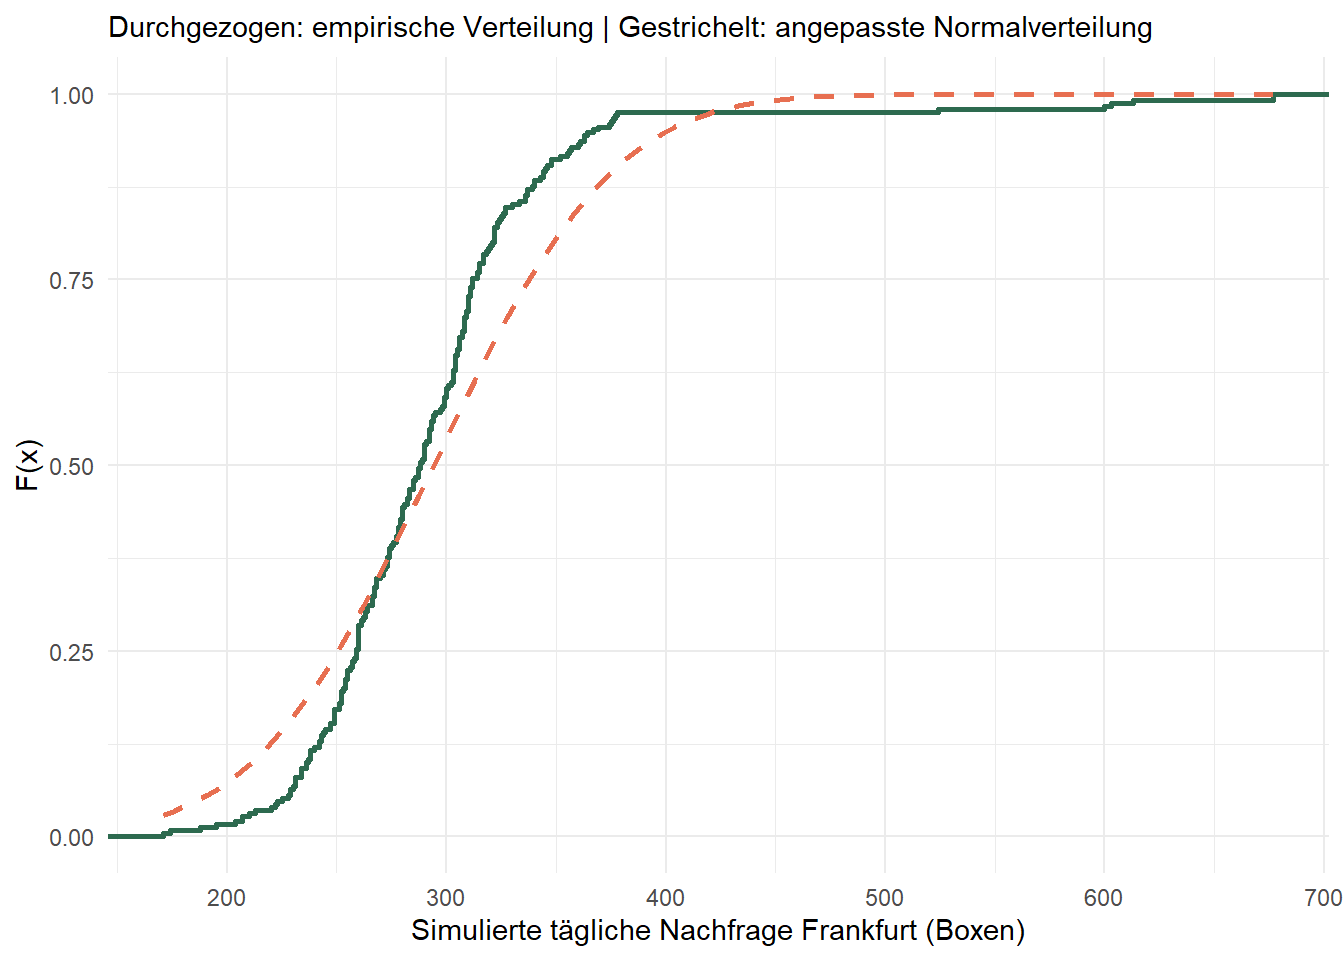
Auffällig sind die vereinzelten **extremen Spitzen** an den simulierten Feiertagen — sie treiben die Standardabweichung beider Reihen über das Niveau der "normalen" Tage hinaus und werfen die Frage auf, ob die Normalverteilungsannahme aus dem vorigen Abschnitt hier überhaupt noch zulässig ist:
```{r}
#| label: ch6-real-ecdf-vs-normal
#| fig-cap: "ECDF vs. angepasste Normalverteilung: simulierte Tagesnachfrage Frankfurt (Feiertags-Spitzen dominieren die Anpassung)"
mu_f <- mean(frankfurt); sig_f <- sd(frankfurt)

ggplot(sim_df, aes(x = Frankfurt)) +
  stat_ecdf(geom = "step", color = "#2D6A4F", linewidth = 0.9) +
  stat_function(fun = pnorm, args = list(mean = mu_f, sd = sig_f),
                color = "#E76F51", linetype = "dashed", linewidth = 0.9) +
  labs(x = "Simulierte tägliche Nachfrage Frankfurt (Boxen)", y = "F(x)",
       subtitle = "Durchgezogen: empirische Verteilung | Gestrichelt: angepasste Normalverteilung") +
  theme_minimal()
# Formaler Test auf Normalverteilung (Kolmogorov-Smirnov)
ks.test(frankfurt, "pnorm", mu_f, sig_f)$p.value
```
Der extrem kleine p-Wert des Kolmogorov-Smirnov-Tests bestätigt den optischen Eindruck: Die simulierte Verteilung ist durch die eingestreuten Spitzentage **deutlich von einer Normalverteilung entfernt** — sie ist rechtsschief mit einer langen "Spitzen-Nachfrage"-Flanke. Dennoch lässt sich der Pooling-Effekt **empirisch**, also ganz ohne Normalverteilungsannahme, direkt über `ecdf()` bzw. `quantile()` auswerten:
```{r}
#| label: ch6-real-pooling-vergleich
#| tbl-cap: "Empirischer vs. parametrischer Sicherheitsbestand bei simulierten, feiertagsbelasteten Filialdaten"
alpha_r <- 0.95
z_r <- qnorm(alpha_r)

# Empirisch: Quantile direkt aus den simulierten Daten
sb_f_emp  <- quantile(frankfurt, alpha_r, type = 1) - mu_f
sb_o_emp  <- quantile(offenbach, alpha_r, type = 1) - mean(offenbach)
sb_dez_emp <- sb_f_emp + sb_o_emp
sb_zen_emp <- quantile(sim_df$Pool, alpha_r, type = 1) - mean(sim_df$Pool)

# Parametrisch: Normalverteilungsannahme trotz schlechten Fits anwenden
sig_o <- sd(offenbach); rho_r <- cor(frankfurt, offenbach)
sb_dez_par <- z_r * (sig_f + sig_o)
sb_zen_par <- z_r * sqrt(sig_f^2 + sig_o^2 + 2 * rho_r * sig_f * sig_o)

tibble(
  Methode = c("Empirisch (ECDF)", "Parametrisch (Normalverteilung)"),
  SB_dezentral = round(c(sb_dez_emp, sb_dez_par), 1),
  SB_zentral   = round(c(sb_zen_emp, sb_zen_par), 1),
  Einsparung_Prozent = round(c((1 - sb_zen_emp / sb_dez_emp) * 100,
                                (1 - sb_zen_par / sb_dez_par) * 100), 1)
)
```
Zwei Beobachtungen sind hier lehrreich. Erstens: Die gemeinsamen Feiertags-Spitzen erzeugen eine spürbare positive Korrelation zwischen Frankfurt und Offenbach ($\hat\rho \approx$ `r round(cor(frankfurt, offenbach), 2)`) — dennoch bringt Pooling auch hier noch eine klar positive Einsparung, sowohl empirisch als auch parametrisch, auch wenn sie geringer ausfällt als im (unkorrelierten) Hauptergebnis für alle sechs Filialen. Zweitens: **Empirischer und parametrischer Sicherheitsbestand fallen deutlich auseinander** — die parametrische Rechnung liefert wegen der spitzen-getriebenen Standardabweichung höhere absolute Werte als die empirische Quantilsschätzung. Das ist eine wichtige praktische Lehre: Wo die Normalverteilungsannahme schlecht zur tatsächlichen Datenlage passt (was sich leicht mit ECDF-Plot und `ks.test()` prüfen lässt), sollte der Sicherheitsbestand **empirisch** und nicht **parametrisch** bestimmt werden — ansonsten führen einzelne extreme Tage zu einer massiven, ökonomisch schwer zu rechtfertigenden Über- oder Unterdimensionierung des Bestands. Für das idealisierte, normalverteilte Hauptergebnis dieses Kapitels (289,5 vs. 127,5 Boxen, siehe oben) wurde diese Vereinfachung bewusst in Kauf genommen — für die operative Umsetzung in der Zentralküche wäre jedoch, wie dieses Beispiel zeigt, eine ergänzende empirische Kontrolle anhand der tatsächlichen Verkaufsdaten sinnvoll.
## Zusammenfassung
Dieses Kapitel hat gezeigt, dass Unsicherheit in Supply Chains kein vermeidbares Planungsversagen ist, sondern eine **strukturelle Konsequenz** der zeitlichen Trennung zwischen Kapazitätsentscheidung (ex ante) und Nachfragerealisierung (ex post). Die implizierte Unsicherheit eines Produkts — bestimmt durch Nachfrageunsicherheit und Liefervariabilität — legt fest, wie reaktionsfähig die zugehörige Supply Chain ausgelegt sein sollte; bei SushiFresh verschärft die kurze Haltbarkeit der Sushi-Boxen dieses Problem zusätzlich. Sicherheitsbestände dämpfen diesen Mismatch über die Zeit; ihre Höhe folgt direkt aus dem gewünschten $\alpha$-Servicegrad und der (empirischen oder parametrischen) Nachfrageverteilung.
Das verbindende Prinzip des Kapitels war **Pooling**: Ob bei Produktionskapazitäten (SushiFresh' Pilotküchen Wiesbaden/Mainz, Chaining) oder bei Lagerbeständen (die sechs Filialen bei dezentraler und zentraler Versorgung) — die Bündelung von Ressourcen über mehrere Standorte oder Perioden hinweg erlaubt einen **Risikoausgleich**, der Servicegrad und Auslastung gleichzeitig verbessert, ohne zusätzliche physische Kapazität zu schaffen. Das **Kernergebnis** dieses Kapitels: Durch die Konsolidierung auf eine Zentralküche sinkt der nötige Sicherheitsbestand bei $\alpha = 95\,\%$ von 289,5 Boxen (dezentral, sechs Filialen einzeln) auf 127,5 Boxen (zentral, gepoolt) — eine Einsparung von 56,0 %. Formal wird dieser Effekt durch das **Quadratwurzelgesetz** gefasst: Der Sicherheitsbestand wächst bei unabhängigen, identischen Standorten nur mit $\sqrt{n}$ statt linear mit $n$ — mit abnehmendem Grenznutzen bei wachsender Standortzahl. Dass die tatsächliche Einsparung (56,0 %) etwas unter dem idealisierten Wert für sechs identische Standorte (59,2 %) liegt, zeigt zugleich eine wichtige Einschränkung: Ein dominanter, überdurchschnittlich volatiler Standort wie Frankfurt schmälert den relativen Pooling-Nutzen. Der Nutzen des Poolings hängt außerdem entscheidend von der **Korrelation** zwischen den gepoolten Nachfragen ab: Er ist am größten bei negativer Korrelation, sinkt bei positiv korrelierten (z. B. geografisch benachbarten) Standorten spürbar und verschwindet bei perfekter positiver Korrelation vollständig.
Auf der R-Seite wurden in diesem Kapitel die Werkzeuge zur **Modellierung von Unsicherheit** eingeführt: die Funktionsfamilie `rnorm()`/`dnorm()`/`pnorm()`/`qnorm()` für die Normalverteilung, `set.seed()` zur Reproduzierbarkeit von Zufallsexperimenten, `replicate()` sowie `MASS::mvrnorm()` für Monte-Carlo-Simulationen mit korrelierten Zufallsvariablen, und `ecdf()` sowie `quantile()` für die datengetriebene, verteilungsfreie Auswertung empirischer Beobachtungen. Diese Werkzeuge sind nicht auf Pooling beschränkt — sie bilden die Grundlage für das **Newsvendor-Modell** in @sec-newsvendor, wo (erneut am Beispiel der Filiale Frankfurt) die Bestimmung einer optimalen Bestellmenge unter Unsicherheit im Mittelpunkt steht.
::: {.kontrollfragen}
**Kontrollfragen**
1. Was unterscheidet die *implizierte Unsicherheit* eines Produkts von seiner reinen Nachfrageunsicherheit? Ordnen Sie SushiFresh' Sushi-Boxen in das *Implied Uncertainty Spectrum* ein und begründen Sie Ihre Einordnung.
2. Warum kann bei fixer Kapazität und stochastischer Nachfrage in derselben Periode gleichzeitig Über- und Unterauslastung an verschiedenen Standorten auftreten?
3. Erläutern Sie den Unterschied zwischen einseitigem und zweiseitigem Kapazitätspooling am Beispiel der beiden SushiFresh-Pilotküchen Wiesbaden und Mainz. Warum verbessert Pooling alle Servicekennzahlen gleichzeitig, ohne zusätzliche Kapazität zu schaffen?
4. Was versteht man unter *Chaining*, und warum erreicht bereits eine Kettenstruktur mit $2n$ statt $n^2$ Verbindungen einen Großteil des vollständigen Pooling-Nutzens?
5. Definieren Sie den $\alpha$-Servicegrad formal. Wie lässt sich der zugehörige Sicherheitsbestand aus historischen Daten bestimmen, ohne eine Verteilungsannahme zu treffen?
6. Leiten Sie die Formel für den zentralen Sicherheitsbestand zweier gepoolter, normalverteilter Standorte her. Für welchen Wert der Korrelation $\rho$ verschwindet der Pooling-Nutzen vollständig, und warum?
7. Berechnen Sie für die sechs SushiFresh-Filialen den dezentralen und den zentralen Sicherheitsbestand bei $\alpha = 95\,\%$. Warum liegt die tatsächliche Einsparung (56,0 %) unter der Einsparung, die sich für sechs *identische* Standorte mit derselben Durchschnittsstreuung ergäbe (59,2 %)?
8. In welchen Situationen sollte der Sicherheitsbestand empirisch statt parametrisch (über die Normalverteilung) bestimmt werden? Nutzen Sie in Ihrer Antwort die Ergebnisse des simulierten Frankfurt/Offenbach-Fallbeispiels.
:::
::: {.callout-tip}
## Übungen und Fallstudie
Aufgaben zur Klausurvorbereitung mit ausklappbaren Musterlösungen (Teil 1) und eine vertiefende Gruppenfallstudie (Teil 2) zu diesem Kapitel finden Sie in **[Fallstudie 4: Kapazitäts- und Lagerbestandspooling](https://tkirschstein.github.io/SCM_BDBM/case_studies/case_study_04_pooling_einzelhandel)**.
:::