# Kürzeste Wege {#sec-kuerzeste-wege}
```{r}
#| label: chkw-setup
#| echo: false
#| warning: false
#| message: false
# Funktionen aus scm_functions.R einbinden (u. a. haversine())
source("../R/scm_functions.R")
source("../R/scm_helpers.R") # Darstellungshilfen (Farben, Tabellen, Formatierung)
library(tidyverse)
library(knitr)
library(kableExtra)
# Inline-Zahlen im Fließtext deutsch formatieren (Dezimalkomma, Tausenderpunkt)
knitr::knit_hooks$set(inline = function(x) {
if (is.numeric(x)) format(x, big.mark = ".", decimal.mark = ",") else x
})
```
::: {.lernziele}
**Lernziele**
Nach diesem Kapitel können Sie …
- Straßennetze als **Graphen** mit Knoten, Kanten und Kantengewichten **modellieren**,
- verschiedene Varianten des **Kürzeste-Wege-Problems** **unterscheiden**,
- den **Dijkstra-Algorithmus** von Hand **durchführen** und in R **implementieren**,
- aus kürzesten Wegen eine **Distanzmatrix** für Transport- und Tourenplanung **ableiten**,
- Graphen in R als Kantenliste und Gewichtsmatrix darstellen und mit logischen Masken und benannten Vektoren arbeiten.
**Literatur zur Vertiefung**
- Kürzeste Wege und Graphentheorie in der Logistik: @domschke2007transport.
- Originalarbeit zum Algorithmus: @dijkstra1959note.
- Transport- und Tourenplanung im Überblick: @guenther2012produktion.
:::
## Woher kommen die Transportkosten?
In der Standort- und der Transportplanung (Kapitel [-@sec-standort-2] und [-@sec-transportplanung]) waren die Transportkosten $c_{ij}$ einfach **gegeben**. Kapitel [-@sec-verkehrsmittel] hat gezeigt, wie sich Kostensätze je Kilometer aus einer Fahrzeugkostenrechnung ergeben. Um daraus Kosten je Verbindung zu machen, fehlt noch ein Baustein: die **Entfernung** zwischen zwei Orten im Straßennetz. Es gilt vereinfacht
$$c_{ij} = \text{Kostensatz je km} \times \text{Entfernung}_{ij}.$$
Die Luftlinie, die wir in Kapitel [-@sec-standort-1] mit der Haversine-Formel berechnet haben, ist dafür nur eine erste Näherung. Lkw fahren nicht Luftlinie: Rhein- und Mainbrücken, Autobahnkreuze und Ortsdurchfahrten bestimmen die tatsächliche Strecke. Gesucht ist der **kürzeste Weg im Straßennetz**.
::: {.fallstudie}
**Fallstudie: Entfernungen für die Disposition**
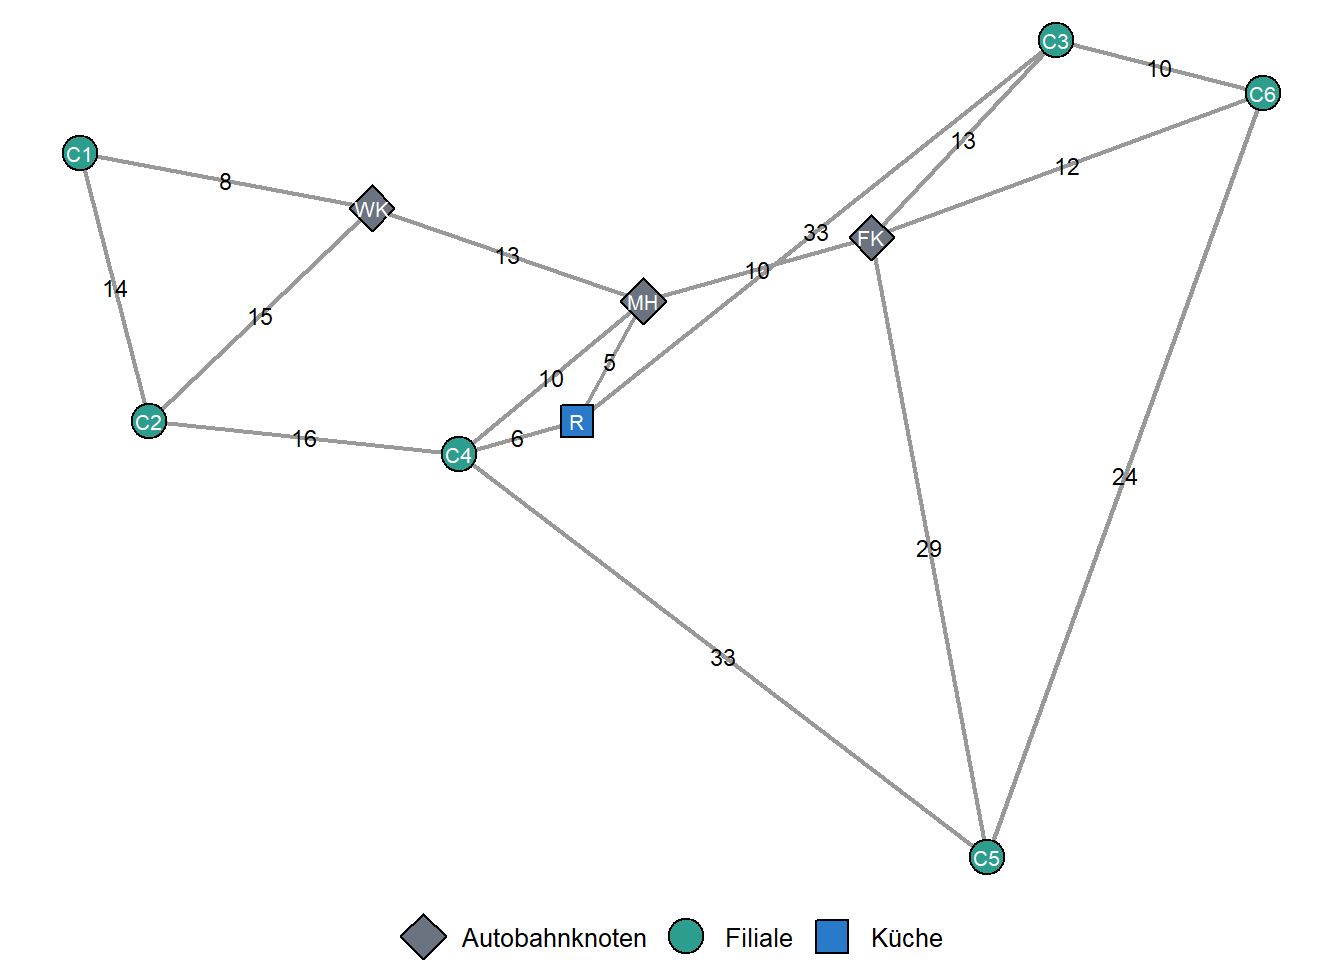
Das Weihnachtsgeschäft ist vorbei, die Zentralküche **Raunheim** beliefert wieder alle sechs Filialen allein. Die neue Disponentin möchte die Kostensätze selbst nachvollziehen und eine Tourenplanung vorbereiten. Dafür braucht sie die Straßenentfernungen von Raunheim zu jeder Filiale und zwischen allen Filialen. Als Grundlage dient ein vereinfachtes Straßennetz des Rhein-Main-Gebiets mit zehn Knoten: der Zentralküche, den sechs Filialen und drei Autobahnknoten (Mönchhof-Dreieck, Wiesbadener Kreuz, Frankfurter Kreuz).
:::
## Straßennetze als Graphen
::: {.definition}
**Definition: Graph**
Ein **Graph** $G = (V, E)$ besteht aus einer Menge von **Knoten** $V$ und einer Menge von **Kanten** $E$, die jeweils zwei Knoten verbinden. In einem **gewichteten** Graphen trägt jede Kante $(v, w)$ ein Gewicht $c_{vw}$, etwa eine Länge, eine Fahrzeit oder Kosten. Ein Graph ist **ungerichtet**, wenn jede Kante in beide Richtungen gleich befahrbar ist, sonst **gerichtet**. Ein **Weg** von $s$ nach $t$ ist eine Folge benachbarter Knoten, seine **Länge** die Summe der Kantengewichte.
:::
In einem Straßennetz sind die Knoten Orte (Küche, Filialen) und Verknüpfungspunkte (Kreuzungen, Autobahnkreuze), die Kanten direkte Straßenverbindungen. Einbahnstraßen und Autobahnauffahrten machen reale Netze gerichtet. Unser vereinfachtes Netz behandeln wir als ungerichtet.
::: {.r-exkurs}
**R-Exkurs: Graphen als Kantenliste und Gewichtsmatrix**
Ein Graph lässt sich in R auf zwei Arten speichern. Die **Kantenliste** ist ein Datenrahmen mit einer Zeile je Kante (Anfangsknoten, Endknoten, Gewicht). Sie ist kompakt und leicht zu pflegen. Die **Gewichtsmatrix** (Adjazenzmatrix) ist eine quadratische Matrix mit einer Zeile und einer Spalte je Knoten, deren Eintrag $(v, w)$ das Gewicht der Kante von $v$ nach $w$ enthält, oder 0, wenn es keine direkte Kante gibt. Sie erlaubt schnellen Zugriff auf alle Nachbarn eines Knotens. Die Umwandlung gelingt mit der Indexmatrix aus Kapitel [-@sec-transportplanung]: `W[cbind(von, nach)] <- km` setzt alle Kanten auf einmal. Für einen ungerichteten Graphen wird zusätzlich die Gegenrichtung gesetzt, sodass die Matrix symmetrisch wird.
```{r}
#| label: chkw-graph
knoten <- tibble(
  ID   = c("R", "MH", "WK", "FK", "C1", "C2", "C3", "C4", "C5", "C6"),
  Name = c("Raunheim (Zentralküche)", "Mönchhof-Dreieck", "Wiesbadener Kreuz",
           "Frankfurter Kreuz", "Wiesbaden", "Mainz", "Frankfurt", "Rüsselsheim",
           "Darmstadt", "Offenbach"),
  Typ  = c("Küche", rep("Autobahnknoten", 3), rep("Filiale", 6)),
  Lon  = c(8.4650, 8.4950, 8.3720, 8.5985, 8.2398, 8.2711, 8.6821, 8.4116, 8.6512, 8.7761),
  Lat  = c(50.0000, 50.0350, 50.0620, 50.0535, 50.0782, 50.0000, 50.1109, 49.9904,
           49.8728, 50.0956)
)

kanten <- tribble(
  ~von, ~nach, ~km,
  "R",  "MH",   5,   "R",  "C4",  6,   "R",  "C3", 33,
  "MH", "WK",  13,   "MH", "FK", 10,   "MH", "C4", 10,
  "WK", "C1",   8,   "WK", "C2", 15,   "C1", "C2", 14,
  "C2", "C4",  16,   "C4", "C5", 33,   "FK", "C3", 13,
  "FK", "C5",  29,   "FK", "C6", 12,   "C3", "C6", 10,
  "C5", "C6",  24
)

W <- matrix(0, nrow(knoten), nrow(knoten), dimnames = list(knoten$ID, knoten$ID))
W[cbind(kanten$von, kanten$nach)] <- kanten$km
W[cbind(kanten$nach, kanten$von)] <- kanten$km     # ungerichtet: symmetrisch
W["R", W["R", ] > 0]                               # Nachbarn von Raunheim
```
Die letzte Zeile nutzt eine **logische Maske**: `W["R", ] > 0` liefert einen logischen Vektor, der genau die Nachbarn von Raunheim markiert, und die eckigen Klammern wählen diese Einträge aus.
:::
```{r}
#| label: chkw-netzplot
#| fig-cap: "Vereinfachtes Straßennetz Rhein-Main (Kantenlängen in km)"
# planare Koordinaten in km für eine maßstabsgetreue Darstellung
knoten <- knoten |>
  mutate(x = Lon * 111.32 * cos(50 * pi / 180), y = Lat * 111.32)
kanten_xy <- kanten |>
  left_join(select(knoten, von = ID, x1 = x, y1 = y), by = "von") |>
  left_join(select(knoten, nach = ID, x2 = x, y2 = y), by = "nach")

netz_plot <- function(kanten_farbe = NULL) {
  ggplot() +
    geom_segment(data = kanten_xy, aes(x = x1, y = y1, xend = x2, yend = y2),
                 colour = if (is.null(kanten_farbe)) "grey60" else kanten_farbe,
                 linewidth = 0.8) +
    geom_label(data = kanten_xy, aes(x = (x1 + x2) / 2, y = (y1 + y2) / 2, label = km),
               size = 3, label.size = 0, label.padding = unit(0.1, "lines")) +
    geom_point(data = knoten, aes(x = x, y = y, shape = Typ, fill = Typ), size = 6) +
    geom_text(data = knoten, aes(x = x, y = y, label = ID), size = 2.8, colour = "white") +
    scale_shape_manual(values = c(Autobahnknoten = 23, Filiale = 21, Küche = 22)) +
    scale_fill_manual(values = c(Autobahnknoten = "#6B7280", Filiale = "#2D9E8E",
                                 Küche = "#2A7ACA")) +
    coord_equal() +
    theme_void(base_size = 12) + theme(legend.position = "bottom", legend.title = element_blank())
}
netz_plot()
```
## Kürzeste-Wege-Probleme
Je nachdem, zwischen welchen Knoten kürzeste Wege gesucht werden, unterscheidet man drei Varianten:
- **1 → 1:** der kürzeste Weg von einem Startknoten $s$ zu einem Zielknoten $t$, typisch für Navigationssysteme,
- **1 → alle:** die kürzesten Wege von $s$ zu allen anderen Knoten, typisch für die Kostensätze ab einem Depot,
- **alle → alle:** die kürzesten Wege zwischen allen Knotenpaaren, typisch für die Distanzmatrix der Tourenplanung.
::: {.vertiefung}
**Theorie-Vertiefung: Kürzeste Wege als Netzwerkflussproblem**
Das Kürzeste-Wege-Problem von $s$ nach $t$ lässt sich als Spezialfall eines Transportproblems auf einem Netz formulieren: Eine Einheit fließt von $s$ nach $t$. Mit der Flussvariable $x_{vw} \geq 0$ auf jeder (gerichteten) Kante gilt
$$
\min \sum_{(v,w) \in E} c_{vw} \, x_{vw} \qquad \text{u.d.N.} \qquad \sum_{w} x_{vw} - \sum_{w} x_{wv} = \begin{cases} 1 & v = s \\ -1 & v = t \\ 0 & \text{sonst} \end{cases}
$$
Die Nebenbedingungen sind **Flusserhaltungsbedingungen**: Aus $s$ fließt eine Einheit mehr heraus als hinein, in $t$ eine mehr hinein als heraus, alle anderen Knoten werden nur durchflossen. Wie beim Transportproblem ist die Nebenbedingungsmatrix total unimodular, sodass die LP-Lösung ganzzahlig ist: Jede Kante wird ganz oder gar nicht benutzt. Man könnte das Problem also mit `ompr` lösen. Spezialisierte Algorithmen wie Dijkstra sind aber um Größenordnungen schneller.
:::
## Der Dijkstra-Algorithmus
### Idee
Der Algorithmus von @dijkstra1959note breitet sich vom Startknoten $s$ aus wie eine **Welle** aus. Jeder Knoten $v$ trägt eine **Marke** $d(v)$, die bisher kürzeste bekannte Entfernung von $s$, und einen **Vorgänger** $p(v)$. Marken sind zunächst **temporär**, also vorläufig und noch verbesserbar. In jedem Schritt wird der temporär markierte Knoten mit der **kleinsten** Marke **permanent** markiert, und die Marken seiner Nachbarn werden korrigiert:
$$d(w) \leftarrow \min\big(d(w),\; d(v) + c_{vw}\big)$$
Verbessert sich $d(w)$, wird $v$ zum neuen Vorgänger von $w$. Diese Operation heißt **Markenkorrektur**.
::: {.definition}
**Algorithmus: Dijkstra**
*Initialisierung:* $d(s) = 0$, $d(v) = \infty$ für alle $v \neq s$; alle Marken temporär; $p(v)$ = –.
*Wiederhole*, bis alle Knoten permanent markiert sind:
1. Wähle den temporär markierten Knoten $v$ mit kleinstem $d(v)$.
2. Markiere $v$ permanent.
3. Für jeden temporär markierten Nachbarn $w$ von $v$: Falls $d(v) + c_{vw} < d(w)$, setze $d(w) = d(v) + c_{vw}$ und $p(w) = v$.
*Ergebnis:* $d(v)$ ist die kürzeste Entfernung von $s$ nach $v$. Der Weg ergibt sich durch Rückverfolgung der Vorgänger.
:::
::: {.vertiefung}
**Theorie-Vertiefung: Warum die kleinste temporäre Marke endgültig ist**
Angenommen, $v$ ist der temporäre Knoten mit kleinster Marke $d(v)$, und es gäbe einen kürzeren Weg von $s$ nach $v$. Dieser Weg muss irgendwann die Menge der permanenten Knoten verlassen, und zwar über einen temporären Knoten $u$. Bis $u$ ist er mindestens $d(u) \geq d(v)$ lang, denn $d(v)$ ist die kleinste temporäre Marke. Weil alle Kantengewichte **nichtnegativ** sind, kann der restliche Weg von $u$ nach $v$ ihn nicht mehr verkürzen. Also ist er mindestens $d(v)$ lang, ein Widerspruch. Diese Argumentation zeigt auch die zentrale **Voraussetzung**: Gibt es negative Kantengewichte, etwa Strecken mit Erlösen aus Rückladungen, versagt Dijkstra. Dann ist der Bellman-Ford-Algorithmus nötig.
:::
### Fallbeispiel: Kürzeste Wege ab Raunheim
Um den Algorithmus Schritt für Schritt zu verfolgen, implementieren wir eine Variante, die nach jeder Iteration ein **Tableau** protokolliert: In jeder Zeile steht, welcher Knoten permanent wird und welche Marken die übrigen Knoten tragen.
::: {.r-exkurs}
**R-Exkurs: Benannte Vektoren und `names(which.min())`**
Für Dijkstra verwalten wir drei **benannte Vektoren** mit einem Eintrag je Knoten: die Marken `d`, die Vorgänger `pred` und den logischen Vektor `perm`, der permanent markierte Knoten anzeigt. Weil die Vektoren dieselben Namen tragen, lassen sie sich direkt mit Knotennamen indizieren, etwa `d["C3"]`. Die kleinste **temporäre** Marke findet der Ausdruck `which.min(ifelse(perm, Inf, d))`: `ifelse()` ersetzt die Marken permanenter Knoten durch `Inf`, sodass sie nie gewählt werden. `which.min()` liefert die Position mit Namen, und `names()` extrahiert den Knotennamen.
```{r}
#| label: chkw-dijkstra
dijkstra <- function(W, start) {
  ids  <- rownames(W)
  d    <- setNames(rep(Inf, length(ids)), ids)
  pred <- setNames(rep(NA_character_, length(ids)), ids)
  perm <- setNames(rep(FALSE, length(ids)), ids)
  d[start] <- 0
  tableau <- list()
  while (!all(perm)) {
    v <- names(which.min(ifelse(perm, Inf, d)))     # 1. kleinste temporäre Marke
    perm[v] <- TRUE                                 # 2. permanent markieren
    for (w in ids[W[v, ] > 0 & !perm]) {            # 3. Markenkorrektur
      if (d[v] + W[v, w] < d[w]) {
        d[w] <- d[v] + W[v, w]; pred[w] <- v
      }
    }
    tableau[[length(tableau) + 1]] <-
      c(permanent = v, ifelse(perm, "", ifelse(is.finite(d),
                                                paste0(d, " | ", pred), "∞")))
  }
  list(d = d, pred = pred, tableau = do.call(rbind, tableau))
}
```
:::
```{r}
#| label: chkw-tableau
ergebnis <- dijkstra(W, "R")

kbl(ergebnis$tableau, booktabs = TRUE,
    caption = "Dijkstra-Tableau ab Raunheim (Einträge: Marke | Vorgänger; leer = bereits permanent)") |>
  kable_styling(full_width = FALSE, bootstrap_options = c("striped", "condensed"),
                font_size = 12)
```
Das Tableau zeigt die Arbeitsweise. In der ersten Iteration wird Raunheim permanent, seine Nachbarn erhalten erste Marken: Mönchhof-Dreieck 5, Rüsselsheim 6 und Frankfurt 33 über die direkte Bundesstraße. Danach werden nacheinander Mönchhof (5) und Rüsselsheim (6) permanent. In der vierten Iteration wird das Frankfurter Kreuz (15) permanent, und dabei passiert etwas Wichtiges: Die Marke von **Frankfurt** sinkt von 33 auf $15 + 13 = 28$ km, der Vorgänger wechselt auf das Frankfurter Kreuz. Der Weg über die Autobahn ist kürzer als die direkte Bundesstraße. Temporäre Marken sind eben nur vorläufig. Nach zehn Iterationen sind alle Knoten permanent, und die Reihenfolge, in der sie permanent wurden, entspricht genau ihren aufsteigenden Entfernungen.
### Der Kürzeste-Wege-Baum
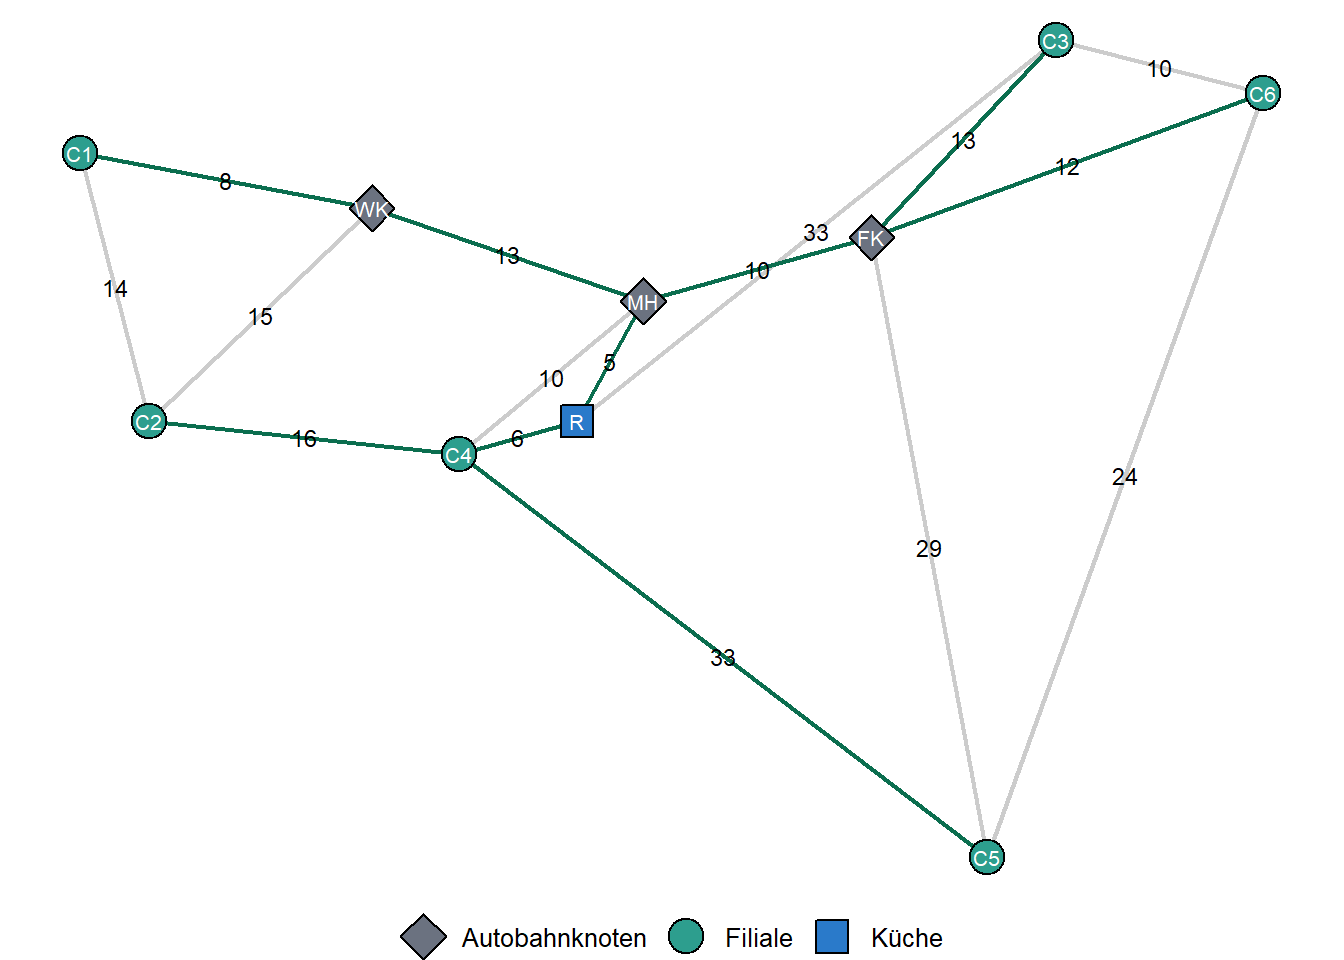
Die Vorgänger bilden einen **Baum**: Von jedem Knoten führt genau ein kürzester Weg zurück zum Start. Den vollständigen Weg erhält man durch Rückverfolgung der Vorgänger, bis der Startknoten erreicht ist.
```{r}
#| label: chkw-pfade
pfad <- function(pred, ziel) {
  p <- ziel
  while (!is.na(pred[p[1]])) p <- c(pred[p[1]], p)   # Vorgänger voranstellen
  paste(p, collapse = " → ")
}

luftlinie <- with(knoten, haversine(Lat[ID == "R"], Lon[ID == "R"], Lat, Lon))
names(luftlinie) <- knoten$ID

wege <- knoten |>
  filter(Typ == "Filiale") |>
  transmute(Filiale = Name,
            Weg = map_chr(ID, ~ pfad(ergebnis$pred, .x)),
            km = ergebnis$d[ID],
            Luftlinie = round(luftlinie[ID], 1),
            Umwegfaktor = round(km / Luftlinie, 2))
wege
```
Der **Umwegfaktor**, das Verhältnis von Straßenentfernung zu Luftlinie, liegt im Mittel bei `r round(mean(wege$Umwegfaktor), 2)`. Für Deutschland sind Werte von etwa 1,2 bis 1,4 typisch. Unser vereinfachtes Netz mit wenigen Kanten erzwingt größere Umwege, besonders nach Darmstadt und Rüsselsheim. Wer in einer Standortplanung mit Luftlinien rechnet, sollte deshalb zumindest mit einem pauschalen Umwegfaktor korrigieren.
```{r}
#| label: chkw-baum
#| fig-cap: "Kürzeste-Wege-Baum ab Raunheim (grün)"
baum <- tibble(nach = names(ergebnis$pred), von = ergebnis$pred) |>
  filter(!is.na(von)) |>
  mutate(schluessel = map2_chr(von, nach, ~ paste(sort(c(.x, .y)), collapse = "-")))
kanten_xy <- kanten_xy |>
  mutate(schluessel = map2_chr(von, nach, ~ paste(sort(c(.x, .y)), collapse = "-")),
         im_baum = schluessel %in% baum$schluessel)

netz_plot(kanten_farbe = ifelse(kanten_xy$im_baum, "#0B6E4F", "grey80"))
```
## Distanzmatrix für die Tourenplanung
Für die Tourenplanung (Kapitel [-@sec-tourenplanung]) braucht die Disponentin nicht nur die Entfernungen ab Raunheim, sondern zwischen **allen** relevanten Orten. Dafür wird Dijkstra einfach von jedem dieser Orte aus gestartet. `sapply()` ruft die Funktion für jeden Startknoten auf und fügt die Ergebnisse spaltenweise zu einer Matrix zusammen. `t()` transponiert sie, sodass Zeilen die Startorte sind.
```{r}
#| label: chkw-distanzmatrix
orte <- c("R", paste0("C", 1:6))
D <- t(sapply(orte, function(s) dijkstra(W, s)$d[orte]))
D
```
Die Autobahnknoten sind aus der Matrix „herausgerechnet“, sie enthält nur noch die relevanten Orte. Die Matrix ist **symmetrisch**, weil das Netz ungerichtet ist, und sie erfüllt die **Dreiecksungleichung** $d_{ik} \leq d_{ij} + d_{jk}$: Gäbe es über einen Zwischenort einen kürzeren Weg, hätte Dijkstra ihn gefunden. Solche Matrizen heißen **metrisch**. Die Tourenplanung wird diese Eigenschaft nutzen.
Mit der Distanzmatrix lässt sich bereits eine erste Kennzahl berechnen: Im heutigen **Pendelverkehr**, bei dem jede Filiale einzeln angefahren wird, legt der Kühl-Lkw täglich $2 \cdot \sum_j d_{Rj}$ = `r 2 * sum(D["R", -1])` km zurück. Kapitel [-@sec-verkehrsmittel] hat gezeigt, dass ein E-Kühl-Lkw im Winter höchstens rund 157 km schafft. Ob eine Rundtour durch alle Filialen kürzer sein kann, ist die Frage des nächsten Kapitels.
## Varianten und Erweiterungen
Der Aufwand von Dijkstra wächst in der einfachen Form mit dem Quadrat der Knotenzahl, $\mathcal{O}(n^2)$, mit einer Prioritätswarteschlange mit $\mathcal{O}(|E| + n \log n)$. Für spezielle Situationen gibt es andere Verfahren:
- **Bellman-Ford** erlaubt negative Kantengewichte, ist aber langsamer ($\mathcal{O}(n \cdot |E|)$).
- **Floyd-Warshall** berechnet alle Paare auf einmal ($\mathcal{O}(n^3)$) und ist für dichte Netze eine Alternative zu $n$-maligem Dijkstra.
- **A\*** ergänzt Dijkstra um eine Schätzung der Restentfernung, etwa die Luftlinie zum Ziel, und durchsucht dadurch viel weniger Knoten. Navigationssysteme nutzen solche Beschleunigungen, um Wege in Netzen mit Millionen Knoten in Millisekunden zu finden.
Wichtig ist auch die Frage, was „kurz“ bedeutet. Wird nach **Distanz** optimiert, spart man Kraftstoff und Verschleiß. Wird nach **Fahrzeit** optimiert, spart man Personalkosten und schont die Frische der Ware. Wird nach **Kosten** optimiert, gehen Maut und Fahrzeugkosten ein. Fahrzeiten sind zudem **zeitabhängig**: Die A3 um 7 Uhr ist eine andere Strecke als um 4 Uhr. Je nach Zielgröße ergeben sich unterschiedliche kürzeste Wege. Für reale Straßennetze greift man in R auf Pakete wie `igraph` (Graphalgorithmen) oder `osrm` (Routing auf OpenStreetMap-Daten, Kapitel [-@sec-standort-2]) zurück.
## Zusammenfassung
Straßennetze werden als **Graphen** mit Knoten, Kanten und Kantengewichten modelliert. Transportkosten ergeben sich aus Kostensatz und **kürzester Entfernung im Netz**, nicht aus der Luftlinie. Der **Dijkstra-Algorithmus** markiert schrittweise den nächstgelegenen offenen Knoten permanent und korrigiert die Marken seiner Nachbarn. Voraussetzung sind nichtnegative Kantengewichte. Temporäre Marken können sich noch verbessern, wie die Korrektur der Entfernung nach Frankfurt von 33 auf 28 km zeigt. Die Vorgänger bilden einen Kürzeste-Wege-Baum. Durch wiederholtes Anwenden entsteht eine symmetrische, metrische **Distanzmatrix**, die Grundlage der Tourenplanung.
Auf der R-Seite haben Sie Graphen als Kantenliste und Gewichtsmatrix gespeichert, mit logischen Masken Nachbarn ausgewählt, benannte Vektoren als Marken verwaltet und Wege mit einer `while`-Schleife zurückverfolgt.
::: {.kontrollfragen}
**Kontrollfragen**
1. Erläutern Sie die Begriffe Graph, Kante, Kantengewicht, gerichtet und ungerichtet am Beispiel eines Straßennetzes.
2. Welche drei Varianten des Kürzeste-Wege-Problems gibt es, und für welche Planungsaufgabe wird jeweils welche benötigt?
3. Formulieren Sie das Kürzeste-Wege-Problem als Netzwerkflussproblem. Welche Bedeutung haben die Flusserhaltungsbedingungen?
4. Warum ist beim Dijkstra-Algorithmus die kleinste temporäre Marke endgültig? Welche Voraussetzung ist dafür nötig?
5. Die Verbindung Mönchhof-Dreieck – Frankfurter Kreuz ist wegen einer Baustelle drei Wochen gesperrt. Führen Sie Dijkstra ab Raunheim von Hand im Tableau durch. Welche Filialen sind betroffen? Prüfen Sie Ihr Ergebnis, indem Sie in R die entsprechenden Einträge von `W` auf 0 setzen.
6. Wie viele Kilometer mehr fährt der Kühl-Lkw im Pendelverkehr während der Sperrung?
7. Was ist ein Umwegfaktor, und wofür lässt er sich in der Standortplanung nutzen?
8. Warum erfüllt eine aus kürzesten Wegen berechnete Distanzmatrix immer die Dreiecksungleichung?
9. Nennen Sie zwei Zielgrößen für „kurz“ neben der Distanz und eine Situation, in der sie zu einem anderen Weg führen.
:::
::: {.callout-tip}
## Übungen und Fallstudie
Aufgaben zur Klausurvorbereitung mit ausklappbaren Musterlösungen (Teil 1) und eine vertiefende Gruppenfallstudie (Teil 2) zu diesem Kapitel finden Sie in **[Fallstudie 9: Kürzeste Wege](https://tkirschstein.github.io/SCM_BDBM/case_studies/case_study_09_kuerzeste_wege)**.
:::