# Standortplanung I – Qualitative und kontinuierliche Verfahren {#sec-standort-1}
::: {.lernziele}
**Lernziele**
Nach diesem Kapitel können Sie …
- Standortentscheidungen im strategischen Supply-Chain-Design **einordnen**,
- qualitative Standortfaktoren systematisch **erfassen und bewerten**,
- das AHP-Verfahren und Nutzwertverfahren **erläutern und anwenden**,
- die Eigenschaften unterschiedlicher Distanzmetriken **erläutern** und diese **berechnen**,
- kontinuierliche Standortverfahren auf einfache Entscheidungsprobleme **anwenden und interpretieren**,
- grundlegende R-Kontrollstrukturen (Schleifen, Matrizen, `apply`-Funktionen, eigene Funktionen mit Abbruchkriterium) **anwenden**.
**Literatur zur Vertiefung**
- Modellgestützte regionale Standortplanung und -entwicklung: @kik2022standortplanung.
- Standortplanung und kontinuierliche Entscheidungsmodelle: @thonemann2023operations, Kapitel 3.
- Kontinuierliche Standortmodelle und lokale Gleichgewichte: @cooper1968locational.
:::
```{r}
#| label: ch4-setup
#| echo: false
#| warning: false
#| message: false
# Hilfsfunktionen aus R/scm_functions.R einbinden (u.a. center_of_gravity(),
# weiszfeld(), haversine(), ahp_priority_vector(), ahp_consistency())
source("../R/scm_functions.R")
source("../R/scm_helpers.R") # Darstellungshilfen (Farben, Tabellen, Formatierung)
library(tidyverse)
library(knitr)
library(kableExtra)
```
## Standortentscheidungen im strategischen Supply-Chain-Design
Kapitel [-@sec-logistikkosten] hat gezeigt, dass sich Supply-Chain-Entscheidungen an einem Zielsystem ausrichten, das zwischen Kosten, Servicegrad und weiteren Zielgrößen vermittelt, und dass Logistikkosten in erheblichem Umfang von der räumlichen Struktur eines Netzwerks abhängen. Genau an dieser räumlichen Struktur setzt dieses Kapitel an: Es geht um die Frage, **wo** ein Unternehmen seine Werke, Lager, Umschlagpunkte oder Verkaufsstandorte ansiedeln sollte, damit das Netzwerk als Ganzes den Zielkonflikt aus Kosten und Service möglichst gut löst.
Standortentscheidungen gehören zur **strategischen Netzwerkplanung** und unterscheiden sich in mehreren Punkten grundlegend von operativen Entscheidungen wie der Bestellmengenplanung, die in späteren Kapiteln behandelt wird. Erstens sind sie in aller Regel **kapitalintensiv und langfristig bindend**: Ein Werk oder ein Zentrallager lässt sich nicht ohne Weiteres verlegen, wenn sich Nachfragestrukturen ändern. Zweitens ist der Entscheidungsraum **mehrdimensional** – neben Transport- und Baukosten spielen Arbeitsmarkt, Infrastruktur, Steuern, politische Stabilität oder Nähe zu Kunden eine Rolle, und diese Kriterien lassen sich nicht immer in einer gemeinsamen Einheit (z. B. Euro) ausdrücken. Drittens sind viele der relevanten Informationen **unsicher oder subjektiv einzuschätzen**, etwa die künftige Entwicklung eines regionalen Arbeitsmarkts oder die "Standortqualität" im weichen Sinne. Diese drei Eigenschaften – Irreversibilität, Mehrdimensionalität und Unsicherheit – begründen, warum die Standortplanung ein eigenständiges Methodenspektrum entwickelt hat, das deutlich über eine einfache Kostenvergleichsrechnung hinausgeht [@kik2022standortplanung].
Der Standortplanungsprozess verläuft typischerweise in mehreren Phasen mit sinkendem Aggregationsgrad: Auf einer ersten, globalen Ebene werden Kontinente oder Länder anhand weniger, stark aggregierter Faktoren (z. B. Marktzugang, Lohnniveau, politisches Risiko) vorselektiert. Auf einer zweiten, regionalen Ebene wird der Suchraum auf Wirtschaftsräume oder Regionen eingegrenzt, wobei die Anforderungen bereits deutlich präziser formuliert werden können. Erst auf einer dritten, lokalen Ebene wird ein konkreter Standort – ein Grundstück, eine Gemeinde, eine Kreuzung im Verkehrsnetz – bestimmt [@chopra2025supply].
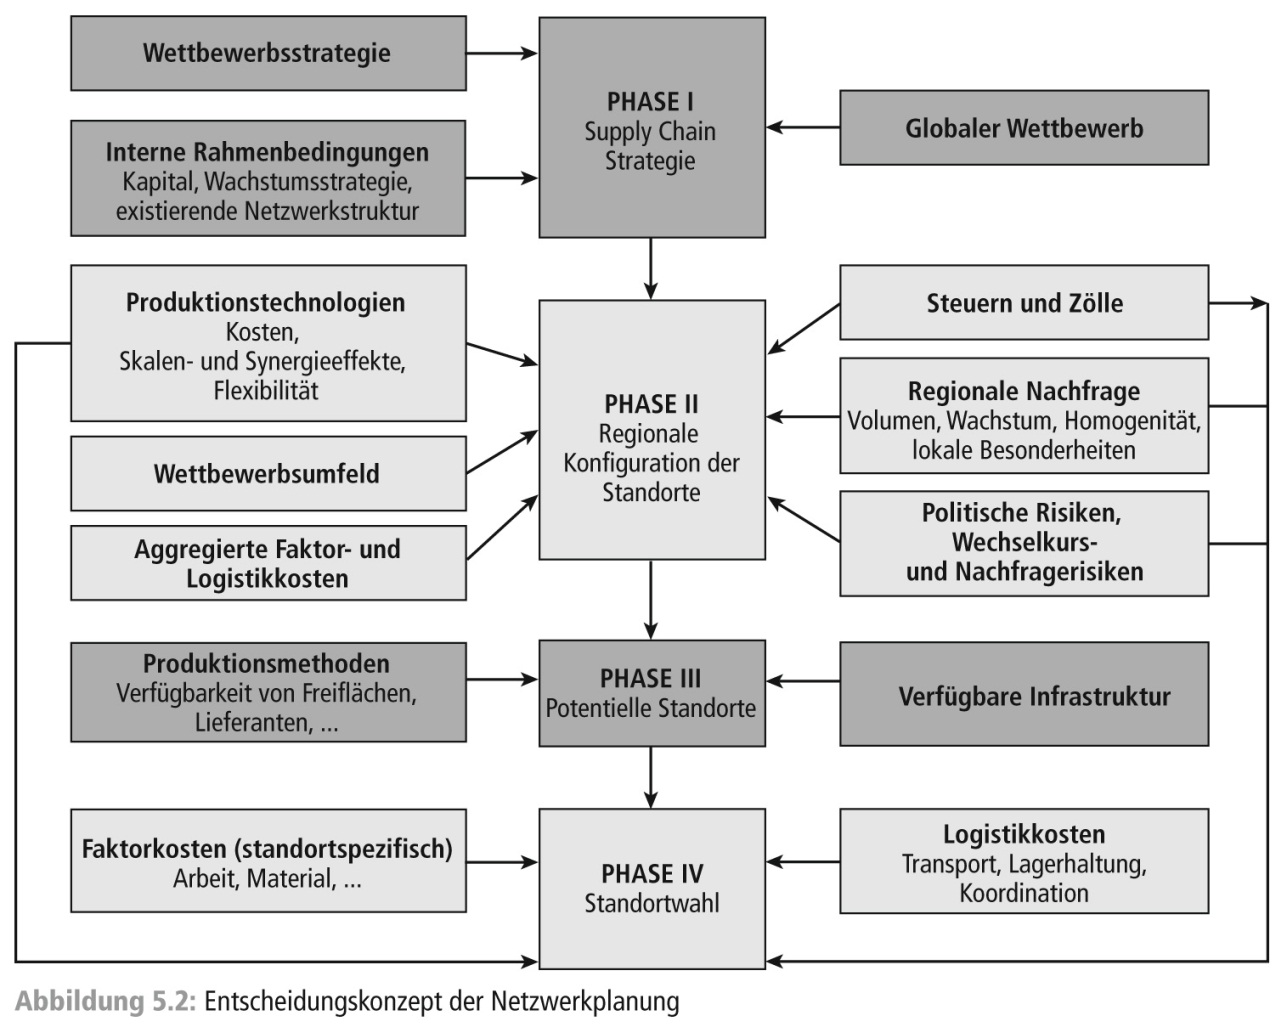{#fig-phasen-standortwahl width="85%"}
::: {.vertiefung}
**Theorie-Vertiefung: Die Supply Chain Planning Matrix**
Die Vorlesung ordnet die Standortplanung in die **Supply Chain Planning Matrix** ein [@stadtler2000supply]. Die Matrix spannt zwei Dimensionen auf: horizontal die Prozesse der Wertschöpfung (Beschaffung, Produktion, Distribution, Absatz), vertikal den Planungshorizont (lang-, mittel- und kurzfristig). In jeder Zelle stehen typische Planungsaufgaben — etwa Materialprogramm und Lieferantenwahl (langfristig, Beschaffung), Hauptproduktionsprogrammplanung (mittelfristig, Produktion) oder Tourenplanung (kurzfristig, Distribution). Die langfristige Zeile über alle Prozesse hinweg heißt **strategische Netzwerkplanung**: Sie legt fest, welche Standorte es gibt, welche Kapazität sie haben und welche Transportverbindungen zwischen ihnen bestehen.
Zwei Eigenschaften dieser Matrix sind für das Verständnis der folgenden Kapitel wichtig. Erstens wirken Entscheidungen **top-down**: Die strategische Netzwerkplanung setzt den Rahmen, innerhalb dessen mittelfristige Mengen- und kurzfristige Ablaufplanung stattfinden. Ein ungünstig gelegenes Lager kann durch noch so gute Tourenplanung nicht ausgeglichen werden. Zweitens gibt es eine **Rückkopplung bottom-up**: Um Standorte sinnvoll zu bewerten, müssen die späteren operativen Kosten (Transporte, Bestände) zumindest näherungsweise antizipiert werden. Standortmodelle arbeiten deshalb mit aggregierten Größen — durchschnittlichen Tagesnachfragen, Transportkostensätzen je Kilometer —, die die operative Ebene vereinfacht abbilden. Die Kapitel [-@sec-unsicherheit-pooling] bis [-@sec-bullwhip] zeigen später, welche zusätzlichen Effekte (Bestände, Unsicherheit, Bullwhip) auf dieser vereinfachten Ebene noch nicht sichtbar sind.
:::
Die Folien heben außerdem hervor, warum die Bewertung von Standorten so schwierig ist: Standortentscheidungen sind **kurzfristig irreversibel** und erzeugen **Pfadabhängigkeiten** (spätere Entscheidungen bauen auf dem einmal gewählten Netz auf), sie sind **mehrdimensional** (ihre Auswirkungen auf das Zielsystem aus Kapitel [-@sec-logistikkosten] sind schwer zu überblicken) und sie sind **subjektiv** (die Einschätzung weicher Faktoren schwankt zwischen Entscheidern, und deren Bedeutung wird unterschiedlich gewichtet).
Entsprechend breit ist das Spektrum der **Methoden der Standortplanung** [@kik2022standortplanung]. *Qualitative Verfahren* sind heuristische, meist umfragebasierte Verfahren, die ein Stimmungsbild und individuelle Einschätzungen zusammenführen. Unter den *quantitativen Verfahren* verlangt die **Optimierung** einen klar abgegrenzten Entscheidungsraum (die Optionen) und ein eindimensionales Zielsystem (z. B. Kosten); die **Simulation** kann komplexe, mehrdimensionale Wirkungszusammenhänge abbilden, ist aber aufwendig und schwer übertragbar; **spieltheoretische** Ansätze antizipieren das Verhalten von Konkurrenten, etwa um den Absatz eines Einzelhandelsstandorts zu maximieren; und die **Investitionsrechnung** bewertet Standorte ausschließlich anhand monetärer Größen über die Nutzungsdauer. Dieses und das folgende Kapitel behandeln qualitative Verfahren sowie Optimierungsmodelle, weil beide in der Praxis am häufigsten kombiniert werden.
Für die eigentliche Bewertung von Standorten (oder Standortregionen) stehen grundsätzlich zwei Klassen von Verfahren zur Verfügung. **Qualitative Verfahren** sind heuristische, häufig umfragebasierte Bewertungsansätze, die ein Stimmungsbild aus mehreren, meist auch weichen Kriterien zusammenführen; sie eignen sich besonders für die Vorauswahl zwischen einer begrenzten Zahl diskreter Alternativen. **Quantitative Verfahren** formulieren die Standortsuche dagegen als Optimierungsproblem mit einer expliziten Zielfunktion. In diesem Kapitel behandeln wir aus der qualitativen Familie die **Nutzwertanalyse** und den **Analytic Hierarchy Process (AHP)**; anschließend wenden wir uns den **kontinuierlichen** quantitativen Verfahren zu, bei denen der Standort nicht aus einer vorgegebenen Liste ausgewählt, sondern als beliebiger Punkt einer Ebene bestimmt wird. Die **diskreten** quantitativen Verfahren, bei denen aus einer endlichen Menge potenzieller Standorte eine kostenminimale Teilmenge auszuwählen ist, folgen in Kapitel [-@sec-standort-2].
Welche Standortfaktoren dabei überhaupt relevant sind, hängt stark vom Einzelfall ab. Grob lassen sie sich in **harte** Faktoren (Transportkosten, Löhne, Steuern, Grundstückspreise – direkt monetär bewertbar) und **weiche** Faktoren (Lebensqualität, Image der Region, Verfügbarkeit qualifizierter Arbeitskräfte, politische Stabilität) einteilen. Weiche Faktoren entziehen sich einer unmittelbaren Kostenrechnung, beeinflussen die Standortqualität aber ebenso stark – und genau für ihre systematische Erfassung sind qualitative Bewertungsverfahren gemacht.
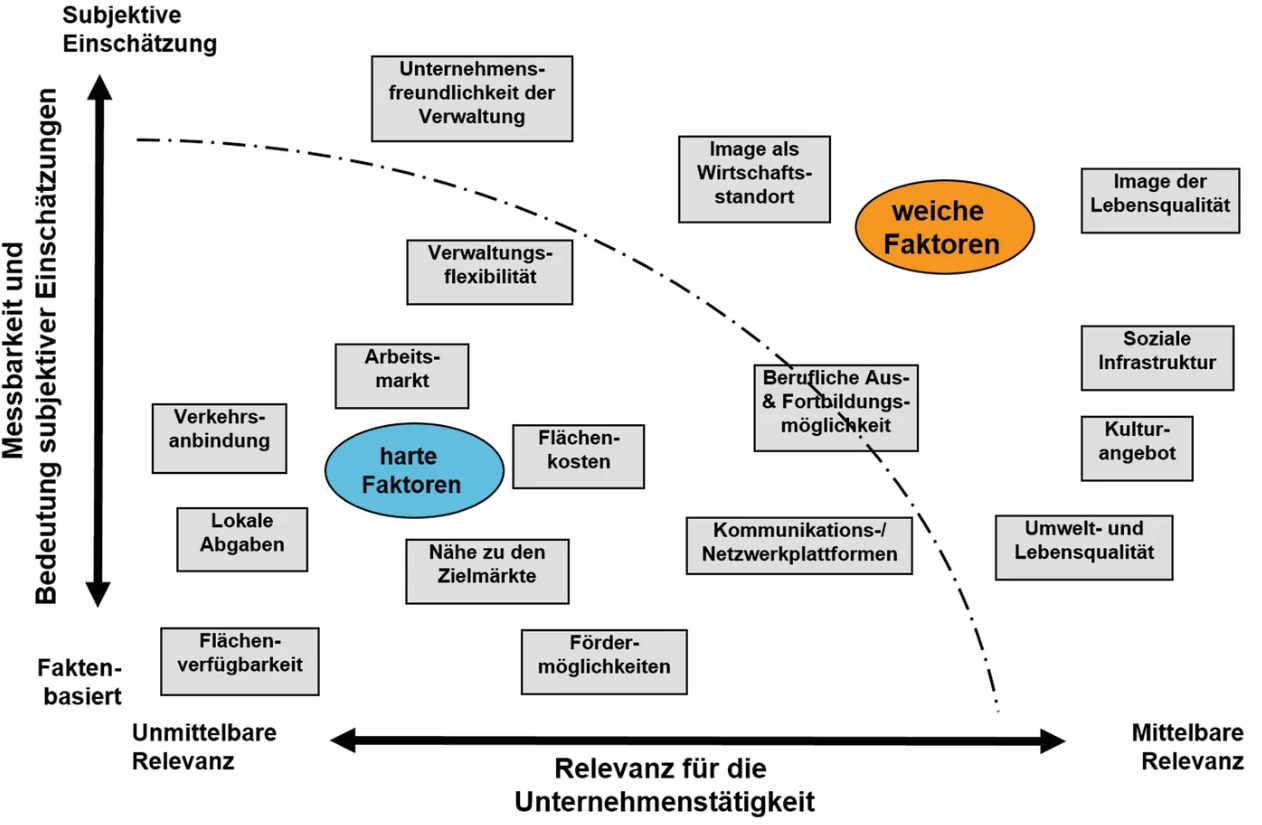{#fig-standortfaktoren width="80%"}
### Die Fallstudie dieses Kapitels: SushiFresh GmbH
Alle Verfahren dieses Kapitels wenden wir auf das in Abschnitt [-@sec-sushifresh-intro] eingeführte Fallbeispiel an, das uns auch in den folgenden Kapiteln zur Netzwerk- und Bestandsplanung begleitet: die **SushiFresh GmbH**, ein fiktiver regionaler Hersteller frischer Sushi-Boxen im Rhein-Main-Gebiet. SushiFresh beliefert täglich sechs Supermarkt-Filialen mit unterschiedlicher, aber weitgehend bekannter Nachfrage:
```{r}
#| label: ch4-sushifresh-filialen
#| echo: true
# Sechs beliefte Filialen mit Koordinaten (WGS84), mittlerer Tagesnachfrage
# mu (in Sushi-Boxen) und deren Standardabweichung sigma
filialen <- tibble(
  Filiale = c("Wiesbaden", "Mainz", "Frankfurt", "Ruesselsheim", "Darmstadt", "Offenbach"),
  lat   = c(50.0782, 50.0000, 50.1109, 49.9904, 49.8728, 50.0956),
  lon   = c(8.2398,  8.2711,  8.6821,  8.4116,  8.6512,  8.7761),
  mu    = c(120, 150, 280, 90, 110, 95),
  sigma = c(25, 30, 55, 20, 24, 22)
)
filialen
```
Die Geschäftsführung erwägt, zusätzlich zur bestehenden Auslieferung eine eigene Produktionsstätte im Rhein-Main-Gebiet zu errichten, und hat dafür drei Gewerbegrundstücke als Kandidatenstandorte identifiziert:
```{r}
#| label: ch4-sushifresh-standorte
#| echo: true
# Drei Kandidatenstandorte fuer die neue Produktionsstaette
standorte <- tibble(
  Standort = c("Wiesbaden-Erbenheim", "Mainz-Hechtsheim", "Raunheim"),
  lat = c(50.0632, 49.9698, 50.0000),
  lon = c(8.2999,  8.2831,  8.4650),
  Fixkosten = c(180000, 210000, 260000)
)
standorte
# Transportkostensatz je Box und Kilometer (wird spaeter noch gebraucht)
transportkostensatz <- 0.02
```
Wiesbaden-Erbenheim ist ein Gewerbegebiet mit direktem Anschluss an A66/A3 und vergleichsweise günstigen Grundstückspreisen; Mainz-Hechtsheim liegt an A60/A63 und in Rheinnähe, was die Anlieferung von Fisch begünstigt, ist aber teurer; Raunheim schließlich liegt nahe dem Frankfurter Flughafen mit sehr guter Anbindung an A3/A5, verlangt aber die höchsten Gewerbemieten. Die Spalte `Fixkosten` enthält die einmaligen Investitions- und Erschließungskosten der Grundstücke (Einrichtung, Kühltechnik, Produktionsausstattung); in Kapitel [-@sec-standort-2] werden sie auf eine Nutzungsdauer von fünf Jahren verteilt und so in jährliche Fixkosten umgerechnet. Die sechs Filialen fragen zusammen `r sum(filialen$mu)` Sushi-Boxen pro Tag nach; Frankfurt ist mit 280 Boxen die mit Abstand größte Filiale – sie wird uns in Kapitel [-@sec-newsvendor] als Beispiel für die Newsvendor-Formel wiederbegegnen. In diesem Kapitel geht es zunächst darum, wie SushiFresh die drei Kandidatenstandorte systematisch bewerten und wie das Unternehmen – unabhängig von den drei vorgegebenen Grundstücken – rein rechnerisch den transportkostenminimalen Punkt im Absatzgebiet bestimmen kann.
## Qualitative Standortbewertung
### Die Nutzwertanalyse
::: {.definition}
**Definition: Nutzwertanalyse**
Die **Nutzwertanalyse (NWA)** ist ein additives Multikriterien-Bewertungsverfahren. Für jede Alternative $j$ wird über alle Kriterien $k=1,\dots,K$ ein **Gesamtnutzwert** $N_j$ als gewichtete Summe der Teilnutzwerte $w_{jk}$ gebildet:
$$
N_j = \sum_{k=1}^{K} g_k \cdot w_{jk}, \qquad \sum_{k=1}^{K} g_k = 1,
$$
wobei $g_k$ das Gewicht des Kriteriums $k$ und $w_{jk}$ die (meist auf einer Punkteskala, z. B. 0–10, vergebene) Bewertung der Alternative $j$ bezüglich Kriterium $k$ ist.
:::
Die Nutzwertanalyse folgt einem klar strukturierten, fünfstufigen Vorgehen: Zunächst werden die relevanten Bewertungskriterien festgelegt, danach ihre Gewichte bestimmt (z. B. durch Expertenschätzung oder Paarvergleich). Anschließend werden die Alternativen je Kriterium bewertet, die gewichteten Teilnutzwerte zum Gesamtnutzwert aggregiert und die Alternativen schließlich nach diesem Gesamtnutzwert in eine Rangfolge gebracht.
Diese additive Struktur macht die Nutzwertanalyse einfach anzuwenden und leicht nachvollziehbar – birgt aber eine methodische Schwäche, die man sich am besten an einem Zahlenbeispiel klarmacht.
::: callout-note
## Fallbeispiel: Produktionsstandort für SushiFresh
Die Geschäftsleitung von SushiFresh bewertet die drei Kandidatenstandorte Wiesbaden-Erbenheim, Mainz-Hechtsheim und Raunheim anhand von drei – hier aus Vereinfachungsgründen gleich gewichteten – Kriterien: **Transportnähe** zu den sechs Filialen, **Mietkosten** und **Fachkräfteverfügbarkeit**. Wiesbaden-Erbenheim ist bei den Mietkosten am stärksten (niedrigste Fixkosten), Raunheim bei der Transportnähe zum Filialnetz, während Mainz-Hechtsheim bei der Fachkräfteverfügbarkeit vorn liegt – dort gibt es einen guten Zugang zu gastronomischen und lebensmitteltechnischen Ausbildungsstätten.
:::
```{r}
#| label: ch4-nwa-tabelle
#| echo: true
# Rohdaten der Fallstudie: drei Kriterien, gleich gewichtet (1/3 je Kriterium),
# Bewertungen der drei Kandidatenstandorte auf einer Skala von 0 (schlecht) bis 10 (gut)
nwa <- tibble(
  Kriterium = c(
    "Transportnaehe",
    "Mietkosten",
    "Fachkraefteverfuegbarkeit"
  ),
  Gewicht = c(1/3, 1/3, 1/3),
  `WI-Erbenheim`  = c(5, 8, 2),
  `MZ-Hechtsheim` = c(2, 5, 8),
  Raunheim        = c(8, 2, 5)
)

# Gesamtnutzwert je Standort: Summe aus Gewicht * Bewertung ueber alle Kriterien
nutzwert <- c(
  `WI-Erbenheim`  = sum(nwa$Gewicht * nwa$`WI-Erbenheim`),
  `MZ-Hechtsheim` = sum(nwa$Gewicht * nwa$`MZ-Hechtsheim`),
  Raunheim        = sum(nwa$Gewicht * nwa$Raunheim)
)
nutzwert
```
```{r}
#| label: ch4-nwa-kable
#| echo: false
nwa_tab <- bind_rows(
nwa,
tibble(Kriterium = "Nutzwert", Gewicht = NA,
`WI-Erbenheim` = nutzwert["WI-Erbenheim"],
`MZ-Hechtsheim` = nutzwert["MZ-Hechtsheim"],
Raunheim = nutzwert["Raunheim"])
)
nwa_tab |>
mutate(
Gewicht = ifelse(is.na(Gewicht), "", sprintf("%.2f", Gewicht)),
across(c(`WI-Erbenheim`, `MZ-Hechtsheim`, Raunheim), ~ sprintf("%.1f", .x))
) |>
kable(col.names = c("Kriterium", "Gewichtung", "WI-Erbenheim", "MZ-Hechtsheim", "Raunheim"),
align = "lccc") |>
kable_styling(full_width = FALSE)
```
Das Ergebnis ist auf den ersten Blick überraschend: **Alle drei Standorte erreichen exakt denselben Gesamtnutzwert von `r sprintf("%.1f", nutzwert[1])`** – obwohl ihre Stärken-Schwächen-Profile völlig unterschiedlich sind: Wiesbaden-Erbenheim punktet bei den Mietkosten, verliert aber bei der Fachkräfteverfügbarkeit; Mainz-Hechtsheim punktet bei den Fachkräften, verliert aber bei der Transportnähe; Raunheim punktet bei der Transportnähe, verliert aber bei den Mietkosten. Der Grund für das identische Ergebnis liegt in der additiven Verrechnung: Eine schwache Bewertung bei einem Kriterium kann durch eine entsprechend starke Bewertung bei einem anderen Kriterium **kompensiert** werden. Diese **Kompensierbarkeit** ist die zentrale methodische Schwäche der Nutzwertanalyse. Sie wirft mehrere Folgeprobleme auf:
- Das additive Modell ist nur eingeschränkt interpretierbar, weil es implizit unterstellt, dass die Kriterien **nutzenunabhängig** sind – dass sich also der Nutzenbeitrag eines Kriteriums nicht dadurch ändert, wie gut oder schlecht andere Kriterien ausfallen. Diese Annahme ist in der Praxis oft fraglich.
- Die Ergebnisse reagieren empfindlich auf die gewählte Gewichtung; kleine Verschiebungen der Gewichte $g_k$ können die Rangfolge der Alternativen umkehren.
- Es besteht die Gefahr der **Zielaufspaltung**: Ein an sich zusammenhängendes Ziel wird in viele Einzelkriterien zerlegt, deren Gewichte kaum noch nachvollziehbar festzulegen sind.
Diese Schwächen motivieren ein Verfahren, das die Kriterien- und Alternativengewichte systematischer – über **paarweise Vergleiche** statt über direkt geschätzte Punktwerte – ableitet: den Analytic Hierarchy Process.
### Der Analytic Hierarchy Process (AHP)
::: {.definition}
**Definition: Analytic Hierarchy Process**
Der **Analytic Hierarchy Process (AHP)** ist ein mehrstufiges Multikriterien-Entscheidungsverfahren, das Prioritäten – sowohl für Kriterien als auch für Alternativen – aus **paarweisen Vergleichen** ableitet. Anstatt Punktwerte direkt zu schätzen, beurteilt der Entscheider jeweils zwei Elemente gegeneinander ("Wie viel wichtiger ist A gegenüber B?") auf einer festgelegten Skala. Aus der resultierenden **Paarvergleichsmatrix** wird anschließend ein Prioritätsvektor abgeleitet, der als Rangfolge bzw. Gewichtung interpretiert werden kann.
:::
Der AHP läuft in fünf Schritten ab: (1) paarweise Vergleiche zwischen allen Alternativen je Bewertungskriterium bilden, (2) daraus für jedes Kriterium ein Alternativenranking ableiten ("Synthese"), (3) paarweise Vergleiche zwischen allen Bewertungskriterien bilden, (4) daraus ein Ranking der Kriterien ableiten, und (5) beide Rankings zu einem Gesamt-Score je Alternative kombinieren.
Paarweise Vergleiche werden üblicherweise auf einer neunstufigen Skala erfasst, die von "gleich wichtig" (Wert 1) bis "extrem bevorzugt" (Wert 9) reicht; der reziproke Wert $1/9$ bis $1$ drückt die umgekehrte Präferenzrichtung aus. Eine Paarvergleichsmatrix $A$ mit Einträgen $a_{ij}$ ("wie viel wichtiger ist $i$ gegenüber $j$?") ist also **reziprok**: $a_{ji} = 1/a_{ij}$, und die Diagonale enthält stets Einsen. Aus einer perfekt konsistenten Matrix ließe sich der Prioritätsvektor direkt aus einer einzigen Zeile oder Spalte ablesen; in der Praxis sind Experteneinschätzungen jedoch nie perfekt konsistent, weshalb der Prioritätsvektor über eine Mittelung – rechnerisch über den **dominanten Eigenvektor** der Matrix, approximiert z. B. über das geometrische Mittel der Zeilen – bestimmt wird.
::: callout-note
## Fallbeispiel: AHP für den SushiFresh-Produktionsstandort
Statt Punktwerte direkt zu schätzen, vergleicht die Geschäftsleitung von SushiFresh die drei Kandidatenstandorte Wiesbaden-Erbenheim, Mainz-Hechtsheim und Raunheim nun paarweise – sowohl untereinander je Kriterium als auch die drei Kriterien **Transportnähe**, **Mietkosten** und **Fachkräfteverfügbarkeit** gegeneinander.
:::
Um die drei Paarvergleichsmatrizen (eine je Kriterium) und die Kriterienvergleichsmatrix in R abzubilden, brauchen wir eine Datenstruktur, die – anders als ein `data.frame` – von vornherein **rechteckig und rein numerisch** ist und sich mit den Regeln der linearen Algebra (Matrixmultiplikation, Transposition) verrechnen lässt: die **Matrix**.
::: {.r-exkurs}
**R-Exkurs: Matrizen in R**
Eine Matrix wird mit `matrix()` erzeugt. Der Vektor mit den Werten wird dabei zeilen- oder spaltenweise in die gewünschte Form gebracht; `byrow = TRUE` sorgt dafür, dass die Werte zeilenweise (statt der R-Standardreihenfolge spaltenweise) eingefüllt werden. Mit `dimnames` lassen sich Zeilen- und Spaltennamen vergeben. Einzelne Elemente, ganze Zeilen oder Spalten werden über die eckige Klammer mit zwei Indizes `[Zeile, Spalte]` angesprochen – ein leerer Index steht dabei für "alle":
```{r}
#| label: ch4-matrix-exkurs
#| echo: true
# 3x3-Matrix mit Zeilen- und Spaltennamen erzeugen: paarweiser Vergleich
# der drei Kandidatenstandorte im Hinblick auf das Kriterium Transportnaehe
m <- matrix(
  c(1,   2,   1/2,
    1/2, 1,   1/3,
    2,   3,   1),
  nrow = 3, byrow = TRUE,
  dimnames = list(c("WI-Erb", "MZ-Hech", "Raunheim"), c("WI-Erb", "MZ-Hech", "Raunheim"))
)
m
# Einzelnes Element: Zeile 1, Spalte 2 -> "Wie stark wird WI-Erb ggue. MZ-Hech bevorzugt?"
m[1, 2]
# Gesamte 2. Zeile: Vergleich von MZ-Hech mit allen drei Standorten
m[2, ]
# Dimensionen der Matrix (Zeilen, Spalten)
dim(m)
```
Für zwei Matrizen `X` (Dimension $m \times n$) und `Y` (Dimension $n \times p$) berechnet der Operator `%*%` das **Matrixprodukt** $X\,Y$ (Dimension $m \times p$) im Sinne der linearen Algebra – anders als `X * Y`, das nur elementweise multipliziert. Wir nutzen `%*%` weiter unten gleich zweimal: einmal, um eine Distanzmatrix mit einem Nachfragevektor zu verrechnen, und einmal, um die Kriteriengewichte mit den Alternativenbewertungen zu einem AHP-Gesamt-Score zu kombinieren.
:::
Damit lassen sich die drei Paarvergleichsmatrizen aus dem Fallbeispiel unmittelbar in R nachbilden:
```{r}
#| label: ch4-ahp-matrizen
#| echo: true
# Paarvergleiche der drei Kandidatenstandorte je Kriterium (Saaty-Skala 1-9 bzw. Kehrwerte)
transportnaehe <- matrix(
  c(1,   2,   1/2,
    1/2, 1,   1/3,
    2,   3,   1),
  nrow = 3, byrow = TRUE,
  dimnames = list(c("WI-Erb", "MZ-Hech", "Raunheim"), c("WI-Erb", "MZ-Hech", "Raunheim"))
)

mietkosten <- matrix(
  c(1,   2,   4,
    1/2, 1,   2,
    1/4, 1/2, 1),
  nrow = 3, byrow = TRUE,
  dimnames = list(c("WI-Erb", "MZ-Hech", "Raunheim"), c("WI-Erb", "MZ-Hech", "Raunheim"))
)

fachkraefte <- matrix(
  c(1,   1/7, 2,
    7,   1,   5,
    1/2, 1/5, 1),
  nrow = 3, byrow = TRUE,
  dimnames = list(c("WI-Erb", "MZ-Hech", "Raunheim"), c("WI-Erb", "MZ-Hech", "Raunheim"))
)
```
Die Matrix `mietkosten` spiegelt dabei unmittelbar die Fixkosten der drei Grundstücke wider (180.000 € / 210.000 € / 260.000 €): Wiesbaden-Erbenheim wird gegenüber Raunheim mit dem Wert 4 klar bevorzugt. Aus jeder dieser drei Matrizen liefert `ahp_priority_vector()` aus `R/scm_functions.R` den zugehörigen Prioritätsvektor (die relativen Standortpräferenzen je Kriterium). Anstatt die Funktion dreimal einzeln aufzurufen, bündeln wir die drei Matrizen in einer **Liste** und wenden die Funktion mit `sapply()` auf jedes Listenelement an.
::: {.r-exkurs}
**R-Exkurs: `sapply()` und `apply()`**
`sapply(X, FUN)` wendet eine Funktion `FUN` auf jedes Element von `X` an und vereinfacht ("simplify") das Ergebnis, wo möglich, zu einem Vektor oder einer Matrix. Ist `X` – wie hier – eine **Liste von Matrizen** und liefert `FUN` für jedes Element einen Vektor gleicher Länge zurück, entsteht als Ergebnis eine Matrix, in der jede Spalte einem Listenelement entspricht. `sapply()` erspart damit eine manuell geschriebene Schleife, wenn dieselbe Funktion wiederholt auf mehrere Objekte angewendet werden soll.
Eng verwandt ist `apply(X, MARGIN, FUN)`, das eine Funktion zeilenweise (`MARGIN = 1`) oder spaltenweise (`MARGIN = 2`) auf eine **einzelne** Matrix anwendet. Intern nutzt `ahp_priority_vector()` genau dieses Muster, um für jede Zeile einer Paarvergleichsmatrix das geometrische Mittel zu berechnen – eine gängige, numerisch stabile Näherung an die eigentlich exakte Eigenvektor-Methode.
```{r}
#| label: ch4-ahp-sapply
#| echo: true
# Liste aller drei Kriterienmatrizen
kriterien_matrizen <- list(
  Transportnaehe = transportnaehe,
  Mietkosten     = mietkosten,
  Fachkraefte    = fachkraefte
)

# sapply() wendet ahp_priority_vector() auf jede Matrix der Liste an und
# liefert die drei Praeferenzvektoren als gemeinsame Matrix (Standorte x Kriterien) zurueck
praeferenz_matrix <- sapply(kriterien_matrizen, ahp_priority_vector)
praeferenz_matrix
```
:::
Die Tabelle `praeferenz_matrix` zeigt: Raunheim dominiert klar bei der Transportnähe (ca. 54 %), Wiesbaden-Erbenheim bei den Mietkosten (ca. 57 %), Mainz-Hechtsheim sehr deutlich bei der Fachkräfteverfügbarkeit (ca. 74 %) – die drei Standorte spielen also, wie schon in der Nutzwertanalyse, jeweils eine unterschiedliche Stärke aus. Damit ist Schritt 2 des AHP (Synthese je Kriterium) abgeschlossen; es fehlt noch das Ranking der drei Kriterien selbst (Schritt 3 und 4), wofür wiederum eine Paarvergleichsmatrix – diesmal zwischen den Kriterien statt zwischen den Standorten – benötigt wird.
```{r}
#| label: ch4-ahp-kriterien
#| echo: true
# Paarweiser Vergleich der drei Bewertungskriterien untereinander
kriterien_vergleich <- matrix(
  c(1,   3,   2,
    1/3, 1,   1/5,
    1/2, 5,   1),
  nrow = 3, byrow = TRUE,
  dimnames = list(
    c("Transportnaehe", "Mietkosten", "Fachkraefte"),
    c("Transportnaehe", "Mietkosten", "Fachkraefte")
  )
)

kriterien_gewichte <- ahp_priority_vector(kriterien_vergleich)
kriterien_gewichte
```
Transportnähe erhält mit rund `r sprintf("%.0f", kriterien_gewichte["Transportnaehe"]*100)` % das mit Abstand höchste Gewicht, gefolgt von Fachkräfteverfügbarkeit (ca. `r sprintf("%.0f", kriterien_gewichte["Fachkraefte"]*100)` %); Mietkosten spielen mit rund `r sprintf("%.0f", kriterien_gewichte["Mietkosten"]*100)` % eine vergleichsweise untergeordnete Rolle. Bevor wir diese Gewichte weiterverwenden, prüfen wir, ob die zugrundeliegende Paarvergleichsmatrix überhaupt **konsistent** genug ist, um belastbare Schlüsse zuzulassen. Konsistenz bedeutet dabei **Transitivität der Intensitäten**: Wer Transportnähe dreimal so wichtig findet wie Mietkosten ($a_{TM}=3$) und Fachkräfte fünfmal so wichtig wie Mietkosten ($a_{FM}=5$), müsste Transportnähe folgerichtig nur $3/5 = 0{,}6$-mal so wichtig finden wie Fachkräfte. Tatsächlich wurde aber $a_{TF}=2$ angegeben – Transportnähe also doppelt so wichtig wie Fachkräfte. Eine perfekt konsistente Matrix erfüllt $a_{ik} = a_{ij}\cdot a_{jk}$ für alle $i,j,k$; je stärker diese Bedingung verletzt ist, desto größer wird der größte Eigenwert der Matrix gegenüber $n$. Formal wird dazu der **Konsistenzindex**
$$
CI = \frac{\bar{\lambda} - n}{n - 1}
$$
berechnet, wobei $n$ die Anzahl der Kriterien und $\bar{\lambda}$ der (approximierte) größte Eigenwert der Matrix ist, den man erhält, indem man das Produkt aus Matrix und Prioritätsvektor komponentenweise durch den Prioritätsvektor teilt und den Durchschnitt bildet. Bezogen auf einen zufällig erzeugten **Random Index** $RI$ (tabelliert nach Saaty in Abhängigkeit von $n$) ergibt sich die **Konsistenzrate**
$$
CR = \frac{CI}{RI}.
$$
Als Faustregel gilt eine Matrix bei $CR < 0{,}10$ als hinreichend konsistent; bei größeren Werten sollten die paarweisen Vergleiche überarbeitet werden.
```{r}
#| label: ch4-ahp-konsistenz
#| echo: true
konsistenz <- ahp_consistency(kriterien_vergleich, kriterien_gewichte)
konsistenz
```
Mit $CI \approx `r sprintf("%.3f", konsistenz$CI)`$ und $CR \approx `r sprintf("%.2f", konsistenz$CR)`$ liegt die Kriterienmatrix **über** der 10-%-Schwelle. Die oben beschriebene Intransitivität zwischen Transportnähe, Fachkräften und Mietkosten ist also zu groß, als dass man die Gewichte ungeprüft übernehmen sollte. In der Praxis würde man die Entscheider bitten, ihre Vergleiche zu überdenken – etwa den Vergleich Transportnähe gegenüber Fachkräften von 2 auf 1/2 zu korrigieren, was die Matrix nahezu konsistent machen würde. Für das Lehrbeispiel rechnen wir mit den Originalurteilen der Vorlesung weiter, behalten diesen Vorbehalt aber im Hinterkopf: Er zeigt gerade den Nutzen des AHP, der Inkonsistenzen – anders als die Nutzwertanalyse – überhaupt sichtbar macht.
::: {.callout-note}
## Hinweis: Konsistenzindex und Konsistenzrate
Auf den Folien heißt der Konsistenzindex $KI$ (hier $KI = CI$). Ein kleiner Konsistenzindex allein genügt nicht für das Urteil „konsistent“: Er wird erst durch den Random Index $RI$ geteilt (für $n=3$: $RI = 0{,}58$), und die resultierende Konsistenzrate wird mit der 10-%-Schwelle verglichen. Im Beispiel ergibt sich aus $CI \approx 0{,}08$ die Konsistenzrate $CR \approx 0{,}14 > 0{,}1$.
:::
Im letzten Schritt werden die Standort-Kriterien-Matrix und der Kriteriengewichtsvektor mit dem Matrixprodukt `%*%` zu einem **Gesamt-Score je Standort** verrechnet – genau die Operation, die im R-Exkurs zu Matrizen angekündigt wurde:
```{r}
#| label: ch4-ahp-scores
#| echo: true
scores <- praeferenz_matrix %*% kriterien_gewichte
scores
```
**Mainz-Hechtsheim** erzielt mit einem Score von rund `r sprintf("%.3f", scores["MZ-Hech", 1])` den höchsten Wert, vor Raunheim (`r sprintf("%.3f", scores["Raunheim", 1])`) und Wiesbaden-Erbenheim (`r sprintf("%.3f", scores["WI-Erb", 1])`). Das Ergebnis ist auf den ersten Blick überraschend, denn das mit Abstand höchste Kriteriengewicht hat die Transportnähe, bei der Raunheim klar führt. Ausschlaggebend ist die **Stärke** der Präferenz bei den Fachkräften: Mainz-Hechtsheim wird dort gegenüber Wiesbaden-Erbenheim als "stark bevorzugt" (7) eingestuft und erhält rund 74 % des Kriteriengewichts – bei einem Kriteriengewicht der Fachkräfte von rund 38 % reicht das, um den Rückstand bei der Transportnähe mehr als auszugleichen. Der Vorsprung vor Raunheim ist allerdings knapp, und angesichts der festgestellten Inkonsistenz der Kriterienmatrix wäre eine Sensitivitätsanalyse der Gewichte (siehe Kontrollfragen) vor einer endgültigen Empfehlung angebracht.
Im Vergleich zur Nutzwertanalyse hat der AHP zwei wesentliche Vorzüge: Erstens erhöht das paarweise Vergleichen die Transparenz, weil Entscheider jeweils nur zwei Elemente statt eines vollständigen Rankings gegeneinander abwägen müssen. Zweitens bietet der AHP der Voreingenommenheit einzelner Bewertungen weniger Angriffsfläche als die NWA, weil sich irrationale bzw. widersprüchliche Urteile über den Konsistenzindex explizit aufdecken lassen – ein Diagnosewerkzeug, das der Nutzwertanalyse fehlt und das im Fallbeispiel tatsächlich anschlägt. Ob sich die qualitative Empfehlung zugunsten von Mainz-Hechtsheim auch bei einer rein quantitativen Kostenbetrachtung bestätigt, ist an dieser Stelle bewusst offen – wir kommen am Ende dieses Kapitels und dann noch einmal ausführlich in Kapitel [-@sec-standort-2] darauf zurück.
::: {.vertiefung}
**Theorie-Vertiefung: Warum der Eigenvektor? – Die Rechenwege des AHP**
Die Idee des AHP [@saaty1980analytic] lässt sich am besten vom Idealfall her verstehen. Angenommen, die "wahren" Gewichte der Alternativen seien $w_1,\dots,w_n$ und der Entscheider urteile fehlerfrei. Dann gäbe er als Paarvergleich genau die Verhältnisse $a_{ij} = w_i/w_j$ an. Multipliziert man eine solche Matrix mit dem Gewichtsvektor, erhält man
$$
(A\,w)_i = \sum_{j=1}^n \frac{w_i}{w_j}\, w_j = n\, w_i \qquad\Longleftrightarrow\qquad A\,w = n\,w .
$$
Der Gewichtsvektor ist also ein **Eigenvektor** der Paarvergleichsmatrix zum Eigenwert $n$. Weil die Matrix in diesem Idealfall den Rang 1 hat, sind alle übrigen Eigenwerte null, und $n$ ist der größte Eigenwert $\lambda_{\max}$. Reale Urteile sind nicht perfekt konsistent; dann ist $\lambda_{\max} > n$, und Saaty schlägt vor, den zum größten Eigenwert gehörenden Eigenvektor als "bestmöglichen" Gewichtsvektor zu verwenden. Die Abweichung $\lambda_{\max} - n$ misst zugleich, wie stark die Urteile vom konsistenten Idealfall abweichen – daraus leitet sich der Konsistenzindex $CI = (\lambda_{\max}-n)/(n-1)$ ab. Der Random Index $RI$ ist der durchschnittliche $CI$-Wert zufällig ausgefüllter reziproker Matrizen gleicher Größe; die Konsistenzrate $CR = CI/RI$ vergleicht die beobachtete Inkonsistenz also mit der eines "würfelnden" Entscheiders.
In der Praxis wird der Eigenvektor häufig **approximiert**. Zwei Verfahren sind verbreitet:
1. **Spaltennormierung und Zeilenmittel** (Rechenweg der Vorlesungsfolien): Jede Spalte wird durch ihre Spaltensumme geteilt, anschließend wird über jede Zeile gemittelt. Im konsistenten Fall ist jede normierte Spalte bereits exakt der Gewichtsvektor, das Mitteln gleicht bei Inkonsistenz die Abweichungen aus.
2. **Geometrisches Zeilenmittel** (verwendet in `ahp_priority_vector()`): Für jede Zeile wird $\left(\prod_j a_{ij}\right)^{1/n}$ gebildet und anschließend normiert. Auch dieses Verfahren liefert im konsistenten Fall exakt $w$ und ist zudem invariant gegenüber der Transposition (Kehrwertbildung) der Urteile.
Bei nahezu konsistenten Matrizen liefern beide Verfahren und der exakte Eigenvektor praktisch identische Werte; bei stärkeren Inkonsistenzen weichen sie in der dritten Nachkommastelle voneinander ab. Der folgende Code rechnet den Weg der Folien für die Kriterienmatrix nach und vergleicht ihn mit dem geometrischen Mittel und dem exakten Eigenvektor, den `eigen()` liefert:
```{r}
#| label: ch4-ahp-rechenwege
# 1) Spaltennormierung und Zeilenmittel (Rechenweg der Folien)
spalten_normiert <- sweep(kriterien_vergleich, 2, colSums(kriterien_vergleich), "/")
w_spalten <- rowMeans(spalten_normiert)

# 2) Geometrisches Zeilenmittel (ahp_priority_vector)
w_geo <- ahp_priority_vector(kriterien_vergleich)

# 3) Exakter Eigenvektor zum groessten Eigenwert
ev    <- eigen(kriterien_vergleich)
w_eig <- Re(ev$vectors[, 1]) / sum(Re(ev$vectors[, 1]))

round(cbind(Spaltennormierung = w_spalten, Geometrisch = w_geo, Eigenvektor = w_eig), 3)
Re(ev$values[1]) # groesster Eigenwert lambda_max (> n = 3 wegen Inkonsistenz)
```
:::
## Kontinuierliche Standortplanung: das Steiner-Weber-Modell
Sowohl die Nutzwertanalyse als auch der AHP setzen voraus, dass bereits eine **überschaubare Menge diskreter Alternativen** vorliegt, zwischen denen zu wählen ist – bei SushiFresh die drei konkret verfügbaren Gewerbegrundstücke. Häufig stellt sich die Standortfrage jedoch anders: Gesucht ist nicht die beste unter mehreren vorgegebenen Adressen, sondern **derjenige Punkt in der Ebene**, der die Transportkosten zu einer Menge von Kundenstandorten minimiert – bei SushiFresh also derjenige Punkt im Rhein-Main-Gebiet, der die Gesamtdistanz zu den sechs Filialen minimiert, unabhängig davon, ob dort überhaupt ein Grundstück verfügbar ist. Diese Fragestellung behandelt die **kontinuierliche Standortplanung**, deren klassisches Modell auf Alfred Weber zurückgeht und in der Literatur meist als **Steiner-Weber-Modell** bezeichnet wird [@cooper1968locational; @thonemann2023operations].
Das Modell trifft vier vereinfachende Annahmen: Es gibt eine homogene Ebene (das Absatzgebiet), in der endlich viele Kundenstandorte liegen; für jeden Kundenstandort ist eine Nachfragemenge gegeben, die vollständig zu bedienen ist; die Transportkosten hängen linear von Entfernung und transportierter Menge ab; und die zeitliche Dimension wird ausgeblendet. Unter diesen Annahmen lautet die Zielfunktion
$$
\min_{(x,y)}\; Z(x,y) = \sum_{i=1}^{n} a_i \cdot d\big((x,y),(u_i,v_i)\big),
$$
wobei $(x,y)$ die gesuchten Koordinaten des neuen Standorts sind, $(u_i, v_i)$ die Koordinaten von Kundenstandort $i$, $a_i$ dessen Nachfrage (bei SushiFresh: Boxen pro Tag) und $d(\cdot)$ ein noch zu wählendes **Distanzmaß**.
Die Wahl von $d(\cdot)$ ist keineswegs nebensächlich, sondern bestimmt sowohl die Rechenmethode als auch das Ergebnis. Für Standorte innerhalb eines Landes oder einer Region, in der Transportwege näherungsweise "als Krähe fliegt" verlaufen, eignet sich die **euklidische Distanz**
$$
d^{\text{eukl}}\big((x,y),(u_i,v_i)\big) = \sqrt{(x-u_i)^2 + (y-v_i)^2}.
$$
In Innenstädten mit rechtwinkligem Straßenraster oder bei innerbetrieblichen Transporten entlang orthogonaler Gänge ist die **Manhattan-Distanz** (auch Rechtwinkel- oder $L_1$-Distanz) oft realistischer:
$$
d^{\text{man}}\big((x,y),(u_i,v_i)\big) = |x-u_i| + |y-v_i|.
$$
Für die tatsächliche Netzplanung wiederum sind **Straßendistanzen** – die kürzesten Wege in einem realen Verkehrsnetz – am genauesten, aber auch am aufwendigsten zu berechnen, da sie ein digitales Straßennetz sowie einen Routing-Dienst voraussetzen. Der folgende Code zeigt beispielhaft, wie sich diese drei Distanzmaße zwischen dem Kandidatenstandort Wiesbaden-Erbenheim und der Filiale Frankfurt mit den Paketen `sf`, `osrm` und `leaflet` berechnen und auf einer interaktiven Karte vergleichen lassen. Da die Straßendistanz einen Online-Routing-Dienst (OSRM) sowie den Abruf von Kartenkacheln voraussetzt, ist der Chunk mit `eval: false` versehen und wird beim Rendern nicht ausgeführt.
```{r}
#| label: ch4-distanzen-karte
#| echo: true
#| eval: false
# Hinweis: Dieser Chunk benoetigt Internetzugang (OpenStreetMap-Kartenkacheln
# und den OSRM-Routing-Dienst fuer die Strassendistanz) und wird daher beim
# Rendern des Buchs nicht ausgefuehrt (eval: false) - er dient nur der
# Illustration, wie man die drei Distanzmasse in der Praxis vergleicht.

library(sf)
library(osrm)
library(leaflet)

standort_wi <- st_as_sf(data.frame(id = "Wiesbaden-Erbenheim", lon = 8.2999, lat = 50.0632),
                         coords = c("lon", "lat"), crs = 4326)
filiale_ffm <- st_as_sf(data.frame(id = "Frankfurt", lon = 8.6821, lat = 50.1109),
                         coords = c("lon", "lat"), crs = 4326)

# Kuerzester Weg im realen Strassennetz ueber den OSRM-Dienst
route <- osrmRoute(src = standort_wi, dst = filiale_ffm)

# Interaktive Karte: Strassenroute in Rot, Standort/Filiale als Marker
leaflet() |>
  addProviderTiles(providers$OpenStreetMap.Mapnik) |>
  addPolylines(data = route, color = "red") |>
  addCircleMarkers(data = standort_wi, color = "black") |>
  addCircleMarkers(data = filiale_ffm, color = "purple")
```
In der Praxis liegt die Straßendistanz zwischen zwei Punkten fast immer über der euklidischen und meist auch über der Manhattan-Distanz, da reale Straßennetze weder geradlinig noch streng orthogonal verlaufen. Für die folgenden Herleitungen beschränken wir uns – wie es die Literatur zum Steiner-Weber-Modell überwiegend tut – auf euklidische und Manhattan-Distanzen, weil sich für beide geschlossene bzw. effizient iterative Lösungsverfahren angeben lassen [@daskin2013network; @drezner2002facility].
Für die numerischen Beispiele dieses Abschnitts verwenden wir durchgängig den bereits eingeführten SushiFresh-Datensatz mit den sechs Filialen. Da Center of Gravity und Weiszfeld-Algorithmus ursprünglich für **ebene** (kartesische) Koordinaten hergeleitet sind, behandeln wir Längen- und Breitengrad hier zunächst näherungsweise als planare $x$-/$y$-Koordinaten ($x = $ Längengrad, $y = $ Breitengrad) – eine bewusste didaktische Vereinfachung, deren Grenzen wir am Ende dieses Abschnitts mit der Haversine-Formel explizit sichtbar machen.
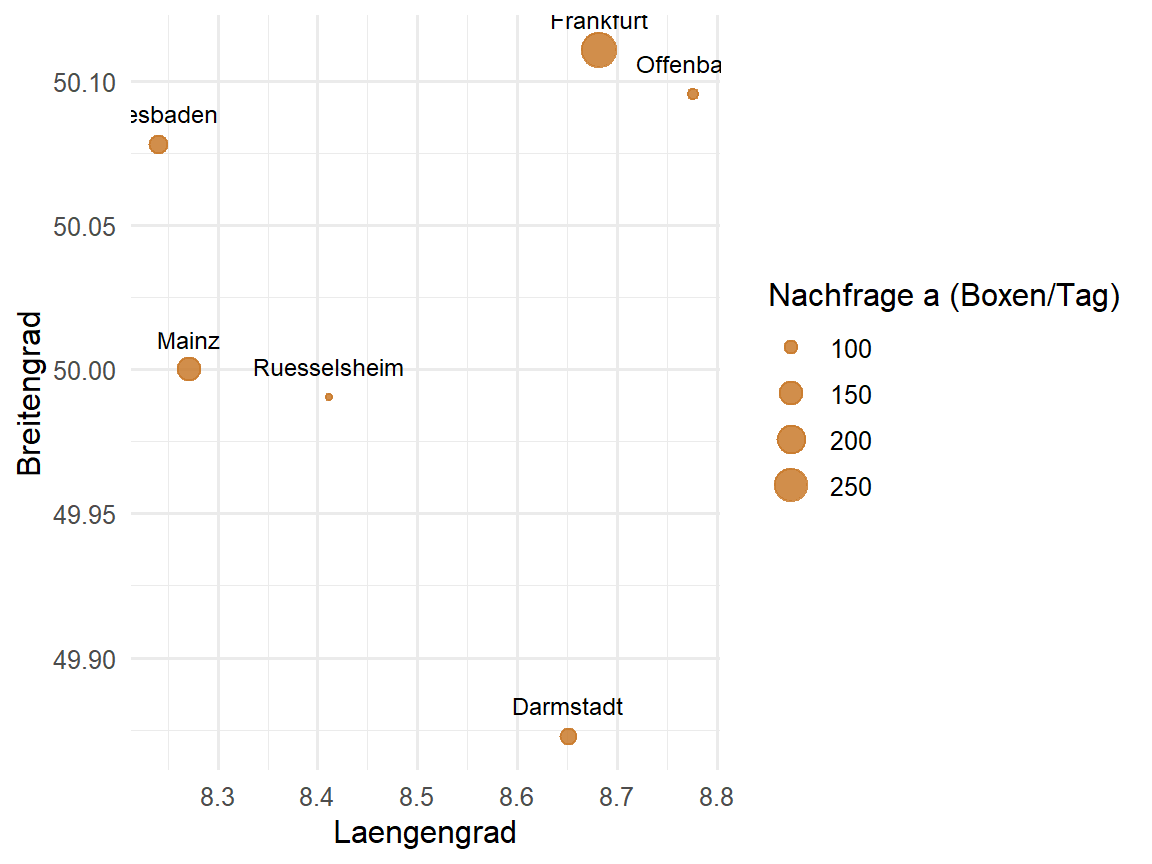
```{r}
#| label: ch4-filialen-plot
#| echo: true
#| fig-width: 6
#| fig-height: 4.5
#| fig-align: center
# Blasendiagramm: Position = Filiale, Blasengroesse = Nachfrage
ggplot(filialen, aes(x = lon, y = lat)) +
  geom_point(aes(size = mu), color = "#c97a2b", alpha = 0.85) +
  geom_text(aes(label = Filiale), vjust = -1.2, size = 3.2) +
  labs(x = "Laengengrad", y = "Breitengrad", size = "Nachfrage a (Boxen/Tag)") +
  theme_minimal(base_size = 12)
```
### Center of Gravity: die quadratische Näherung
Der einfachste Zugang zum Steiner-Weber-Problem ergibt sich, wenn man in der Zielfunktion nicht die (nicht differenzierbare) euklidische Distanz selbst, sondern ihr **Quadrat** minimiert:
$$
\min_{(x,y)}\; \tilde{Z}(x,y) = \sum_{i=1}^{n} a_i \left[(x-u_i)^2 + (y-v_i)^2\right].
$$
Diese Zielfunktion ist in $x$ und $y$ separierbar und überall differenzierbar, sodass sich das Minimum direkt über die notwendigen Optimalitätsbedingungen bestimmen lässt. Die partielle Ableitung nach $x$ lautet
$$
\frac{\partial \tilde{Z}}{\partial x} = \sum_{i=1}^{n} 2\,a_i\,(x - u_i) \stackrel{!}{=} 0
\quad\Longleftrightarrow\quad
x \sum_{i=1}^{n} a_i = \sum_{i=1}^{n} a_i\, u_i,
$$
und analog für $y$. Aufgelöst nach $x$ bzw. $y$ ergibt sich das **Center of Gravity (CoG)**:
::: {.definition}
**Definition: Center of Gravity**
$$
x^{CoG} = \frac{\displaystyle\sum_{i=1}^{n} a_i\, u_i}{\displaystyle\sum_{i=1}^{n} a_i},
\qquad
y^{CoG} = \frac{\displaystyle\sum_{i=1}^{n} a_i\, v_i}{\displaystyle\sum_{i=1}^{n} a_i}.
$$
Das Center of Gravity ist der **nachfragegewichtete Schwerpunkt** aller Kundenstandorte und minimiert die Summe der gewichteten *quadrierten* euklidischen Distanzen.
:::
Da diese Herleitung im Kern nur aus drei Rechenschritten besteht – Gesamtnachfrage bilden, gewichtete Koordinatensummen bilden, dividieren –, lässt sie sich unmittelbar und ohne Hilfsmittel in R nachvollziehen:
```{r}
#| label: ch4-cog-manual
#| echo: true
# Schritt 1: Gesamtnachfrage ueber alle Filialen aufsummieren
gesamtnachfrage <- sum(filialen$mu)

# Schritt 2: nachfragegewichtete Summe von Laengen- und Breitengrad bilden
gewichtete_summe_lon <- sum(filialen$mu * filialen$lon)
gewichtete_summe_lat <- sum(filialen$mu * filialen$lat)

# Schritt 3: Division durch die Gesamtnachfrage liefert den Schwerpunkt
cog_lon <- gewichtete_summe_lon / gesamtnachfrage
cog_lat <- gewichtete_summe_lat / gesamtnachfrage

c(lon = cog_lon, lat = cog_lat)
```
Zur Kontrolle liefert die fertige Funktion `center_of_gravity()` aus `R/scm_functions.R` – die dieselbe Rechnung kapselt, aber ein `data.frame` mit Spalten `x`, `y`, `demand` erwartet – dasselbe Ergebnis:
```{r}
#| label: ch4-cog-check
#| echo: true
center_of_gravity(data.frame(x = filialen$lon, y = filialen$lat, demand = filialen$mu))
```
Das Center of Gravity liegt bei $(x^{CoG}, y^{CoG}) \approx (`r sprintf("%.4f", cog_lon)`; `r sprintf("%.4f", cog_lat)`)$ – geografisch ungefähr zwischen Frankfurt und Rüsselsheim, deutlich östlich der drei Kandidatenstandorte. Es ist attraktiv, weil es sich **ohne Iteration** in geschlossener Form berechnen lässt. Es löst aber, genau genommen, nicht das ursprüngliche Steiner-Weber-Problem, sondern nur dessen quadrierte Variante – und die beiden Optima müssen nicht identisch sein. Insbesondere reagiert das CoG empfindlicher auf weit entfernte Ausreißer-Kunden, weil quadrierte Distanzen große Abstände überproportional stark gewichten. Für die *tatsächliche*, nicht quadrierte Zielfunktion braucht es ein anderes Verfahren.
### Der Weiszfeld-Algorithmus: iterative Lösung des echten Problems
Um das ursprüngliche Problem mit linearen (nicht quadrierten) euklidischen Distanzen zu lösen, bilden wir erneut die notwendige Optimalitätsbedingung, diesmal für
$$
Z(x,y) = \sum_{i=1}^{n} a_i \sqrt{(x-u_i)^2+(y-v_i)^2}.
$$
Die partielle Ableitung nach $x$ ist
$$
\frac{\partial Z}{\partial x} = \sum_{i=1}^{n} a_i\, \frac{x - u_i}{d_i(x,y)} \stackrel{!}{=} 0,
\qquad d_i(x,y) = \sqrt{(x-u_i)^2+(y-v_i)^2}.
$$
Anders als bei der quadrierten Zielfunktion taucht $x$ hier auch im Nenner (über $d_i$) auf, sodass sich die Gleichung **nicht** direkt nach $x$ auflösen lässt. Der Ausweg besteht darin, die $d_i$ in einem gegebenen Iterationsschritt als *bekannt* (nämlich aus der vorherigen Iteration) zu behandeln und die Gleichung dann nach $x$ aufzulösen. Mit der Abkürzung
$$
g_i(x,y) = \frac{a_i}{d_i(x,y)}
$$
ergibt sich die **Update-Regel des Weiszfeld-Algorithmus**:
$$
x_{t+1} = \frac{\displaystyle\sum_{i=1}^n u_i\, g_i(x_t,y_t)}{\displaystyle\sum_{i=1}^n g_i(x_t,y_t)},
\qquad
y_{t+1} = \frac{\displaystyle\sum_{i=1}^n v_i\, g_i(x_t,y_t)}{\displaystyle\sum_{i=1}^n g_i(x_t,y_t)}.
$$
Bemerkenswert ist, dass diese Update-Regel formal wie ein Center-of-Gravity-Update aussieht – nur dass anstelle der festen Nachfragegewichte $a_i$ die *iterationsabhängigen* Gewichte $g_i(x_t,y_t)$ verwendet werden. Kunden, die **nahe** am aktuellen Standort liegen und eine **hohe** Nachfrage haben, erhalten dabei ein hohes Gewicht $g_i$ und ziehen den nächsten Standort stärker in ihre Richtung. Man beginnt sinnvollerweise mit dem Center of Gravity als Startlösung $(x_0,y_0)$ und wiederholt die Update-Regel so lange, bis sich die Position von einer Iteration zur nächsten kaum noch ändert.
Um diesen iterativen Ablauf in R zu programmieren, benötigen wir eine Kontrollstruktur, die einen Rechenblock mehrfach wiederholt: die **Schleife**.
::: {.r-exkurs}
**R-Exkurs: `for`- und `while`-Schleifen**
Eine `for`-Schleife wiederholt einen Codeblock für jedes Element eines Vektors – sie eignet sich, wenn die **Anzahl der Durchläufe von vornherein bekannt** ist (z. B. "einmal je Kandidatenstandort"):
```{r}
#| label: ch4-loop-exkurs
#| echo: true
# for-Schleife: fester Durchlauf ueber eine bekannte Anzahl von Werten -
# hier ueber die drei Kandidatenstandorte
for (i in seq_len(nrow(standorte))) {
  cat("Standort:", standorte$Standort[i],
      "- Fixkosten:", standorte$Fixkosten[i], "EUR/Jahr\n")
}
# while-Schleife: Wiederholung, solange eine Bedingung erfuellt ist -
# die Anzahl der Durchlaeufe steht vorab nicht fest
schritt <- 1
wert <- 100
while (wert > 1) {
  wert <- wert / 2      # Wert in jedem Schritt halbieren
  schritt <- schritt + 1
}
cat("Nach", schritt, "Schritten liegt der Wert unter 1:", round(wert, 4), "\n")
```
Eine `while`-Schleife prüft vor jedem Durchlauf eine logische Bedingung und wiederholt den Codeblock, solange diese `TRUE` ist – sie passt daher besser, wenn **nicht im Voraus feststeht**, wie viele Schritte nötig sind, sondern nur, *wann* abgebrochen werden soll. Genau diese Situation liegt beim Weiszfeld-Algorithmus vor: Wir wissen nicht im Voraus, nach wie vielen Iterationen die Lösung hinreichend konvergiert ist. In der Praxis kombiniert man daher meist beide Prinzipien: eine `for`-Schleife mit einer festen *Obergrenze* an Iterationen als Sicherheitsnetz, kombiniert mit einem `if`-Abbruch (`break` bzw. `return`), sobald das eigentliche Konvergenzkriterium erfüllt ist. Das folgende R-Exkurs zeigt, wie sich ein solches Muster in eine eigene Funktion verpacken lässt.
:::
::: {.r-exkurs}
**R-Exkurs: eine Funktion mit mehreren Parametern und Kontrollfluss**
Bislang haben wir in diesem Buch vor allem Funktionen mit ein oder zwei Argumenten geschrieben. Iterative Verfahren wie Weiszfeld benötigen dagegen typischerweise mehrere Parameter: die Eingabedaten, einen optionalen Startwert, eine Toleranzschwelle für das Abbruchkriterium und eine maximale Anzahl an Iterationen als Sicherheitsnetz, falls die Toleranz nie unterschritten wird. Solche optionalen Parameter erhalten in der Funktionsdefinition einen **Standardwert** (z. B. `tol = 1e-6`), der nur überschrieben wird, wenn beim Aufruf explizit ein anderer Wert übergeben wird.
```{r}
#| label: ch4-weiszfeld-function
#| echo: true
weiszfeld_manual <- function(daten, x0 = NULL, y0 = NULL,
                              tol = 1e-6, max_iter = 100) {
  # daten:    data.frame mit Spalten u, v (Koordinaten) und a (Nachfrage)
  # x0, y0:   Startkoordinaten; falls NULL wird das Center of Gravity verwendet
  # tol:      Toleranzschwelle fuer das Abbruchkriterium (Konvergenz)
  # max_iter: maximale Anzahl an Iterationen als Sicherheitsnetz

  # Ohne Vorgabe: Center of Gravity als Startloesung verwenden
  if (is.null(x0)) x0 <- sum(daten$a * daten$u) / sum(daten$a)
  if (is.null(y0)) y0 <- sum(daten$a * daten$v) / sum(daten$a)

  x <- x0
  y <- y0

  # for-Schleife mit fester Obergrenze max_iter als Sicherheitsnetz
  for (t in 1:max_iter) {

    # Distanz vom aktuellen Standort (x,y) zu jeder Filiale
    d <- sqrt((x - daten$u)^2 + (y - daten$v)^2)

    # Division durch 0 vermeiden, falls der Standort exakt auf einer Filiale liegt
    d[d < 1e-10] <- 1e-10

    # Iterationsgewichte g_i = a_i / d_i gemaess Weiszfeld-Update-Regel
    g <- daten$a / d

    # aktualisierte Koordinaten als gewichtetes Mittel mit Gewichten g_i
    x_neu <- sum(daten$u * g) / sum(g)
    y_neu <- sum(daten$v * g) / sum(g)

    # zurueckgelegte Strecke zwischen zwei aufeinanderfolgenden Iterationen
    delta <- sqrt((x_neu - x)^2 + (y_neu - y)^2)

    x <- x_neu
    y <- y_neu

    # Kontrollfluss: Abbruch, sobald die Aenderung hinreichend klein ist
    if (delta < tol) {
      return(list(x = x, y = y, iterationen = t, konvergiert = TRUE))
    }
  }

  # Falls die Schleife ohne Konvergenz durchlaufen wurde
  list(x = x, y = y, iterationen = max_iter, konvergiert = FALSE)
}
```
Der `if`-Block im Inneren der Schleife ist der eigentliche **Kontrollfluss**: Er prüft nach jedem Iterationsschritt, ob das Abbruchkriterium erfüllt ist, und beendet die Funktion in diesem Fall vorzeitig über `return()` – andernfalls läuft die Schleife weiter, bis entweder Konvergenz eintritt oder `max_iter` erreicht ist.
:::
Wenden wir `weiszfeld_manual()` auf den SushiFresh-Filialdatensatz an (dazu übergeben wir Längengrad als `u`, Breitengrad als `v` und die Nachfrage als `a`):
```{r}
#| label: ch4-weiszfeld-run
#| echo: true
ergebnis <- weiszfeld_manual(
  data.frame(u = filialen$lon, v = filialen$lat, a = filialen$mu),
  tol = 1e-6, max_iter = 100
)
ergebnis
```
Der Algorithmus konvergiert nach `r ergebnis$iterationen` Iterationen auf den Standort $(x,y) \approx (`r sprintf("%.4f", ergebnis$x)`; `r sprintf("%.4f", ergebnis$y)`)$ – deutlich näher an Frankfurt als das Center of Gravity. Zur Kontrolle liefert die vorgefertigte Funktion `weiszfeld()` aus `R/scm_functions.R` (die intern denselben Algorithmus implementiert, zusätzlich aber den Verlauf aller Iterationen protokolliert) ein identisches Ergebnis:
```{r}
#| label: ch4-weiszfeld-check
#| echo: true
weiszfeld_check <- weiszfeld(data.frame(x = filialen$lon, y = filialen$lat, demand = filialen$mu))
c(x = weiszfeld_check$x, y = weiszfeld_check$y,
  iterationen = weiszfeld_check$iterations, konvergiert = weiszfeld_check$converged)
```
Das bestätigt die theoretische Erwartung: Das CoG ist eine schnell berechenbare, aber eben nur approximative Lösung; der iterative Weiszfeld-Algorithmus löst das eigentliche Steiner-Weber-Problem und verschiebt den Standort im Vergleich zum CoG spürbar in Richtung Frankfurt – der mit Abstand nachfragestärksten Filiale (280 von 845 Boxen/Tag). Wie stark sich das tatsächlich auf die *reale* (geografische) Distanz zu jeder einzelnen Filiale auswirkt, prüfen wir im nächsten Abschnitt mit der Haversine-Formel.
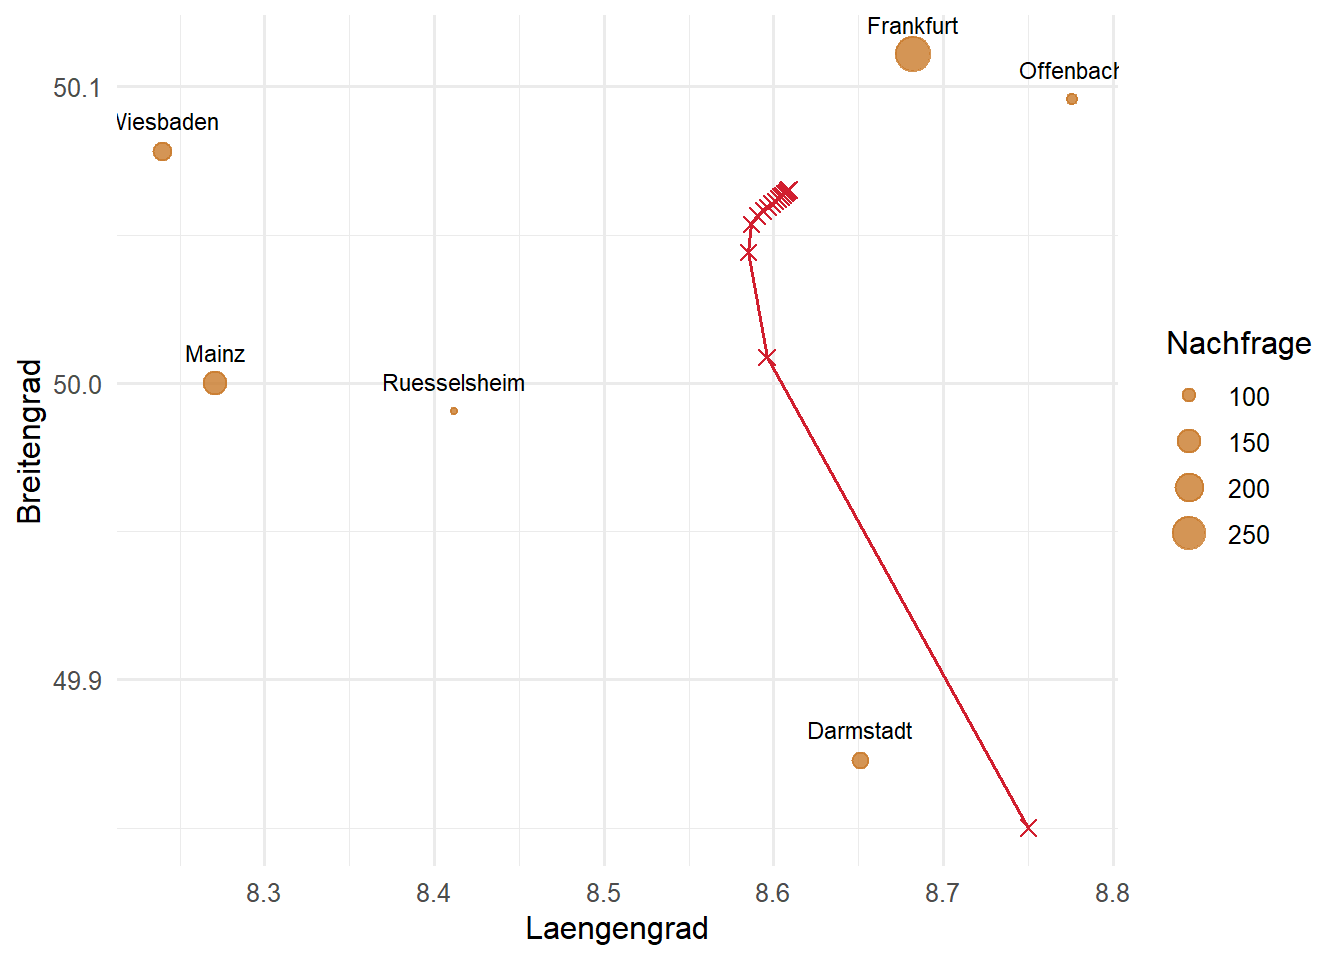
Wie der Algorithmus sich dem Optimum nähert, zeigt die Vorlesung mit einem bewusst weit entfernten Startpunkt $(x_0, y_0) = (8{,}75;\ 49{,}85)$ südöstlich von Darmstadt. Um den Weg nachzuvollziehen, protokollieren wir diesmal jede Iteration:
```{r}
#| label: ch4-weiszfeld-verlauf
#| fig-cap: "Iterationsverlauf des Weiszfeld-Algorithmus von einem entfernten Startpunkt"
daten_w <- data.frame(u = filialen$lon, v = filialen$lat, a = filialen$mu)
x <- 8.75; y <- 49.85                      # entfernter Startpunkt wie in der Vorlesung
verlauf <- tibble(t = 0, x = x, y = y)

for (t in 1:15) {
  d <- sqrt((x - daten_w$u)^2 + (y - daten_w$v)^2)
  g <- daten_w$a / d                        # Iterationsgewichte
  x <- sum(daten_w$u * g) / sum(g)
  y <- sum(daten_w$v * g) / sum(g)
  verlauf <- add_row(verlauf, t = t, x = x, y = y)
}

verlauf |>
  mutate(Schrittweite = sqrt((x - lag(x))^2 + (y - lag(y))^2)) |>
  head(6) |>
  kable(digits = 4)
ggplot(filialen, aes(lon, lat)) +
  geom_point(aes(size = mu), colour = "#c97a2b", alpha = 0.8) +
  geom_text(aes(label = Filiale), vjust = -1.2, size = 3) +
  geom_path(data = verlauf, aes(x, y), colour = "#d11f2f") +
  geom_point(data = verlauf, aes(x, y), colour = "#d11f2f", shape = 4, size = 2.5) +
  labs(x = "Laengengrad", y = "Breitengrad", size = "Nachfrage") +
  theme_minimal(base_size = 12)
```
Bereits der erste Schritt überbrückt den größten Teil der Entfernung; danach werden die Schritte rasch kleiner. Die letzten Nachkommastellen stabilisieren sich allerdings nur langsam: Bis die Toleranz von $10^{-6}$ unterschritten ist, benötigt der Algorithmus mehrere Dutzend Iterationen (siehe oben). Das ist typisch für den Weiszfeld-Algorithmus, wenn das Optimum nahe an einem nachfragestarken Kunden liegt – hier Frankfurt –, weil dessen Iterationsgewicht $g_i = a_i/d_i$ bei kleiner werdender Distanz stark wächst und die Schritte immer kürzer werden.
::: {.vertiefung}
**Theorie-Vertiefung: Warum konvergiert der Weiszfeld-Algorithmus?**
Die Zielfunktion $Z(x,y) = \sum_i a_i\, d_i(x,y)$ ist als Summe gewichteter euklidischer Normen **konvex**: Jede einzelne Distanzfunktion $d_i$ ist ein "Kegel" mit Spitze im Kundenstandort, und eine nichtnegativ gewichtete Summe konvexer Funktionen ist wieder konvex. Daraus folgt, dass jedes lokale Minimum zugleich ein globales Minimum ist — es gibt keine "Fallen", in denen ein Verfahren hängen bleiben könnte. Liegen die Kundenstandorte nicht alle auf einer Geraden, ist $Z$ sogar strikt konvex und das Optimum eindeutig.
Der Algorithmus geht auf @weiszfeld1937point zurück. Man kann zeigen, dass jeder Iterationsschritt den Zielfunktionswert **nicht erhöht**: Die Update-Regel minimiert in jedem Schritt eine quadratische Hilfsfunktion, die $Z$ im aktuellen Punkt berührt und überall oberhalb von $Z$ liegt (*Majorisierungsprinzip*). Das Minimum der Hilfsfunktion ist gerade das gewichtete Mittel mit den Gewichten $g_i = a_i/d_i$ — also die Update-Regel. Da der Zielfunktionswert monoton fällt und nach unten beschränkt ist, konvergiert das Verfahren. Eine Sonderbehandlung ist nur nötig, wenn eine Iteration exakt auf einen Kundenstandort fällt ($d_i = 0$, Division durch null); in der Praxis fängt man diesen Fall wie in `weiszfeld_manual()` durch eine kleine Untergrenze für $d_i$ ab.
Interessant ist auch die ökonomische Interpretation der Optimalitätsbedingung $\sum_i a_i (x-u_i)/d_i = 0$ (und analog für $y$): Jeder Kunde "zieht" den Standort mit einer Kraft der Stärke $a_i$ in seine Richtung, **unabhängig von seiner Entfernung**. Im Optimum heben sich alle Zugkräfte auf. Das erklärt den Unterschied zum Center of Gravity: Dort wächst die Zugkraft eines Kunden mit seiner Entfernung (Ableitung von $d_i^2$ ist $2 d_i$), sodass weit entfernte Kunden das Ergebnis überproportional beeinflussen.
:::
### Manhattan-Distanzen: der gewichtete Median
Wird statt der euklidischen die Manhattan-Distanz zugrunde gelegt, ändert sich die Struktur des Problems grundlegend – zu ihrem Vorteil. Die Zielfunktion
$$
Z(x,y) = \sum_{i=1}^n a_i \left(|x-u_i| + |y-v_i|\right)
= \underbrace{\sum_{i=1}^n a_i |x-u_i|}_{\text{hängt nur von } x \text{ ab}} \; + \; \underbrace{\sum_{i=1}^n a_i |y-v_i|}_{\text{hängt nur von } y \text{ ab}}
$$
ist additiv **separierbar** in $x$ und $y$: Die optimale $x$-Koordinate lässt sich unabhängig von der optimalen $y$-Koordinate bestimmen und umgekehrt. Für jede der beiden Teilsummen gilt ein klassisches Ergebnis der Optimierung: Die Summe gewichteter absoluter Abweichungen $\sum_i a_i |x - u_i|$ wird durch den **gewichteten Median** der $u_i$ minimiert – also durch denjenigen Wert, bei dem mindestens die Hälfte der (nach $u_i$ sortierten, kumulierten) Nachfrage erreicht ist.
::: {.definition}
**Definition: Gewichteter Median als Steiner-Weber-Lösung unter Manhattan-Distanz**
Sortiere die Kunden aufsteigend nach ihrer $u_i$-Koordinate und bestimme die kumulierte Nachfrage $A_j = \sum_{i=1}^{j} a_i$. Die optimale $x$-Koordinate ist die $u_i$-Koordinate des ersten Kunden, für den $A_j \geq \tfrac{1}{2}\sum_{i=1}^n a_i$ gilt. Für $y$ verfährt man analog mit den $v_i$-Koordinaten.
:::
Warum gerade der gewichtete Median? Man überlege sich, was passiert, wenn der Standort auf der $x$-Achse um ein kleines Stück $\Delta$ nach rechts verschoben wird. Alle Kunden links des Standorts rücken um $\Delta$ weiter weg, alle Kunden rechts davon um $\Delta$ näher heran. Die Zielfunktion ändert sich also um $\Delta \cdot (A_{\text{links}} - A_{\text{rechts}})$, wobei $A_{\text{links}}$ und $A_{\text{rechts}}$ die Nachfragesummen links und rechts des Standorts sind. Eine Verschiebung nach rechts lohnt sich, solange rechts mehr Nachfrage liegt als links. Sobald links mindestens die Hälfte der Gesamtnachfrage liegt, bringt eine weitere Verschiebung keinen Vorteil mehr — genau das ist der gewichtete Median. Bemerkenswert ist, dass dabei nur die **Reihenfolge** der Kunden auf der Achse und ihre Nachfragemengen eine Rolle spielen, nicht aber die genauen Abstände: Ein Kunde, der sehr weit entfernt liegt, verschiebt den Median nicht stärker als ein naher Kunde mit derselben Nachfrage.
```{r}
#| label: ch4-manhattan-median
#| echo: true
# Gewichteter Median: kleinster Wert, bei dem die kumulierte Nachfrage
# mindestens die Haelfte der Gesamtnachfrage erreicht
gewichteter_median <- function(werte, gewichte) {
  reihenfolge <- order(werte)          # Sortierindex (aufsteigend) ermitteln
  werte <- werte[reihenfolge]          # Werte in dieser Reihenfolge sortieren
  gewichte <- gewichte[reihenfolge]    # Gewichte im gleichen Muster mitsortieren

  kumuliert <- cumsum(gewichte)        # laufende (kumulierte) Summe der Gewichte
  schwelle <- sum(gewichte) / 2        # halbe Gesamtnachfrage

  werte[which(kumuliert >= schwelle)[1]]  # erster Wert, der die Schwelle erreicht
}

manhattan_lon <- gewichteter_median(filialen$lon, filialen$mu)
manhattan_lat <- gewichteter_median(filialen$lat, filialen$mu)
c(lon = manhattan_lon, lat = manhattan_lat)
```
Die Manhattan-Lösung $(x,y) \approx (`r sprintf("%.4f", manhattan_lon)`; `r sprintf("%.4f", manhattan_lat)`)$ übernimmt auf der $x$-Achse den Längengrad von Darmstadt und auf der $y$-Achse den Breitengrad von Wiesbaden – ein typisches Merkmal des gewichteten Medians: Er liefert auf **jeder Koordinatenachse einzeln** stets den Wert eines existierenden Kundenstandorts, muss aber, weil $x$- und $y$-Koordinate unabhängig voneinander bestimmt werden, insgesamt nicht mit einer einzigen realen Filiale zusammenfallen. Center of Gravity und Weiszfeld-Optimum fallen dagegen praktisch nie exakt mit einem Kundenstandort zusammen, da bei ihnen beide Koordinaten gemeinsam aus allen Filialen gemittelt werden. Welches Distanzmaß angemessen ist, entscheidet letztlich die reale Transportstruktur im Absatzgebiet – nicht der rechnerische Aufwand des jeweiligen Verfahrens.
## Geografische Distanzen: Realitätscheck mit der Haversine-Formel
Center of Gravity, Weiszfeld-Algorithmus und der gewichtete Median setzen implizit voraus, dass die Koordinaten $(u_i, v_i)$ **kartesische** Koordinaten in einer Ebene sind, auf der euklidische bzw. Manhattan-Distanzen sinnvoll interpretierbar sind. Wie oben angekündigt, haben wir diese Annahme im gesamten Abschnitt bewusst vereinfachend getroffen, obwohl Breiten- und Längengrad (WGS84) tatsächlich Koordinaten auf einer **gekrümmten** Erdoberfläche sind, auf der ein Grad geografischer Länge je nach Breitengrad einer unterschiedlichen Kilometerzahl entspricht. Eine naive euklidische Distanzberechnung auf Basis von Grad-Koordinaten wäre daher spätestens bei überregionalen Entfernungen irreführend – im Rhein-Main-Gebiet mit seinen kurzen Distanzen ist der Fehler zwar klein, sollte aber nicht unhinterfragt bleiben.
Für den exakten Vergleich verwendet man die **Haversine-Formel**, die den Großkreisabstand – die kürzeste Verbindung zweier Punkte auf einer Kugeloberfläche – aus geografischen Koordinaten berechnet:
::: {.definition}
**Definition: Haversine-Distanz**
Für zwei Punkte mit geografischer Breite/Länge $(\varphi_1,\lambda_1)$ und $(\varphi_2,\lambda_2)$ (im Bogenmaß) berechnet sich der Großkreisabstand als
$$
d^{\text{hav}} = 2R \cdot \arctan2\!\left(\sqrt{a},\, \sqrt{1-a}\right),
\qquad
a = \sin^2\!\left(\frac{\Delta\varphi}{2}\right) + \cos(\varphi_1)\cos(\varphi_2)\sin^2\!\left(\frac{\Delta\lambda}{2}\right),
$$
mit $R \approx 6\,371\,\text{km}$ als mittlerem Erdradius, $\Delta\varphi = \varphi_2-\varphi_1$ und $\Delta\lambda = \lambda_2-\lambda_1$.
:::
Die Funktion `haversine(lat1, lon1, lat2, lon2)` aus `R/scm_functions.R` implementiert genau diese Formel und gibt die Distanz in Kilometern zurück. Als erste Anwendung berechnen wir die Distanz zwischen dem Kandidatenstandort Wiesbaden-Erbenheim und der Filiale Frankfurt:
```{r}
#| label: ch4-haversine-beispiel
#| echo: true
haversine(50.0632, 8.2999, 50.1109, 8.6821)
```
### Distanzmatrix zwischen den Kandidatenstandorten und den Filialen
Mit derselben Funktion lässt sich die vollständige Distanzmatrix zwischen allen drei Kandidatenstandorten und allen sechs Filialen berechnen. Da `haversine()` vektorisiert ist (sie akzeptiert Vektoren gleicher Länge für `lat1`/`lon1`), können wir sie mit `sapply()` einmal je Filiale auf den kompletten Vektor der drei Standort-Koordinaten anwenden und erhalten direkt eine Matrix mit einer Zeile je Standort und einer Spalte je Filiale:
```{r}
#| label: ch4-distanzmatrix
#| echo: true
# sapply() ueber die sechs Filialen: haversine() wird je Filiale vektorisiert
# auf alle drei Standorte gleichzeitig angewendet -> 3x6-Distanzmatrix
distanzmatrix <- sapply(seq_len(nrow(filialen)), function(j) {
  haversine(standorte$lat, standorte$lon, filialen$lat[j], filialen$lon[j])
})
rownames(distanzmatrix) <- standorte$Standort
colnames(distanzmatrix) <- filialen$Filiale
round(distanzmatrix, 1)
```
Diese Distanzmatrix erlaubt es, die im AHP nur qualitativ beurteilte Transportnähe quantitativ zu untermauern. Multipliziert man die Distanzmatrix mit dem Nachfragevektor der Filialen – wieder über das Matrixprodukt `%*%` –, erhält man je Standort die nachfragegewichtete Gesamtdistanz zu allen sechs Filialen:
```{r}
#| label: ch4-distanzmatrix-gewichtet
#| echo: true
gewichtete_gesamtdistanz <- distanzmatrix %*% filialen$mu
gewichtete_gesamtdistanz
```
Raunheim weist mit rund `r sprintf("%.0f", gewichtete_gesamtdistanz["Raunheim", 1])` Box-Kilometern die **geringste** gewichtete Gesamtdistanz zu den sechs Filialen auf, deutlich vor Wiesbaden-Erbenheim (`r sprintf("%.0f", gewichtete_gesamtdistanz["Wiesbaden-Erbenheim", 1])`) und Mainz-Hechtsheim (`r sprintf("%.0f", gewichtete_gesamtdistanz["Mainz-Hechtsheim", 1])`). Diese rein quantitative Kennzahl bestätigt damit die Rangfolge, die der AHP für das Kriterium Transportnähe (Schritt 2) allein aus qualitativen Paarvergleichen abgeleitet hatte – ein schönes Beispiel dafür, wie sich qualitative Experteneinschätzungen und quantitative Nachrechnung gegenseitig plausibilisieren können.
### Realitätscheck für Center of Gravity und Weiszfeld-Optimum
Zum Abschluss prüfen wir, wie **realistisch** die beiden kontinuierlichen Optima aus dem vorigen Abschnitt tatsächlich sind, wenn wir die eingangs gemachte planare Vereinfachung aufheben und die echte, sphärische Haversine-Distanz zu jeder Filiale berechnen:
```{r}
#| label: ch4-realitaetscheck
#| echo: true
cog_dist <- sapply(seq_len(nrow(filialen)), function(j) {
  haversine(cog_lat, cog_lon, filialen$lat[j], filialen$lon[j])
})
weiszfeld_dist <- sapply(seq_len(nrow(filialen)), function(j) {
  haversine(ergebnis$y, ergebnis$x, filialen$lat[j], filialen$lon[j])
})

realitaetscheck <- tibble(
  Filiale = filialen$Filiale,
  Nachfrage = filialen$mu,
  `CoG (km)` = round(cog_dist, 1),
  `Weiszfeld (km)` = round(weiszfeld_dist, 1)
)
realitaetscheck |>
  kable(align = "lccc") |>
  kable_styling(full_width = FALSE)
```
Das Bild ist aufschlussreich: Zur nachfragestärksten Filiale Frankfurt (280 Boxen/Tag) liegt das Weiszfeld-Optimum mit rund `r sprintf("%.1f", weiszfeld_dist[filialen$Filiale == "Frankfurt"])` km deutlich näher als das Center of Gravity mit rund `r sprintf("%.1f", cog_dist[filialen$Filiale == "Frankfurt"])` km – umgekehrt entfernt sich das Weiszfeld-Optimum von den kleineren, weiter westlich liegenden Filialen Wiesbaden und Mainz merklich stärker als das CoG. Der Weiszfeld-Algorithmus "zieht" den Standort also gezielt in Richtung der großen Einzelfiliale Frankfurt, während das Center of Gravity als reiner arithmetischer Mittelwert weniger empfindlich auf einzelne große Nachfrageschwerpunkte reagiert, dafür aber auch weniger nah an ihnen liegt. Das ist keine allgemeine Überlegenheit des einen oder anderen Verfahrens, sondern ein guter Diskussionsanlass: Wie stark ein Standortverfahren auf einzelne große Nachfrager reagieren *soll*, ist letztlich eine Frage der Robustheit gegenüber Nachfrageschwankungen und Ausreißern – nicht allein eine Frage der Optimalität im Modell.
Damit schließt sich der Kreis zu den drei diskreten Kandidatenstandorten: Weder das Center of Gravity noch das Weiszfeld-Optimum liegen auf einem der drei tatsächlich verfügbaren Grundstücke – sie zeigen lediglich, in welche Richtung des Absatzgebiets sich eine Produktionsstätte "ideal" verschieben würde. Die eigentliche Standortentscheidung bleibt bei SushiFresh also eine **diskrete** Wahl zwischen den drei Kandidaten, für die der AHP in diesem Kapitel – knapp – Mainz-Hechtsheim empfohlen hat, während Raunheim bei der Transportnähe klar vorne liegt. Ob sich diese qualitative Einschätzung auch bei einer reinen Kostenbetrachtung bestätigt, untersuchen wir in Kapitel [-@sec-standort-2]: Dort formulieren wir mit dem Warehouse-Location-Problem ein quantitatives Optimierungsmodell, das neben den Transportkosten auch die Fixkosten der Grundstücke explizit berücksichtigt und die Menge der Kandidaten um zwei weitere Standorte erweitert – und das, wie sich zeigen wird, nicht zwangsläufig zum selben Ergebnis kommen muss wie die hier vorgenommene qualitative Bewertung.
## Zusammenfassung
Dieses Kapitel hat zwei grundsätzlich verschiedene Zugänge zur Standortplanung gegenübergestellt, durchgängig am Beispiel der SushiFresh GmbH und ihrer Suche nach einem Produktionsstandort im Rhein-Main-Gebiet. **Qualitative Verfahren** – die Nutzwertanalyse und der Analytic Hierarchy Process – bewerten eine begrenzte Menge diskreter Alternativen (bei SushiFresh: drei Kandidatengrundstücke) anhand mehrerer, auch weicher Kriterien. Die Nutzwertanalyse ist einfach anzuwenden, leidet aber unter der Kompensierbarkeit ihrer additiven Struktur, die im Extremfall dazu führen kann, dass Alternativen mit völlig unterschiedlichem Profil denselben Gesamtnutzwert erhalten – wie im Fallbeispiel, in dem alle drei Standorte exakt den Nutzwert 5,0 erreichten. Der AHP begegnet dieser Schwäche, indem er Kriterien- und Alternativengewichte aus paarweisen Vergleichen ableitet und über den Konsistenzindex eine explizite Qualitätskontrolle der Experteneinschätzungen ermöglicht; im Fallbeispiel empfahl er – bei einer allerdings nicht ganz konsistenten Kriterienmatrix – knapp den Standort Mainz-Hechtsheim.
**Kontinuierliche Verfahren** gehen einen Schritt weiter und suchen den optimalen Standort nicht unter vorgegebenen Alternativen, sondern als beliebigen Punkt einer Ebene. Das Center of Gravity liefert dafür eine schnelle, geschlossene Näherungslösung, die allerdings nur die quadrierte Zielfunktion exakt minimiert. Der Weiszfeld-Algorithmus löst iterativ das eigentliche, auf linearen euklidischen Distanzen basierende Problem und zog den SushiFresh-Standort spürbar in Richtung der nachfragestarken Filiale Frankfurt. Bei Manhattan-Distanzen vereinfacht sich das Problem sogar auf die Berechnung eines gewichteten Medians je Koordinate. Für großräumige, geografische Anwendungsfälle schließlich liefert die Haversine-Formel ein realistischeres Distanzmaß als die naive euklidische Distanz auf Grad-Koordinaten – und bestätigte im Fallbeispiel sowohl die AHP-Rangfolge bei der Transportnähe als auch die Robustheits-Unterschiede zwischen Center of Gravity und Weiszfeld-Optimum.
Beiden Verfahrensfamilien ist gemeinsam, dass sie den Standort entweder aus einer *gegebenen* Alternativenliste wählen oder als *beliebigen* Punkt im Raum bestimmen. In der Praxis ist die Menge realistischer Standorte jedoch oft weder völlig frei wählbar noch auf wenige, von Hand vorausgewählte Alternativen beschränkt, sondern besteht aus einer größeren, aber endlichen Menge in Frage kommender Grundstücke oder Gebäude. Für diesen Fall – die **diskrete Standortplanung** mit Warehouse-Location-Modellen und Netzwerkplanungsheuristiken – wird in Kapitel [-@sec-standort-2] das methodische Instrumentarium um exakte und heuristische Optimierungsverfahren erweitert. Dort greifen wir die SushiFresh-Fallstudie wieder auf und prüfen, ob sich die knappe AHP-Empfehlung zugunsten von Mainz-Hechtsheim auch unter einer expliziten Kostenrechnung bestätigt.
::: {.kontrollfragen}
**Kontrollfragen**
1. Erläutern Sie den fünfstufigen Ablauf der Nutzwertanalyse und nennen Sie zwei ihrer methodischen Schwächen.
2. Warum können bei der Nutzwertanalyse Alternativen mit völlig unterschiedlichen Stärken-Schwächen-Profilen denselben Gesamtnutzwert erreichen?
3. Beschreiben Sie die fünf Schritte des AHP-Verfahrens. Welche Rolle spielt dabei die Paarvergleichsmatrix?
4. Wie wird der Konsistenzindex (CI) einer Paarvergleichsmatrix berechnet, und ab welchem Schwellenwert der Konsistenzrate (CR) gilt eine Matrix üblicherweise als hinreichend konsistent?
5. Leiten Sie die Formel für das Center of Gravity aus der Minimierung der gewichteten quadrierten euklidischen Distanzen her.
6. Warum liefert der Weiszfeld-Algorithmus in der Regel eine bessere (kostenminimalere) Lösung als das Center of Gravity, obwohl beide auf euklidischen Distanzen basieren? Was bedeutet das im SushiFresh-Beispiel konkret für die Filiale Frankfurt?
7. Worin unterscheidet sich die Bestimmung des optimalen Standorts unter Manhattan-Distanzen von der Bestimmung unter euklidischen Distanzen?
8. Warum ist die direkte Anwendung euklidischer Distanzen auf geografische Koordinaten (Breiten-/Längengrad) problematisch, und welche Alternative bietet die Haversine-Formel?
9. Der AHP empfiehlt im Fallbeispiel knapp den Standort Mainz-Hechtsheim. Nennen Sie zwei Gründe, warum eine rein kostenbasierte Betrachtung (wie in Kapitel [-@sec-standort-2]) zu einem anderen Ergebnis kommen könnte.
10. Ändern Sie im R-Code den Vergleich "Transportnähe gegenüber Fachkräften" von 2 auf 1/2. Wie verändern sich Konsistenzrate und Rangfolge der Standorte? Interpretieren Sie das Ergebnis.
:::
::: {.callout-tip}
## Übungen und Fallstudie
Aufgaben zur Klausurvorbereitung mit ausklappbaren Musterlösungen (Teil 1) und eine vertiefende Gruppenfallstudie (Teil 2) zu diesem Kapitel finden Sie in **[Fallstudie 2: Qualitative und kontinuierliche Standortplanung](https://tkirschstein.github.io/SCM_BDBM/case_studies/case_study_02_standort_ahp_steiner_weber)**.
:::