# Das Newsvendor-Modell {#sec-newsvendor}
::: {.lernziele}
**Lernziele**
Nach diesem Kapitel können Sie …
- das **Newsvendor-Problem** als einmalige Bestellentscheidung bei unsicherer Nachfrage **einordnen**,
- Über- und Unterdeckungskosten **bestimmen**,
- die kritische Fraktilregel **herleiten und interpretieren**,
- eine optimale Bestellmenge bei gegebener Nachfrageverteilung **berechnen**,
- den Einfluss zentraler Modellparameter auf die Bestellentscheidung **erklären**,
- numerische Wurzelfindung (`uniroot()`) und Optimierung (`optimize()`) als Alternative zu geschlossenen Lösungsformeln einsetzen.
**Literatur zur Vertiefung**
- Einführung Newsvendor: @thonemann2023operations, Kapitel 5.
- Einperiodige Bestandsmodelle und Critical-Fractile-Logik: @cachon2024matching, Kapitel 13.
- Newsvendor-Modelle im Kontext des Inventory Managements: @silver2017inventory, Kapitel 9.
:::
## Einperiodige Entscheidungen unter Unsicherheit
In Kapitel [-@sec-unsicherheit-pooling] haben wir gelernt, wie sich Nachfrageunsicherheit mit Wahrscheinlichkeitsverteilungen beschreiben lässt und wie man mit `rnorm()`, `dnorm()`, `pnorm()` und `qnorm()` Aussagen über normalverteilte Zufallsgrößen trifft. Auch das Prinzip der Monte-Carlo-Simulation mit `replicate()` und die empirische Verteilungsfunktion `ecdf()` wurden dort eingeführt. In diesem Kapitel nutzen wir genau dieses Instrumentarium, um eine der zentralen Entscheidungssituationen des Supply Chain Managements zu lösen: die Frage, wie viel von einem Produkt bestellt oder produziert werden soll, wenn die Nachfrage erst *nach* der Entscheidung bekannt wird und eine Korrektur der Menge während der Verkaufsperiode nicht mehr möglich ist.
Dieses Problem heißt **Newsvendor-Modell** (auch *Newsboy-Problem* oder *Einperioden-Bestandsmodell*), benannt nach dem klassischen Beispiel eines Zeitungsverkäufers, der jeden Morgen entscheiden muss, wie viele Exemplare einer Tageszeitung er einkauft, bevor er die tatsächliche Nachfrage des Tages kennt. Die mathematische Struktur des Problems wurde bereits in den 1950er-Jahren von @arrow1951optimal formal untersucht und ist seither eines der am häufigsten verwendeten Modelle der Bestandsplanung [@cachon2024matching; @silver2017inventory]. Charakteristisch für alle Anwendungen ist:
- Es wird **eine einzige Bestell- oder Produktionsentscheidung** vor Beginn der Verkaufsperiode getroffen.
- **Innerhalb der Periode** ist keine Nachbestellung möglich — Angebot und Nachfrage treffen erst am Ende der Periode endgültig aufeinander.
- Die Nachfrage der Periode ist zum Entscheidungszeitpunkt **unsicher**, aber ihre Verteilung ist bekannt (z. B. aus historischen Verkaufsdaten geschätzt).
- Nicht verkaufte Einheiten haben am Ende der Periode einen **geringeren Wert** als ursprünglich kalkuliert (Rabattverkauf, Entsorgung, Rückgabe an den Hersteller) — und zu wenig bestellte Einheiten führen zu **entgangenem Deckungsbeitrag**.
Damit ist das Newsvendor-Modell das mikroökonomische Fundament für sehr viel weitreichendere Fragestellungen: Wie hoch sollte der Sicherheitsbestand in einem mehrperiodigen Lager sein? Wie groß sollte die Kapazität einer Fertigungslinie sein? Wie viele Zimmer sollte ein Hotel für eine bestimmte Nacht anbieten? Wir werden in diesem Kapitel sehen, dass alle diese Fragen im Kern dieselbe formale Struktur besitzen.
## Fallbeispiel: Sushi-Boxen im Supermarkt
Zur Veranschaulichung begleiten wir das gesamte Kapitel mit einem durchgehenden Beispiel: Die **SushiFresh GmbH**, ein regionaler Hersteller frischer Sushi-Boxen im Rhein-Main-Gebiet, beliefert täglich mehrere Supermarkt-Filialen mit frisch produzierten Sushi-Boxen. Der zeitliche Ablauf eines Verkaufstages sieht für jede Filiale wie folgt aus:
1. **7 Uhr:** Die Sushi-Boxen werden frisch vorbereitet und vor Ladenöffnung an die jeweilige Filiale geliefert.
2. **8 Uhr:** Der Verkauf im Supermarkt beginnt. Nachlieferungen während des Tages sind ausgeschlossen — die produzierte Menge ist für den gesamten Tag fix.
3. **19 Uhr:** Nicht verkaufte Boxen werden von SushiFresh wieder abgeholt.
4. **20 Uhr:** Die Restware wird rabattiert verkauft, gespendet oder entsorgt — ein regulärer Verkauf am Folgetag ist aus Gründen der Lebensmittelsicherheit nicht mehr zulässig.
Die zentrale unternehmerische Entscheidung fällt bereits am Morgen, lange bevor die tatsächliche Tagesnachfrage der jeweiligen Filiale bekannt ist: **Wie viele Sushi-Boxen sollte SushiFresh je Filiale produzieren?**
### Erlös- und Kostenstruktur
Für eine einzelne Sushi-Box gelten folgende, vereinfachte Werte:
| Größe | Bedeutung | Wert |
|---|---|---:|
| Verkaufspreis $p$ | Erlös je verkaufter Sushi-Box | 10 € |
| Herstell- und Lieferkosten $c$ | Kosten je vorbereiteter Sushi-Box | 5 € |
| Restwert $v$ | Erlös bei Abendrabatt bzw. Verwertung | 2 € |
Für ökonomisch sinnvolle Anwendungen des Modells muss stets $p > c > v$ gelten: Läge der Restwert $v$ nicht unterhalb der Herstellkosten $c$, gäbe es keinen Anreiz, die Bestellmenge überhaupt zu begrenzen — man könnte beliebig viel produzieren, da selbst unverkaufte Ware immer noch mindestens kostendeckend verwertet würde. Läge umgekehrt der Verkaufspreis $p$ nicht oberhalb der Herstellkosten $c$, würde sich der Verkauf grundsätzlich nicht lohnen.
Aus diesen drei Größen leiten wir zwei zentrale Kostenkategorien ab, die im weiteren Verlauf des Kapitels immer wieder auftauchen:
::: {.definition}
**Definition: Unterdeckungs- und Überdeckungskosten**
Die **Unterdeckungskosten** $c^u$ (*underage cost*) entsprechen dem entgangenen Deckungsbeitrag je Einheit, die nicht verkauft werden konnte, weil zu wenig bestellt wurde:
$$c^u = p - c$$
Die **Überdeckungskosten** $c^o$ (*overage cost*) entsprechen dem Verlust je Einheit, die am Ende der Periode nicht verkauft wurde:
$$c^o = c - v$$
Für unser Sushi-Beispiel ergibt sich: $c^u = 10 - 5 = 5\ \text{€}$ und $c^o = 5 - 2 = 3\ \text{€}$.
:::
Beide Größen sind *Opportunitätskosten* — es fließt kein Geld in Höhe von $c^u$ oder $c^o$ tatsächlich ab, sondern es handelt sich um entgangenen bzw. verlorenen Deckungsbeitrag im Vergleich zur jeweils bestmöglichen Entscheidung. Genau dieses Spannungsfeld zwischen "zu wenig" und "zu viel" bestellen ist der Kern des Newsvendor-Problems.
## Herleitung der Gewinnfunktion
Bezeichnen wir mit $D$ die (zufällige) Tagesnachfrage und mit $q$ die vom Lieferanten festgelegte Bestellmenge, lassen sich zwei Situationen unterscheiden.
**Fall 1 — Überdeckung ($q > D$):** Es wird mehr produziert als nachgefragt. Verkauft werden genau $D$ Einheiten, während $q - D$ Einheiten zum Restwert verwertet werden müssen. Der Deckungsbeitrag beträgt
$$P(D,q) = D \cdot c^u - (q - D) \cdot c^o.$$
**Fall 2 — Unterdeckung ($q < D$):** Es wird weniger produziert als nachgefragt. Da nicht mehr Ware zur Verfügung steht, als produziert wurde, werden genau $q$ Einheiten verkauft — die überschießende Nachfrage $D - q$ bleibt unbedient und der zugehörige Deckungsbeitrag geht verloren. Es gilt
$$P(D,q) = q \cdot c^u.$$
Beide Fälle lassen sich mithilfe der *positiven Teil*-Funktion $(x)^+ := \max(x,0)$ zu einer einzigen, für beliebige Werte von $D$ und $q$ gültigen Gewinnfunktion zusammenfassen:
$$
P(D,q) = c^u \cdot \min(D,q) - c^o \cdot (q-D)^+.
$$
Da $\min(D,q) = D - (D-q)^+$ gilt (die verkaufte Menge entspricht der Nachfrage abzüglich der nicht bedienten Fehlmenge), lässt sich die Gewinnfunktion äquivalent auch so schreiben:
$$
P(D,q) = \underbrace{D \cdot c^u}_{\text{maximal möglicher DB}} - \underbrace{(D-q)^+ \cdot c^u}_{\text{Fehlmengenkosten}} - \underbrace{(q-D)^+ \cdot c^o}_{\text{Überbestandskosten}}.
$$
Diese Schreibweise macht die ökonomische Logik besonders deutlich: Ausgehend vom größtmöglichen Deckungsbeitrag $D \cdot c^u$, den man erzielen würde, wenn man die Nachfrage exakt träfe, werden zwei Arten von Kosten abgezogen — die Fehlmengenkosten bei zu geringer und die Überbestandskosten bei zu hoher Bestellmenge. Da $D$ zum Entscheidungszeitpunkt eine Zufallsvariable ist, betrachten wir den **Erwartungswert** über alle möglichen Nachfragerealisationen:
$$
E[P(q)] = \mu \cdot c^u - c^u \cdot E\big[(D-q)^+\big] - c^o \cdot E\big[(q-D)^+\big],
$$
wobei $\mu = E[D]$ der Erwartungswert der Nachfrage ist. Da der erste Term $\mu \cdot c^u$ nicht von $q$ abhängt, ist die Maximierung des erwarteten Gewinns äquivalent zur Minimierung der erwarteten Fehlmengen- und Überbestandskosten:
$$
\min_q\ E[C(q)] = c^u \cdot E\big[(D-q)^+\big] + c^o \cdot E\big[(q-D)^+\big].
$$
::: {.fallstudie}
**Fallstudie: Erwarteter Deckungsbeitrag bei $q = 40$ Boxen (Rechenweg der Vorlesung)**
Bevor die Optimierung allgemein gelöst wird, lohnt es sich, eine einzelne Produktionsmenge von Hand durchzurechnen. SushiFresh schätzt für eine kleine Filiale vier Nachfrageszenarien (30, 40, 50 oder 60 Boxen mit Wahrscheinlichkeiten 0,20 / 0,35 / 0,30 / 0,15). Werden $q = 40$ Boxen produziert, ergibt sich je Szenario:
| Nachfrage $D$ | $P(D=d)$ | Überbestand $(q-D)^+$ | Fehlmenge $(D-q)^+$ | $P(D,q) = c^u\min(D,q) - c^o (q-D)^+$ |
|---:|---:|---:|---:|---:|
| 30 | 0,20 | 10 | 0 | $5\cdot 30 - 3\cdot 10 = 120$ € |
| 40 | 0,35 | 0 | 0 | $5\cdot 40 = 200$ € |
| 50 | 0,30 | 0 | 10 | $5\cdot 40 = 200$ € |
| 60 | 0,15 | 0 | 20 | $5\cdot 40 = 200$ € |
Der erwartete Deckungsbeitrag beträgt damit $E[P \mid q=40] = 0{,}20\cdot 120 + 0{,}35\cdot 200 + 0{,}30\cdot 200 + 0{,}15\cdot 200 = 184$ €.
:::
Bevor wir diese Optimierung formal lösen, implementieren wir das Modell für den diskreten Fall selbst in R — das schärft das Verständnis der Formel erheblich mehr, als sie nur zu lesen.
::: {.r-exkurs}
**R-Exkurs: Eine Modellfunktion kapseln**
In Kapitel [-@sec-strategic-fit] haben Sie gelernt, eigene Funktionen mit `function()` zu schreiben. Bisher waren das meist kurze Hilfsfunktionen mit wenigen Zeilen. Für komplexere Modelle — wie das Newsvendor-Modell — lohnt es sich, das *gesamte* Berechnungsschema in einer einzigen, gut dokumentierten Funktion zu kapseln: Eingabeparameter hinein, alle Zwischengrößen berechnet, und am Ende ein strukturiertes Ergebnis (typischerweise eine `list()`) zurückgegeben. Genau nach diesem Muster ist auch die Funktion `newsvendor_normal()` in `R/scm_functions.R` aufgebaut, die wir später in diesem Kapitel noch verwenden werden.
Wir bauen die diskrete Variante jetzt Schritt für Schritt selbst:
```{r ch7-funktion-diskret}
#| message: false
library(tidyverse)  # dplyr, tibble, ggplot2, purrr

#' Newsvendor-Modell bei diskreter Nachfrage
#'
#' Berechnet fuer eine Menge diskreter Nachfrageszenarien den erwarteten
#' Gewinn je Bestellmenge sowie die nach der Fraktilregel optimale
#' Bestellmenge.
#'
#' @param nachfrage           aufsteigend sortierter Vektor moeglicher
#'                            Nachfragewerte (die Bestellmengen-Kandidaten)
#' @param wahrscheinlichkeit  Vektor der zugehoerigen Eintrittswahrscheinlichkeiten
#' @param verkaufspreis       Erloes je verkaufter Einheit (p)
#' @param herstellkosten      Kosten je produzierter/beschaffter Einheit (bewusst
#'                            nicht "c" genannt, da c() in R fuer Vektoren reserviert ist!)
#' @param restwert            Erloes je nicht verkaufter Einheit (v)
#' @return Liste mit Kostenparametern, vollstaendiger Ergebnistabelle und
#'         optimaler Bestellmenge
newsvendor_diskret <- function(nachfrage, wahrscheinlichkeit,
                                verkaufspreis, herstellkosten, restwert) {

  # -- 1. Eingaben pruefen ---------------------------------------------------
  stopifnot(
    length(nachfrage) == length(wahrscheinlichkeit),
    abs(sum(wahrscheinlichkeit) - 1) < 1e-8,   # Wahrscheinlichkeiten summieren zu 1
    all(diff(nachfrage) > 0),                   # nachfrage muss aufsteigend sortiert sein
    verkaufspreis > herstellkosten,
    herstellkosten > restwert
  )

  # -- 2. Kostenparameter ableiten -------------------------------------------
  cu <- verkaufspreis - herstellkosten   # Unterdeckungskosten c^u
  co <- herstellkosten - restwert        # Ueberdeckungskosten c^o
  cr <- cu / (cu + co)                   # kritische Verhaeltniszahl (critical ratio)

  # -- 3. erwarteter Gewinn fuer eine gegebene Bestellmenge q ----------------
  # Innere Hilfsfunktion: nutzt die Variablen aus der umgebenden Funktion
  # (cu, co, nachfrage, wahrscheinlichkeit) und ist deshalb nur lokal gueltig.
  gewinn_bei_q <- function(q) {
    gewinn_je_szenario <- cu * pmin(nachfrage, q) - co * pmax(q - nachfrage, 0)
    sum(wahrscheinlichkeit * gewinn_je_szenario)  # Erwartungswert
  }

  # -- 4. alle Nachfrageszenarien als Bestellmengen-Kandidaten durchrechnen --
  erwarteter_gewinn <- vapply(nachfrage, gewinn_bei_q, numeric(1))

  # -- 5. kumulierte Wahrscheinlichkeiten fuer die Fraktilregel --------------
  kumuliert <- cumsum(wahrscheinlichkeit)

  # -- 6. optimale Bestellmenge: kleinstes q mit F(q) >= kritischer Quote ----
  q_stern <- nachfrage[min(which(kumuliert >= cr))]

  # -- 7. Ergebnis als benannte Liste zurueckgeben ----------------------------
  list(
    cu             = cu,
    co             = co,
    cr             = cr,
    tabelle        = tibble(
      bestellmenge       = nachfrage,
      wahrscheinlichkeit = wahrscheinlichkeit,
      kumuliert          = kumuliert,
      erwarteter_gewinn  = erwarteter_gewinn
    ),
    q_stern        = q_stern,
    gewinn_optimum = gewinn_bei_q(q_stern)
  )
}
```
Nun wenden wir die Funktion auf ein bewusst kleines, vereinfachtes Miniaturbeispiel an — etwa einen Testverkauf in einer kleinen Filiale, für die noch keine verlässliche Verteilungsannahme getroffen werden kann. Aus Verkaufshistorie, Wochentag, Wetterprognose und aktuellen Aktionen wurden für diesen Testfall vier mögliche Nachfrageszenarien geschätzt:
```{r ch7-sushi-anwendung}
sushi <- newsvendor_diskret(
  nachfrage          = c(30, 40, 50, 60),
  wahrscheinlichkeit = c(0.20, 0.35, 0.30, 0.15),
  verkaufspreis      = 10,
  herstellkosten     = 5,
  restwert           = 2
)

sushi$tabelle |>
  knitr::kable(
    digits = c(0, 2, 2, 1),
    col.names = c("Bestellmenge q", "P(D=q)", "F(q)", "E[Gewinn | q]")
  )
```
Der erwartete Gewinn steigt zunächst von 30 auf 50 Sushi-Boxen an und fällt danach wieder — ein typisches Muster für Newsvendor-Probleme: Sowohl zu geringe als auch zu hohe Bestellmengen verringern den erwarteten Gewinn. Die Funktion identifiziert **`r sushi$q_stern`** Sushi-Boxen als optimale Bestellmenge mit einem erwarteten Gewinn von **`r round(sushi$gewinn_optimum, 1)`** € pro Tag. Im nächsten Abschnitt leiten wir her, *warum* genau diese Menge optimal ist.
:::
## Diskrete Nachfrage: Die Fraktilregel
Warum wählt unsere Funktion gerade die kleinste Bestellmenge, deren kumulierte Wahrscheinlichkeit $F(q)$ eine bestimmte Schwelle überschreitet? Die Antwort liefert eine **Grenzbetrachtung**: Wir fragen uns, ob es sich lohnt, die Bestellmenge um eine zusätzliche Einheit zu erhöhen.
- Mit Wahrscheinlichkeit $1 - F(q)$ liegt die tatsächliche Nachfrage *über* $q$. In diesem Fall wird die zusätzliche Einheit verkauft und vermeidet eine Fehlmenge — der erwartete Grenzgewinn beträgt $c^u \cdot (1 - F(q))$.
- Mit Wahrscheinlichkeit $F(q)$ liegt die Nachfrage bei höchstens $q$. In diesem Fall bleibt die zusätzliche Einheit unverkauft — der erwartete Grenzverlust beträgt $c^o \cdot F(q)$.
Es lohnt sich, die Bestellmenge zu erhöhen, solange der erwartete Grenzgewinn den erwarteten Grenzverlust übersteigt, also solange $c^u \cdot (1-F(q)) > c^o \cdot F(q)$ gilt. Am **Optimum** sind Grenzgewinn und Grenzverlust der letzten bestellten Einheit gerade ausgeglichen:
::: {.definition}
**Definition: Kritische Verhältniszahl (Critical Ratio)**
$$
c^u \cdot \big(1 - F(q^*)\big) = c^o \cdot F(q^*) \quad \Longleftrightarrow \quad F(q^*) = \underbrace{\frac{c^u}{c^u + c^o}}_{=: CR} \quad \Longleftrightarrow \quad q^* = F^{-1}(CR).
$$
Die **kritische Verhältniszahl** $CR$ gibt an, welcher Anteil der Nachfrageverteilung höchstens von der optimalen Bestellmenge abgedeckt werden sollte. Sie hängt ausschließlich vom *Verhältnis* der Unter- zu den Überdeckungskosten ab, nicht von deren absoluter Höhe.
:::
Für unser Sushi-Beispiel ergibt sich $CR = 5/(5+3) = 0{,}625$. Bei **diskreter** Nachfrage ist $F$ eine Treppenfunktion, sodass $F(q) = CR$ im Allgemeinen für kein einziges $q$ exakt erfüllt ist. Die korrekte Entscheidungsregel lautet deshalb: Wähle die **kleinste** Bestellmenge $q$, deren kumulierte Wahrscheinlichkeit $F(q)$ mindestens $CR$ erreicht.
| Nachfrage $D$ | $P(D=d)$ | $F(d)$ |
|---:|---:|---:|
| 30 | 0,20 | 0,20 |
| 40 | 0,35 | 0,55 |
| 50 | 0,30 | 0,85 |
| 60 | 0,15 | 1,00 |
Da $F(40) = 0{,}55 < 0{,}625 \le F(50) = 0{,}85$, ist $q^* = 50$ Sushi-Boxen die optimale Bestellmenge — exakt das Ergebnis, das unsere Funktion `newsvendor_diskret()` im vorherigen Abschnitt bereits durch vollständiges Durchrechnen aller erwarteten Gewinne gefunden hat. Diese Übereinstimmung ist kein Zufall, sondern die Bestätigung, dass die Fraktilregel und das direkte Ausrechnen des erwarteten Gewinns *dasselbe* Optimierungsproblem lösen — einmal über eine geschlossene Entscheidungsregel, einmal über vollständige Enumeration.
Die kritische Verhältniszahl erlaubt zudem eine anschauliche Fallunterscheidung:
- **$c^u < c^o$:** Fehlmengen sind günstiger als Überbestände $\Rightarrow$ $CR < 0{,}5$ $\Rightarrow$ $q^*$ liegt **unterhalb** des Medians der Nachfrage — es lohnt sich, eher knapp zu bestellen.
- **$c^u = c^o$:** Beide Fehlerarten sind gleich teuer $\Rightarrow$ $CR = 0{,}5$ $\Rightarrow$ $q^*$ entspricht dem **Median** der Nachfrage.
- **$c^u > c^o$:** Fehlmengen sind teurer als Überbestände $\Rightarrow$ $CR > 0{,}5$ $\Rightarrow$ $q^*$ liegt **oberhalb** des Medians — es lohnt sich, eher großzügig zu bestellen.
::: {.vertiefung}
**Theorie-Vertiefung: Die Fraktilregel als Bedingung erster Ordnung**
Die Grenzbetrachtung lässt sich für stetige Nachfrage mit Dichte $f$ und Verteilungsfunktion $F$ exakt formulieren. Die erwarteten Kosten lauten
$$
E[C(q)] = c^u \int_q^{\infty} (d - q)\, f(d)\, \mathrm{d}d \;+\; c^o \int_{-\infty}^{q} (q - d)\, f(d)\, \mathrm{d}d .
$$
Differenziert man nach $q$ (Leibniz-Regel: Die Integranden verschwinden an der Grenze $d = q$, sodass nur die Ableitung der Integranden übrig bleibt), ergibt sich
$$
\frac{\mathrm{d}\,E[C(q)]}{\mathrm{d}q} = -c^u \int_q^{\infty} f(d)\,\mathrm{d}d + c^o \int_{-\infty}^{q} f(d)\,\mathrm{d}d = -c^u\,\big(1 - F(q)\big) + c^o\, F(q).
$$
Nullsetzen liefert $F(q^*) = c^u/(c^u+c^o)$ – genau die Fraktilregel. Die zweite Ableitung ist $(c^u + c^o)\,f(q) \geq 0$, die erwarteten Kosten sind also **konvex** in $q$, und die Bedingung erster Ordnung beschreibt tatsächlich ein Minimum. Die Ableitung hat zudem eine anschauliche Bedeutung: $1 - F(q)$ ist die Wahrscheinlichkeit, dass eine zusätzliche Einheit verkauft wird, $F(q)$ die Wahrscheinlichkeit, dass sie übrig bleibt. Die Grafiken der Vorlesung, in denen sich die Kurven der erwarteten Fehlmengen- und Überbestandskosten schneiden bzw. deren Steigungen ausgleichen, sind die geometrische Entsprechung dieser Gleichung.
:::
## Stetige Nachfrage: Die Normalverteilung
In der Praxis liegt Nachfrage selten in Form weniger diskreter Szenarien vor, sondern wird — wie in Kapitel [-@sec-unsicherheit-pooling] besprochen — häufig durch eine stetige Verteilung angenähert, meist die Normalverteilung $D \sim N(\mu, \sigma^2)$. Die SushiFresh GmbH beliefert inzwischen sechs Supermarkt-Filialen im Rhein-Main-Gebiet, deren Tagesnachfrage sich je nach Einzugsgebiet und Filialgröße deutlich unterscheidet. Wir betrachten im Folgenden die größte dieser Filialen, **Frankfurt**, für die aus der dokumentierten Verkaufshistorie eine Tagesnachfrage von $\mu = 280$ Boxen mit einer Standardabweichung von $\sigma = 55$ Boxen geschätzt wurde (bei unveränderter Kostenstruktur $c^u = 5\,$ €, $c^o = 3$ €, denn Verkaufspreis, Herstellkosten und Restwert sind produktbezogene und nicht filialspezifische Größen). Es handelt sich um dieselbe Filiale, die auch in Kapitel [-@sec-unsicherheit-pooling] im Kontext des Pooling-Effekts des Sicherheitsbestands über das SushiFresh-Filialnetz betrachtet wird.
Da die Normalverteilung eine streng monoton wachsende, stetige Verteilungsfunktion $F$ besitzt, existiert die Umkehrfunktion $F^{-1}$ exakt — die Fraktilregel muss hier nicht mehr näherungsweise über eine Treppenfunktion, sondern kann direkt ausgewertet werden. Wie in Kapitel [-@sec-unsicherheit-pooling] gilt für die Standardisierung $Z = (D-\mu)/\sigma \sim N(0,1)$, sodass sich $q^*$ mit dem Quantil der Standardnormalverteilung ausdrücken lässt, das `qnorm()` liefert:
$$
q^* = \mu + \sigma \cdot \Phi^{-1}(CR) = \mu + \sigma \cdot z^*, \qquad z^* = \Phi^{-1}(CR).
$$
Um auch die erwarteten Kosten am Optimum angeben zu können, benötigen wir die Erwartungswerte $E[(D-q)^+]$ und $E[(q-D)^+]$ für normalverteilte Nachfrage. Mit der **Einheits-Normalverlustfunktion** $L(z) = \varphi(z) - z\cdot(1-\Phi(z))$ — wobei $\varphi$ die Dichte der Standardnormalverteilung ist — lassen sich beide Erwartungswerte kompakt darstellen:
$$
E\big[(D-q)^+\big] = \sigma \cdot L(z), \qquad E\big[(q-D)^+\big] = \sigma \cdot L(-z), \qquad z = \frac{q-\mu}{\sigma}.
$$
Setzt man dies in die erwartete Kostenfunktion ein und wertet sie an der Optimalstelle $z = z^*$ aus (wo $\Phi(z^*) = CR$ per Konstruktion gilt), heben sich die von $z^*$ abhängigen Terme gegenseitig auf, und es verbleibt die bemerkenswert einfache Formel
$$
E\big[C(q^*)\big] = (c^u + c^o) \cdot \sigma \cdot \varphi(z^*).
$$
Genau diese beiden Formeln — für $q^*$ und $E[C(q^*)]$ — implementiert die Funktion `newsvendor_normal()` in `R/scm_functions.R`, die Sie zu Beginn dieses Kapitels bereits kennengelernt haben. Rechnen wir unser Beispiel nach:
```{r ch7-normal-parameter}
mu_nachfrage    <- 280  # Erwartungswert der Tagesnachfrage der Filiale Frankfurt (Boxen)
sigma_nachfrage <- 55   # Standardabweichung der Tagesnachfrage der Filiale Frankfurt (Boxen)

cu <- 5   # Unterdeckungskosten (wie im diskreten Fall)
co <- 3   # Ueberdeckungskosten

cr      <- cu / (cu + co)                 # kritische Verhaeltniszahl
z_stern <- qnorm(cr)                      # Standardnormal-Quantil
q_stern_normal <- mu_nachfrage + sigma_nachfrage * z_stern

# erwartete Fehlmengen- und Ueberbestandskosten am Optimum
kosten_optimum <- (cu + co) * sigma_nachfrage * dnorm(z_stern)

q_stern_normal
kosten_optimum
```
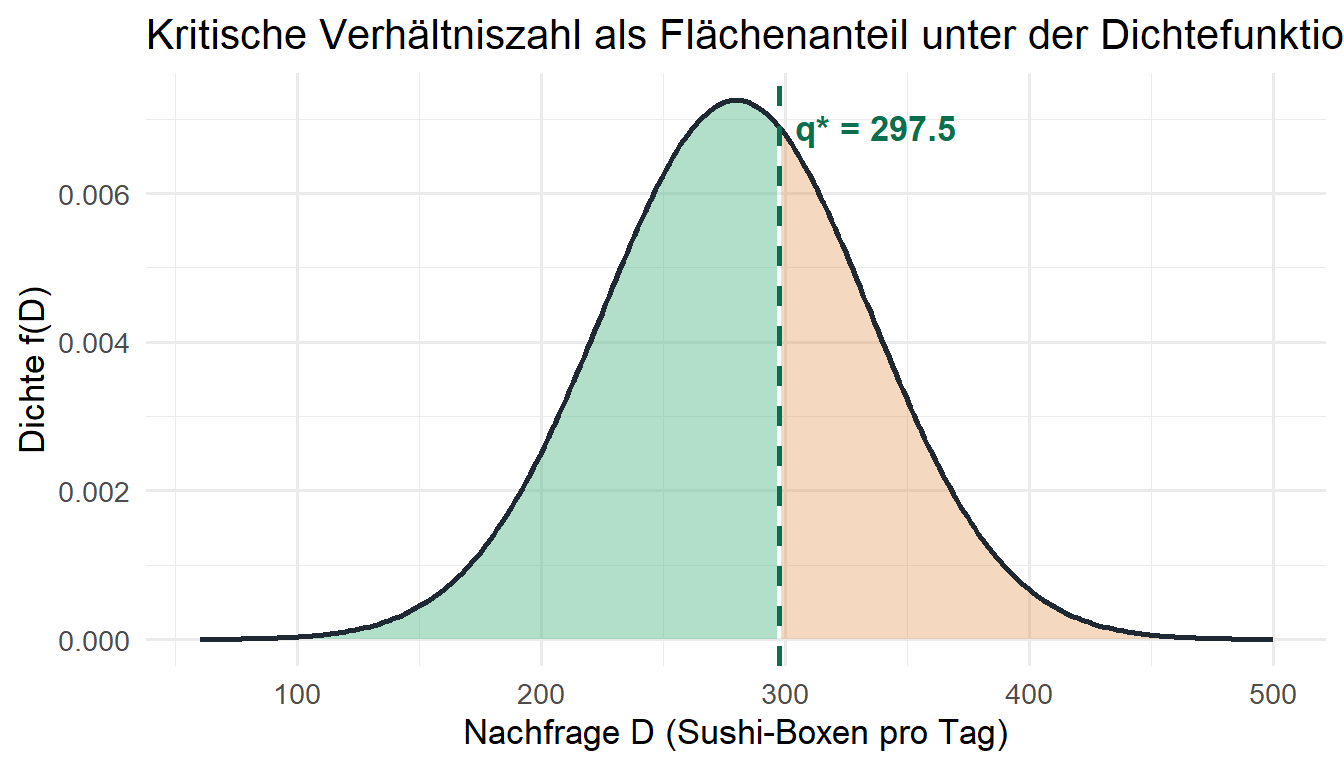
Mit $CR = 0{,}625$ ergibt sich $z^* = \Phi^{-1}(0{,}625) \approx 0{,}319$ und damit $q^* = 280 + 55 \cdot 0{,}319 \approx 297{,}5$ Sushi-Boxen. Da nur ganze Boxen produziert werden können, würde man in der Praxis auf $q^* = 298$ aufrunden. Die erwarteten Fehlmengen- und Überbestandskosten am Optimum betragen rund $166{,}8\,$€ pro Tag, sodass der erwartete Gewinn $E[P(q^*)] = \mu \cdot c^u - E[C(q^*)] \approx 280 \cdot 5 - 166{,}8 \approx 1233{,}2\,$€ pro Tag beträgt.
Zur Kontrolle vergleichen wir unser eigenes Ergebnis direkt mit der fertigen Funktion aus `R/scm_functions.R`:
```{r ch7-vergleich-funktion}
source("../R/scm_functions.R")
source("../R/scm_helpers.R")     # Darstellungshilfen (Farben, Tabellen, Formatierung)

ergebnis_fertig <- newsvendor_normal(
  mu = mu_nachfrage, sigma = sigma_nachfrage,
  p = 10, c = 5, s = 2
)

ergebnis_fertig$q_star       # sollte mit q_stern_normal uebereinstimmen
ergebnis_fertig$exp_profit # erwarteter Gewinn am Optimum
```
Die folgende Abbildung veranschaulicht die Nachfrageverteilung zusammen mit der optimalen Bestellmenge: Die grün eingefärbte Fläche links von $q^*$ entspricht der kumulierten Wahrscheinlichkeit $F(q^*) = CR$, also dem Anteil der Tage, an denen die Bestellmenge ausreicht.
```{r}
#| label: fig-newsvendor-normal
#| fig-cap: "Dichte der normalverteilten Sushi-Nachfrage der Filiale Frankfurt mit optimaler Bestellmenge"
#| fig-width: 7
#| fig-height: 4
nachfrage_grid <- tibble(
  d      = seq(mu_nachfrage - 4 * sigma_nachfrage,
               mu_nachfrage + 4 * sigma_nachfrage,
               length.out = 300),
  dichte = dnorm(d, mean = mu_nachfrage, sd = sigma_nachfrage)
)

ggplot(nachfrage_grid, aes(x = d, y = dichte)) +
  geom_area(
    data = filter(nachfrage_grid, d <= q_stern_normal),
    fill = "#52B788", alpha = 0.45
  ) +
  geom_area(
    data = filter(nachfrage_grid, d >= q_stern_normal),
    fill = "#D97B29", alpha = 0.30
  ) +
  geom_line(linewidth = 1, colour = "#1F2933") +
  geom_vline(
    xintercept = q_stern_normal,
    linetype = "dashed", colour = "#0B6E4F", linewidth = 1
  ) +
  annotate(
    "text", x = q_stern_normal, y = max(nachfrage_grid$dichte) * 0.95,
    label = paste0("q* = ", round(q_stern_normal, 1)),
    hjust = -0.1, colour = "#0B6E4F", fontface = "bold"
  ) +
  labs(
    x = "Nachfrage D (Sushi-Boxen pro Tag)",
    y = "Dichte f(D)",
    title = "Kritische Verhältniszahl als Flächenanteil unter der Dichtefunktion"
  ) +
  theme_minimal(base_size = 13)
```
Ein methodischer Exkurs sei an dieser Stelle erlaubt: Anstatt die Formel für $q^*$ direkt zu verwenden, ließe sich der erwartete Gewinn $E[P(q)]$ auch näherungsweise per **Monte-Carlo-Simulation** bestimmen — genau wie in Kapitel [-@sec-unsicherheit-pooling] eingeführt. Man würde mit `rnorm()` eine sehr große Zahl zufälliger Tagesnachfragen ziehen, für jede Ziehung den realisierten Gewinn gemäß der Gewinnfunktion $P(D,q)$ berechnen und anschließend über alle Wiederholungen mitteln (etwa mit `replicate()`). Für eine hinreichend große Anzahl von Simulationsläufen konvergiert dieser simulierte Mittelwert gegen den hier analytisch berechneten Erwartungswert $E[P(q)]$ — ein guter Plausibilitätstest, wenn eine geschlossene Formel wie hier verfügbar ist, und die einzige praktikable Lösung, wenn sie es nicht ist.
### Drei Fälle am Beispiel der Filiale Frankfurt
Die Fallunterscheidung aus dem diskreten Abschnitt lässt sich für die Filiale Frankfurt direkt quantifizieren. Die Vorlesung variiert dazu die Kostensätze so, dass Unterdeckung billiger, gleich teuer oder teurer ist als Überdeckung:
```{r}
#| label: ch7-drei-faelle
faelle <- tibble(
  Fall = c("1: c^u < c^o", "2: c^u = c^o", "3: c^u > c^o"),
  cu   = c(1, 3, 5),
  co   = c(5, 3, 1)
) |>
  mutate(
    CR      = cu / (cu + co),
    z_stern = qnorm(CR),
    q_stern = mu_nachfrage + sigma_nachfrage * z_stern,
    E_Kosten = (cu + co) * sigma_nachfrage * dnorm(z_stern)
  )

faelle |> mutate(across(where(is.numeric), ~ round(.x, 2)))
```
Im ersten Fall (Überbestände fünfmal so teuer wie Fehlmengen) produziert SushiFresh mit rund `r round(faelle$q_stern[1])` Boxen deutlich **unter** dem Erwartungswert von 280 Boxen und nimmt bewusst in Kauf, dass die Ware an rund `r round((1-faelle$CR[1])*100)` % der Tage vor Ladenschluss ausverkauft ist. Im symmetrischen Fall ist der Median – bei der Normalverteilung identisch mit dem Mittelwert – optimal. Im dritten Fall wird mit rund `r round(faelle$q_stern[3])` Boxen deutlich **über** dem Erwartungswert produziert. Wegen der Symmetrie der Normalverteilung liegen die Fälle 1 und 3 spiegelbildlich um $\mu$. Bemerkenswert ist, dass die minimalen erwarteten Kosten in Fall 1 und 3 gleich hoch sind: Sie hängen nur von $c^u + c^o$ und $\varphi(z^*)$ ab, und $\varphi$ ist symmetrisch.
## Numerische Optimierung als Alternative zur geschlossenen Lösung
Für die Normalverteilung konnten wir $q^*$ bequem über `qnorm()` bestimmen, weil ihre Verteilungsfunktion eine bekannte Umkehrfunktion besitzt. Bei vielen praktisch relevanten Verteilungen — etwa einer Lognormal-, Gamma- oder empirisch aus Daten geschätzten Verteilung — existiert keine geschlossene Form für $F^{-1}$. In solchen Fällen hilft numerische **Optimierung**, wie sie im folgenden Exkurs eingeführt wird.
::: {.r-exkurs}
**R-Exkurs: `uniroot()` und `optimize()` statt analytischer Lösung**
Die Bedingung $F(q^*) = CR$ aus der Fraktilregel lässt sich als **Nullstellenproblem** auffassen: Gesucht ist der Wert $q$, für den die Funktion $g(q) = F(q) - CR$ gleich null wird. Die Funktion `uniroot()` findet genau eine solche Nullstelle in einem vorgegebenen Intervall — ganz ohne dass wir die Umkehrfunktion von $F$ explizit kennen müssten:
```{r ch7-uniroot}
# Zielfunktion: Differenz zwischen Verteilungsfunktion und kritischer Quote.
# Bei Erfolg liefert uniroot() das q, fuer das diese Differenz null wird.
zielfunktion_wurzel <- function(q) {
  pnorm(q, mean = mu_nachfrage, sd = sigma_nachfrage) - cr
}

loesung_uniroot <- uniroot(
  zielfunktion_wurzel,
  interval = c(mu_nachfrage - 4 * sigma_nachfrage,
               mu_nachfrage + 4 * sigma_nachfrage)
)

loesung_uniroot$root   # sollte (nahezu) mit q_stern_normal uebereinstimmen
```
Alternativ lässt sich die erwartete Kostenfunktion $E[C(q)]$ auch **direkt minimieren**, ohne den Umweg über die Fraktilregel zu gehen — nützlich etwa, wenn man ausschließlich die Kostenfunktion kennt, nicht aber deren analytisches Minimum. `integrate()` berechnet dabei die Erwartungswerte $E[(D-q)^+]$ und $E[(q-D)^+]$ numerisch, und `optimize()` sucht anschließend das Minimum der Gesamtkostenfunktion:
```{r ch7-optimize}
erwartete_kosten <- function(q) {
  e_fehlmenge <- integrate(
    function(d) (d - q) * dnorm(d, mean = mu_nachfrage, sd = sigma_nachfrage),
    lower = q, upper = mu_nachfrage + 8 * sigma_nachfrage
  )$value

  e_ueberbestand <- integrate(
    function(d) (q - d) * dnorm(d, mean = mu_nachfrage, sd = sigma_nachfrage),
    lower = mu_nachfrage - 8 * sigma_nachfrage, upper = q
  )$value

  cu * e_fehlmenge + co * e_ueberbestand
}

loesung_optimize <- optimize(
  erwartete_kosten,
  interval = c(mu_nachfrage - 4 * sigma_nachfrage,
               mu_nachfrage + 4 * sigma_nachfrage)
)

loesung_optimize$minimum   # optimale Bestellmenge
loesung_optimize$objective # minimale erwartete Kosten
```
Beide numerischen Verfahren liefern (bis auf minimale Rundungsabweichungen) dasselbe Ergebnis wie die geschlossene Formel $q^* = \mu + \sigma \cdot \Phi^{-1}(CR)$. Der Vorteil dieser Herangehensweise zeigt sich, sobald man `dnorm()`/`pnorm()` durch die Dichte- bzw. Verteilungsfunktion einer beliebigen anderen Verteilung ersetzt — die Struktur des Codes bleibt unverändert, während eine analytische Herleitung für jede neue Verteilung von Neuem geleistet werden müsste.
:::
## Kritische Verhältniszahl und Servicegrad
Die kritische Verhältniszahl $CR = \Phi(z^*)$ besitzt eine zweite, sehr praxisnahe Interpretation: Sie entspricht genau der Wahrscheinlichkeit, dass die Nachfrage die Bestellmenge **nicht** übersteigt, also dem sogenannten **Zyklus-Servicegrad** ($\alpha$-Servicegrad) — dem Anteil der Perioden, in denen die gesamte Nachfrage aus der vorhandenen Menge gedeckt werden kann. Für unser Beispiel bedeutet $CR = 0{,}625$: An etwa 62,5 % aller Tage reicht die Bestellmenge $q^*$ aus, um die komplette Tagesnachfrage zu bedienen; an den übrigen rund 37,5 % der Tage kommt es zu einer (teilweisen) Fehlmenge.
Dieser Zusammenhang ist der Grund, warum das Newsvendor-Modell weit über Einperiodenprobleme hinaus Bedeutung hat (die Vorlesung betont: es ist die Basis für die Berechnung kostenoptimaler Sicherheitsbestände in Lagerhaltungssystemen; in Kapitel [-@sec-bullwhip] wird daraus der Ziellagerbestand $S = \mu(l+1) + z_{CR}\,\sigma\sqrt{l+1}$ abgeleitet): Die **Sicherheitsbestände** mehrperiodiger Lagerhaltungssysteme werden in der Praxis sehr häufig genau nach diesem Prinzip bemessen — man legt einen gewünschten Servicegrad fest (z. B. 95 %) und bestimmt daraus über $z = \Phi^{-1}(\text{Servicegrad})$ den erforderlichen Sicherheitsbestandsfaktor, wie es bereits in Kapitel [-@sec-unsicherheit-pooling] im Kontext des Pooling-Effekts anklang. Der Unterschied zum Newsvendor-Modell besteht lediglich darin, *woher* der Zielwert der kritischen Quote stammt: im Newsvendor-Modell wird er aus Kosten hergeleitet ($CR = c^u/(c^u+c^o)$), in vielen operativen Lagerhaltungssystemen dagegen häufig direkt als Managemententscheidung vorgegeben. Zu beachten ist außerdem, dass der hier betrachtete Zyklus-Servicegrad (Wahrscheinlichkeit *keiner* Fehlmenge) nicht mit dem **Fill Rate** verwechselt werden darf, der den Anteil der *mengenmäßig* gedeckten Nachfrage misst und in aller Regel höher ausfällt als der Zyklus-Servicegrad.
## Sensitivitätsanalyse: Wie reagiert das Modell auf veränderte Parameter?
Bislang haben wir das Newsvendor-Modell für feste Werte von $\mu$, $\sigma$, $p$, $c$ und $v$ gelöst. In der Praxis interessiert oft, **wie empfindlich** die optimale Entscheidung auf Veränderungen dieser Parameter reagiert — etwa wenn der Verkaufspreis saisonal schwankt oder die Nachfrageschätzung mit Unsicherheit behaftet ist. Genau dafür eignet sich die **Vektorisierung**, die Sie bereits aus Kapitel [-@sec-standort-1] (`sapply()`) und Kapitel [-@sec-standort-2] (`purrr::map()`) kennen: Statt das Modell für einen einzelnen Parameterwert auszuwerten, wenden wir es auf einen ganzen Vektor möglicher Werte an.
::: {.r-exkurs}
**R-Exkurs: Sensitivitätsanalyse durch Vektorisierung**
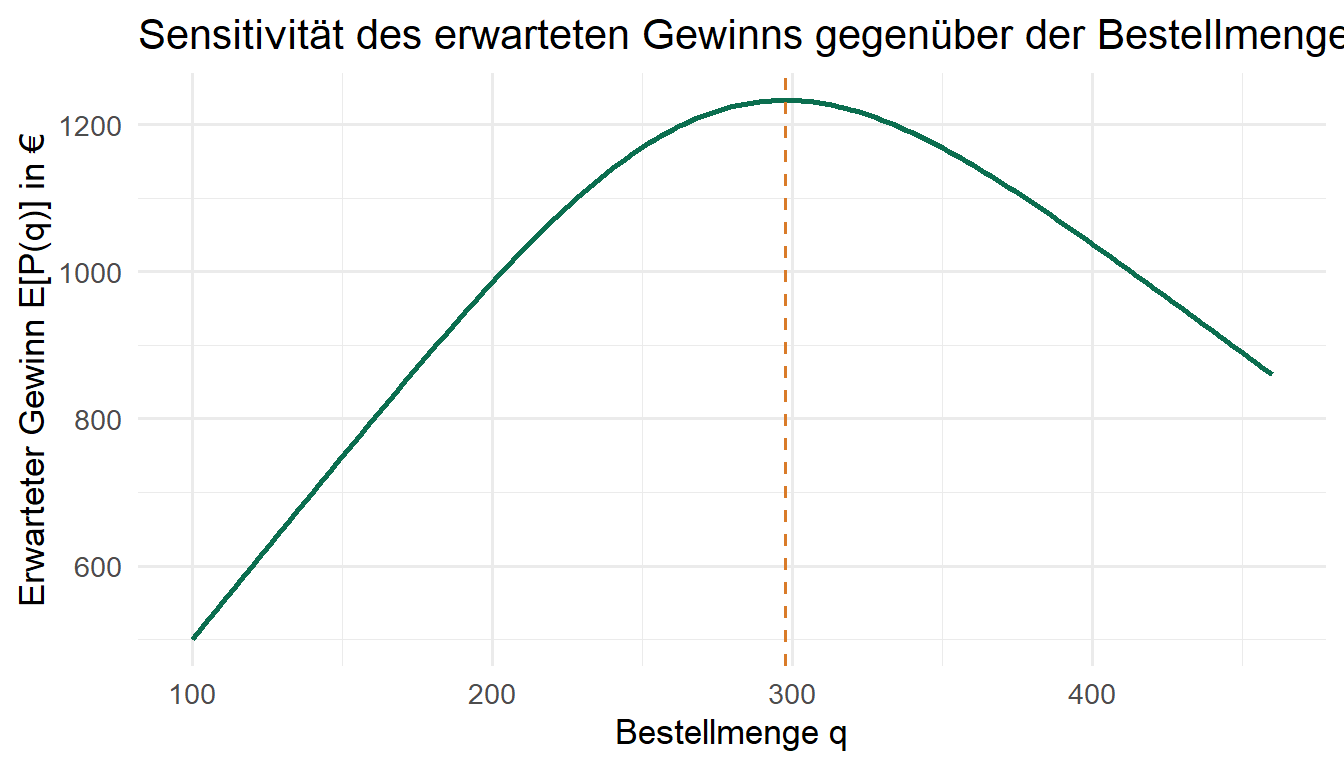
Zunächst untersuchen wir, wie der erwartete Gewinn $E[P(q)]$ über ein feines Raster möglicher Bestellmengen verläuft — für die Filiale Frankfurt also für jede Menge zwischen 100 und 460 Boxen. Dazu kapseln wir die Gewinnformel aus dem Normalverteilungsfall in einer kleinen Funktion und werten sie mit `sapply()` für jeden Rasterpunkt aus:
```{r}
#| label: fig-newsvendor-sensitivitaet-q
#| fig-cap: "Erwarteter Gewinn in Abhängigkeit von der Bestellmenge q"
#| fig-width: 7
#| fig-height: 4
# Modellfunktion: erwarteter Gewinn bei gegebenem q (Normalverteilungsfall)
erwarteter_gewinn_normal <- function(q, mu, sigma, cu, co) {
  z <- (q - mu) / sigma
  L <- function(z) dnorm(z) - z * (1 - pnorm(z))  # Einheits-Normalverlustfunktion
  e_fehlmenge    <- sigma * L(z)
  e_ueberbestand <- sigma * L(-z)
  mu * cu - cu * e_fehlmenge - co * e_ueberbestand
}

q_raster <- seq(100, 460, by = 2)

# sapply() wendet die Funktion auf jeden Wert des Rasters an
gewinn_je_q <- sapply(
  q_raster, erwarteter_gewinn_normal,
  mu = mu_nachfrage, sigma = sigma_nachfrage, cu = cu, co = co
)

sensitivitaet_q <- tibble(bestellmenge = q_raster, erwarteter_gewinn = gewinn_je_q)

ggplot(sensitivitaet_q, aes(x = bestellmenge, y = erwarteter_gewinn)) +
  geom_line(colour = "#0B6E4F", linewidth = 1) +
  geom_vline(xintercept = q_stern_normal, linetype = "dashed", colour = "#D97B29") +
  labs(
    x = "Bestellmenge q", y = "Erwarteter Gewinn E[P(q)] in €",
    title = "Sensitivität des erwarteten Gewinns gegenüber der Bestellmenge"
  ) +
  theme_minimal(base_size = 13)
```
Die Kurve bestätigt anschaulich, was wir bereits analytisch hergeleitet hatten: Der erwartete Gewinn ist eine **konkave** Funktion der Bestellmenge mit eindeutigem Maximum bei $q^*$ — sowohl deutlich kleinere als auch deutlich größere Mengen verringern den erwarteten Gewinn.
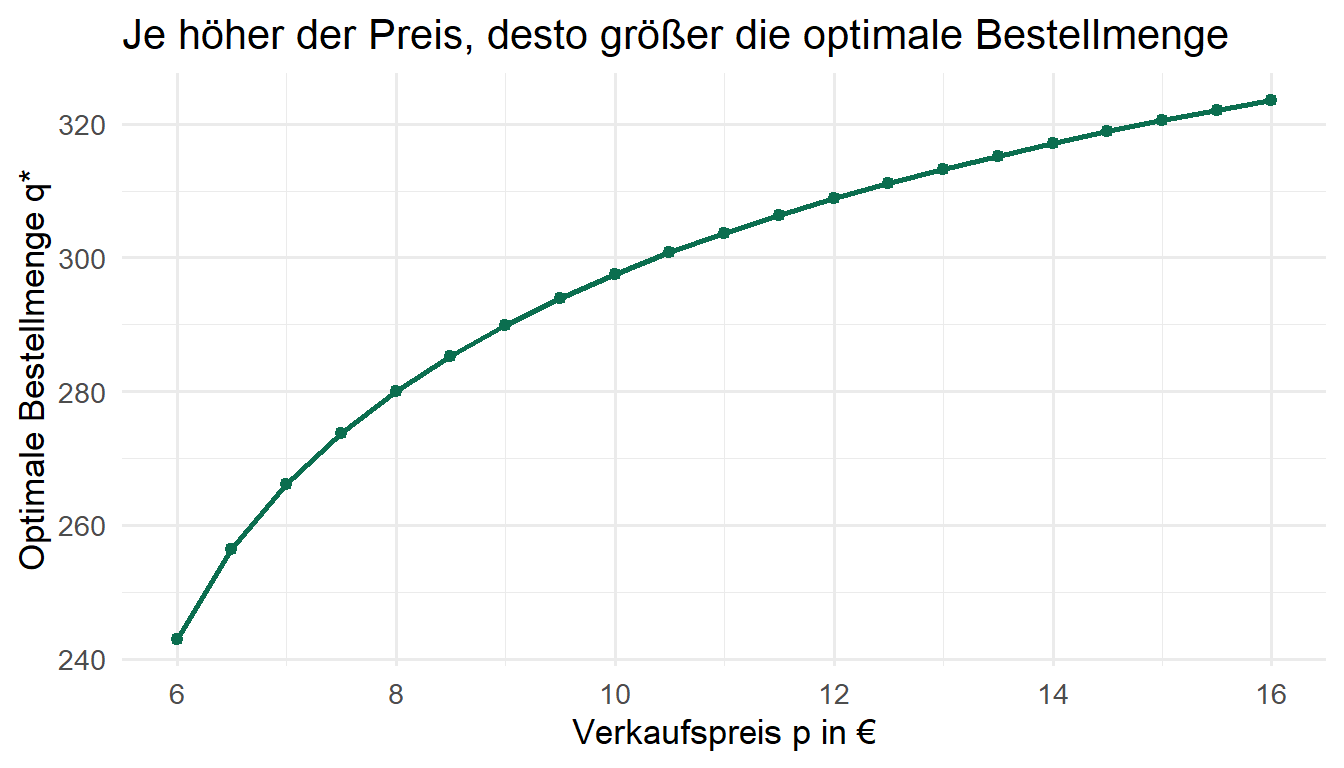
In einem zweiten Schritt untersuchen wir, wie stark sich die *optimale* Bestellmenge selbst verändert, wenn sich der Verkaufspreis $p$ ändert (z. B. durch saisonale Rabattaktionen). Dazu nutzen wir `purrr::map_dbl()`, das — analog zu `sapply()` — eine Funktion über einen Vektor iteriert und garantiert einen numerischen Vektor zurückgibt:
```{r}
#| label: fig-newsvendor-sensitivitaet-preis
#| fig-cap: "Optimale Bestellmenge in Abhängigkeit vom Verkaufspreis"
#| fig-width: 7
#| fig-height: 4
herstellkosten <- 5   # bleibt konstant
restwert       <- 2   # bleibt konstant
preise         <- seq(6, 16, by = 0.5)

q_stern_je_preis <- purrr::map_dbl(preise, function(p) {
  cu_tmp <- p - herstellkosten          # Unterdeckungskosten aendert sich mit p
  cr_tmp <- cu_tmp / (cu_tmp + co)      # co bleibt unveraendert
  mu_nachfrage + sigma_nachfrage * qnorm(cr_tmp)
})

sensitivitaet_preis <- tibble(preis = preise, q_stern = q_stern_je_preis)

ggplot(sensitivitaet_preis, aes(x = preis, y = q_stern)) +
  geom_line(colour = "#0B6E4F", linewidth = 1) +
  geom_point(colour = "#0B6E4F") +
  labs(
    x = "Verkaufspreis p in €", y = "Optimale Bestellmenge q*",
    title = "Je höher der Preis, desto größer die optimale Bestellmenge"
  ) +
  theme_minimal(base_size = 13)
```
Die Grafik zeigt einen intuitiven Zusammenhang: Steigt der Verkaufspreis $p$, steigen die Unterdeckungskosten $c^u = p - c$ und damit auch die kritische Verhältniszahl $CR$ — der Lieferant sollte also tendenziell **mehr** bestellen, weil eine Fehlmenge nun teurer geworden ist. Solche Sensitivitätsanalysen sind in der Praxis oft mindestens so wertvoll wie der einzelne Optimalwert selbst, weil sie zeigen, wie robust eine Entscheidung gegenüber Schätzfehlern oder Marktschwankungen ist.
:::
## Anwendungsbereiche und Grenzen des Modells
Das Newsvendor-Modell entfaltet seinen größten Nutzen dort, wo eine **Bedarfsglättung durch Lagerhaltung nicht möglich** ist und die Kostenparameter $c^u$ und $c^o$ hinreichend gut geschätzt werden können [@thonemann2023operations]. Typische Anwendungsbereiche sind:
- **Saison- und Aktionsartikel** (Weihnachtsartikel, Modewaren einer Saison), bei denen eine Nachbestellung innerhalb der Saison praktisch ausgeschlossen ist,
- **Frischwaren mit kurzer Haltbarkeit** (wie unser Sushi-Beispiel, aber auch Backwaren, Blumen oder Fertiggerichte),
- **Tickets für Veranstaltungen oder Verkehrsmittel**, deren Kapazität am Veranstaltungs- bzw. Abfahrtstag fix ist,
- **Kapazitätsplanung** in der Fertigung, wenn Kapazität nur einmalig vor Beginn einer Periode festgelegt werden kann.
Darüber hinaus ist das Newsvendor-Modell — wie im vorigen Abschnitt gezeigt — die konzeptionelle Grundlage für die Berechnung kostenoptimaler Sicherheitsbestände in mehrperiodigen Lagerhaltungssystemen, was seine praktische Bedeutung weit über den Einzelfall der einmaligen Bestellentscheidung hinaushebt [@silver2017inventory].
Gleichwohl beruht das Modell auf einer Reihe von Annahmen, die in der Praxis kritisch zu prüfen sind: Es wird angenommen, dass die Nachfrageverteilung **bekannt und stationär** ist, dass der Entscheider **risikoneutral** ist (also ausschließlich den *erwarteten* Gewinn maximiert, ohne Risikoaversion gegenüber Verlusten zu berücksichtigen), dass keine **fixen Bestellkosten** anfallen und dass **eine** Bestellentscheidung tatsächlich die gesamte Periode abdeckt. Substitutionseffekte zwischen ähnlichen Produkten, Lerneffekte aus wiederholten Entscheidungen oder das Zusammenspiel mit vor- und nachgelagerten Stufen der Supply Chain — Themen, die uns im nächsten Kapitel zum Bullwhip-Effekt wieder begegnen werden — bleiben im Grundmodell unberücksichtigt und erfordern gegebenenfalls Erweiterungen [@cachon2024matching; @chopra2025supply].
## Zusammenfassung
Das Newsvendor-Modell beantwortet die Frage nach der optimalen Bestellmenge bei einer einmaligen Entscheidung unter unsicherer Nachfrage. Ausgangspunkt sind die Unterdeckungskosten $c^u = p - c$ und die Überdeckungskosten $c^o = c - v$, aus deren Verhältnis sich die kritische Verhältniszahl $CR = c^u/(c^u+c^o)$ ergibt. Diese entspricht sowohl dem Quantil der Nachfrageverteilung, das die optimale Bestellmenge festlegt ($q^* = F^{-1}(CR)$), als auch dem ökonomisch sinnvollen Servicegrad. Bei diskreter Nachfrage wird die kleinste Menge gewählt, deren kumulierte Wahrscheinlichkeit $CR$ mindestens erreicht; bei normalverteilter Nachfrage lässt sich $q^*$ direkt über $\mu + \sigma \cdot \Phi^{-1}(CR)$ berechnen. Methodisch haben Sie gelernt, ein vollständiges Entscheidungsmodell in einer eigenen R-Funktion zu kapseln, mit `uniroot()` und `optimize()` numerisch nach optimalen Lösungen zu suchen, wenn keine geschlossene Formel verfügbar ist, und mit vektorisierten Modellaufrufen (`sapply()`, `purrr::map_dbl()`) Sensitivitätsanalysen durchzuführen und grafisch darzustellen. Diese drei Techniken — eigene Modellfunktionen, numerische Optimierung und vektorisierte Sensitivitätsanalysen — werden uns in den folgenden Kapiteln immer wieder begegnen.
::: {.kontrollfragen}
**Kontrollfragen**
1. Nennen Sie die vier charakteristischen Merkmale, die eine Entscheidungssituation zu einem Newsvendor-Problem machen. Warum eignet sich das Sushi-Beispiel dafür so gut?
2. Definieren Sie Unterdeckungs- und Überdeckungskosten $c^u$ und $c^o$ anhand des Sushi-Beispiels in eigenen Worten. Warum handelt es sich dabei um Opportunitätskosten und nicht um tatsächliche Auszahlungen?
3. Leiten Sie die kritische Verhältniszahl $CR = c^u/(c^u+c^o)$ mithilfe einer Grenzbetrachtung her (was passiert bei einer marginalen Erhöhung der Bestellmenge um eine Einheit?).
4. Ein Zeitschriftenhändler kauft Exemplare für 2 € ein, verkauft sie für 5 € und kann unverkaufte Exemplare für 0,50 € an den Verlag zurückgeben. Die Tagesnachfrage folgt den Szenarien $\{20, 30, 40\}$ mit Wahrscheinlichkeiten $\{0{,}3;\ 0{,}5;\ 0{,}2\}$. Bestimmen Sie $c^u$, $c^o$, $CR$ und die optimale Bestellmenge.
5. Warum liefert die Fraktilregel bei diskreter Nachfrage in der Regel keine exakte Gleichheit $F(q^*)=CR$, während sie es bei stetiger Nachfrage tut? Welche Entscheidungsregel gilt im diskreten Fall?
6. Erklären Sie den Zusammenhang zwischen der kritischen Verhältniszahl und dem Zyklus-Servicegrad. Worin unterscheidet sich der Zyklus-Servicegrad vom Fill Rate?
7. In welchen Situationen würden Sie `uniroot()` bzw. `optimize()` gegenüber einer analytischen Lösungsformel wie $q^* = \mu + \sigma \cdot \Phi^{-1}(CR)$ bevorzugen? Nennen Sie ein Beispiel für eine Nachfrageverteilung, bei der dies sinnvoll ist.
8. Nennen Sie drei typische Anwendungsbereiche des Newsvendor-Modells sowie zwei zentrale Annahmen, die in der Praxis kritisch zu hinterfragen sind.
:::
::: {.callout-tip}
## Übungen und Fallstudie
Aufgaben zur Klausurvorbereitung mit ausklappbaren Musterlösungen (Teil 1) und eine vertiefende Gruppenfallstudie (Teil 2) zu diesem Kapitel finden Sie in **[Fallstudie 5: Das Newsvendor-Modell in der Praxis](https://tkirschstein.github.io/SCM_BDBM/case_studies/case_study_05_newsvendor_baeckerei)**.
:::