# Transportplanung {#sec-transportplanung}
```{r}
#| label: chtp-setup
#| echo: false
#| warning: false
#| message: false
# Funktionen aus scm_functions.R einbinden (u. a. vogels_approximation())
source("../R/scm_functions.R")
source("../R/scm_helpers.R") # Darstellungshilfen (Farben, Tabellen, Formatierung)
library(tidyverse)
library(knitr)
library(kableExtra)
# Inline-Zahlen im Fließtext deutsch formatieren (Dezimalkomma, Tausenderpunkt)
knitr::knit_hooks$set(inline = function(x) {
if (is.numeric(x)) format(x, big.mark = ".", decimal.mark = ",") else x
})
```
::: {.lernziele}
**Lernziele**
Nach diesem Kapitel können Sie …
- das klassische **Transportproblem** als lineares Optimierungsmodell **formulieren**,
- balancierte und unbalancierte Transportprobleme **unterscheiden** und durch Dummy-Knoten **ausgleichen**,
- Startlösungen mit der **Nordwestecken-Regel** und der **Vogel'schen Approximationsmethode (VAM)** **berechnen**,
- die Lösungsqualität heuristischer Verfahren im Vergleich zur LP-Optimallösung **beurteilen**,
- einen Algorithmus mit einer `while`-Schleife implementieren, der seine Zwischenschritte in einer Liste **protokolliert**, und gezielt einzelne Zellen einer Matrix über **Indexmatrizen** ansprechen.
**Literatur zur Vertiefung**
- Transport- und Netzwerkmodelle: @guenther2012produktion, Kapitel 4.
- Transportproblem und Lösungsverfahren (Tableau, VAM, MODI): @domschke2007transport.
- Ursprung der Vogel'schen Approximationsmethode: @reinfeld1958mathematical.
:::
## Vom Warehouse Location Problem zum Transportproblem
Das Warehouse Location Problem aus Kapitel [-@sec-standort-2] hat zwei Fragen **gleichzeitig** beantwortet: *Welche* Standorte werden geöffnet, und *welche* Filiale wird von welchem Standort beliefert? Für SushiFresh war das Ergebnis eine Zentralküche in Raunheim. Ist diese strategische Entscheidung gefallen, bleibt im laufenden Betrieb häufig nur noch die zweite Frage offen. Schwierig wird sie, sobald die Standorte **Kapazitätsgrenzen** haben. Im unkapazitierten WLP wird jede Filiale einfach vom nächstgelegenen geöffneten Standort beliefert. Reicht die Kapazität des günstigsten Standorts aber nicht für alle zugeordneten Filialen, muss die Ware **verteilt** werden. Genau das leistet das **Transportproblem**: Bei gegebenen Standorten (Quellen) mit begrenztem Angebot und gegebenen Kunden (Senken) mit festem Bedarf wird ein kostenminimaler Transportplan gesucht.
Das Transportproblem ist eines der ältesten Modelle des Operations Research [@hitchcock1941distribution]. Es liegt an der Grenze zwischen taktischer und operativer Planung: Es wird für Wochen- oder Tagespläne gelöst, setzt aber eine gegebene Netzstruktur voraus.
## Fallbeispiel: Das Weihnachtsgeschäft
::: {.fallstudie}
**Fallstudie: Drei Küchen für die Adventszeit**
Im Normalbetrieb beliefert die Zentralküche **Raunheim** alle sechs Filialen. Für die **Adventszeit** erwartet SushiFresh eine um rund **40 %** höhere Nachfrage. Raunheim kann im Schichtbetrieb höchstens **850 Boxen pro Tag** produzieren, die Nachfrage steigt aber auf 1.183 Boxen. Die Geschäftsführung mietet deshalb für vier Wochen zwei **Cateringküchen** an früheren Kandidatenstandorten aus Kapitel [-@sec-standort-2] an: **Wiesbaden-Erbenheim** (200 Boxen/Tag) und **Neu-Isenburg** (133 Boxen/Tag).
Die Standorte stehen damit fest. Offen ist: **Welche Küche beliefert welche Filiale mit wie vielen Boxen**, sodass die täglichen Transportkosten minimal sind?
:::
Die Transportkosten je Box übernehmen wir aus der Kostenmatrix von Kapitel [-@sec-standort-2]. Die Nachfrage wird um 40 % hochgerechnet und gerundet.
```{r}
#| label: chtp-daten
filialen <- tibble(
  ID  = paste0("C", 1:6),
  Ort = c("Wiesbaden", "Mainz", "Frankfurt", "Rüsselsheim", "Darmstadt", "Offenbach"),
  mu  = c(120, 150, 280, 90, 110, 95)
) |>
  mutate(Dez = round(mu * 1.4))

kuechen <- tibble(
  ID = c("S3", "S1", "S5"),
  Standort = c("Raunheim (Zentralküche)", "Wiesbaden-Erbenheim", "Neu-Isenburg"),
  Kapazitaet = c(850, 200, 133)
)

# Transportkosten in EUR je Box (Zeilen aus der Kostenmatrix des WLP-Kapitels)
kosten <- matrix(
  c(0.48168, 0.27202, 0.17036, 0.54650, 0.44772, 0.12592,   # S3 Raunheim
    0.12348, 0.41478, 0.47474, 0.55152, 0.85996, 0.18220,   # S1 WI-Erbenheim
    0.50226, 0.87512, 0.90576, 0.60740, 0.32042, 0.11400),  # S5 Neu-Isenburg
  nrow = 3, byrow = TRUE,
  dimnames = list(kuechen$ID, filialen$ID)
)

angebot   <- setNames(kuechen$Kapazitaet, kuechen$ID)
nachfrage <- setNames(filialen$Dez, filialen$ID)

c(Angebot = sum(angebot), Nachfrage = sum(nachfrage))
```
Angebot und Nachfrage sind mit je 1.183 Boxen genau ausgeglichen.
## Das Modell
::: {.definition}
**Definition: Transportproblem**
Beim (klassischen) Transportproblem sind $m$ Quellen $i \in I$ mit Angebotsmengen $s_i$ und $n$ Senken $j \in J$ mit Nachfragemengen $a_j$ gegeben. Für jede Verbindung $(i,j)$ fallen Transportkosten $c_{ij}$ je transportierter Einheit an. Gesucht ist eine kostenminimale Verteilung der Angebotsmengen auf die Nachfragemengen. Das Problem heißt **balanciert**, wenn $\sum_i s_i = \sum_j a_j$ gilt, andernfalls **unbalanciert**.
:::
Mit den Transportmengen $x_{ij} \geq 0$ als Entscheidungsvariablen lautet das lineare Optimierungsmodell:
$$
\begin{align}
\min \quad & \sum_{i \in I} \sum_{j \in J} c_{ij} \cdot x_{ij} \\
\text{u.d.N.} \quad & \sum_{j \in J} x_{ij} \leq s_i & \forall i \in I \quad &\rightarrow \text{Kapazität nicht überschreiten} \\
& \sum_{i \in I} x_{ij} = a_j & \forall j \in J \quad &\rightarrow \text{Nachfrage exakt decken} \\
& x_{ij} \geq 0 & \forall (i,j) &\quad \rightarrow \text{Nichtnegativität}
\end{align}
$$
Im Vergleich zum WLP fehlen die binären Standortvariablen $y_i$ und die Fixkosten. Dafür sind die Kapazitäten $s_i$ der Quellen bindend. Weil Zielfunktion und Nebenbedingungen linear sind, handelt es sich um ein reines **lineares Optimierungsproblem**.
::: {.vertiefung}
**Theorie-Vertiefung: Warum Transportprobleme „von selbst“ ganzzahlige Lösungen liefern**
Die Nebenbedingungsmatrix des Transportproblems hat eine besondere Struktur: Jede Variable $x_{ij}$ taucht in genau zwei Nebenbedingungen auf, einmal in der Angebotszeile von $i$ und einmal in der Nachfragezeile von $j$, jeweils mit dem Koeffizienten 1. Matrizen mit dieser Struktur sind **total unimodular**: Jede quadratische Teilmatrix hat die Determinante 0, +1 oder −1. Nach der Cramer'schen Regel ist dann jede Ecke des Lösungspolyeders ganzzahlig, sofern Angebot und Nachfrage ganzzahlig sind. Obwohl das Transportproblem als LP mit kontinuierlichen Variablen gelöst wird, erhält man also automatisch ganzzahlige Transportmengen. Niemand muss „halbe Boxen“ nachträglich runden.
Eine zweite Eigenschaft betrifft die Zahl der genutzten Verbindungen: Eine Basislösung eines balancierten Transportproblems hat höchstens $m + n - 1$ positive Variablen. Bei drei Küchen und sechs Filialen werden also höchstens **acht** der 18 möglichen Verbindungen genutzt. Die meisten Filialen werden von genau einer Küche beliefert, nur wenige werden aufgeteilt.
:::
### Unbalancierte Probleme
Ist das Angebot größer als die Nachfrage, ergänzt man eine **Dummy-Senke** mit der Nachfrage $\sum_i s_i - \sum_j a_j$ und Kosten $c_{i,\text{Dummy}} = 0$. Lieferungen an die Dummy-Senke stehen für **ungenutzte Kapazität**. Ist die Nachfrage größer als das Angebot, ergänzt man eine **Dummy-Quelle**, deren Kosten den **Fehlmengenkosten** entsprechen, etwa dem entgangenen Deckungsbeitrag wie im Newsvendor-Modell (Kapitel [-@sec-newsvendor]). Ihre Lieferungen sind nicht bediente Nachfrage. In beiden Fällen entsteht ein balanciertes Problem, auf das alle folgenden Verfahren anwendbar sind.
## Eröffnungsverfahren
Zur Lösung von Transportproblemen wurden **Tableau-Verfahren** entwickelt, die auf der Simplex-Idee aufbauen, aber die spezielle Struktur ausnutzen [@domschke2007transport]. Sie arbeiten in zwei Phasen: Ein **Eröffnungsverfahren** konstruiert eine zulässige Startlösung, ein **Verbesserungsverfahren** (Stepping-Stone- oder MODI-Methode) verbessert sie schrittweise bis zum Optimum. Gängige Eröffnungsverfahren sind:
- die **Nordwestecken-Regel**, die die Kosten ignoriert,
- die **Matrixminimum-Methode**, die stets die insgesamt günstigste noch freie Zelle beliefert, und
- die **Vogel'sche Approximationsmethode (VAM)**, die Opportunitätskosten (Differenzen zwischen kleinstem und zweitkleinstem Kostensatz) berücksichtigt.
Wir behandeln die Nordwestecken-Regel und die VAM ausführlich und lösen das Problem anschließend exakt mit einem LP-Solver. Die Matrixminimum-Methode ist intuitiv, kann aber in eine Sackgasse laufen: Wer zuerst die billigsten Zellen belegt, muss die Restmengen am Ende oft über sehr teure Verbindungen verteilen – genau dieses Problem vermeidet die VAM.
### Nordwestecken-Regel
Die Nordwestecken-Regel beginnt in der linken oberen Zelle des Tableaus (Zeile 1, Spalte 1) und transportiert dort so viel wie möglich, also $\min(\text{Restangebot}_i, \text{Restnachfrage}_j)$. Ist das Angebot erschöpft, geht sie eine Zeile nach unten, sonst eine Spalte nach rechts. Das wiederholt sich, bis die gesamte Nachfrage gedeckt ist.
::: {.r-exkurs}
**R-Exkurs: Ein Algorithmus mit `while` und Zustandsvariablen**
Die Nordwestecken-Regel lässt sich mit einer `while`-Schleife (Kapitel [-@sec-standort-1]) direkt umsetzen. Der **Zustand** des Algorithmus besteht aus der aktuellen Zeile `i`, der aktuellen Spalte `j` sowie den Restmengen. Diese Variablen werden in jedem Durchlauf aktualisiert, bis die Abbruchbedingung erreicht ist. Wichtig: `supply` und `demand` werden *innerhalb* der Funktion als **Kopien** verändert. R übergibt Argumente an Funktionen als Werte, die Originalvektoren außerhalb bleiben unverändert.
```{r}
#| label: chtp-nw
nw_corner <- function(supply, demand) {
  a <- matrix(0, length(supply), length(demand),
              dimnames = list(names(supply), names(demand)))
  i <- 1; j <- 1                                # Start in der Nordwestecke
  while (i <= length(supply) && j <= length(demand)) {
    q <- min(supply[i], demand[j])              # so viel wie möglich
    a[i, j] <- q
    supply[i] <- supply[i] - q                  # Restmengen aktualisieren
    demand[j] <- demand[j] - q
    if (supply[i] == 0) i <- i + 1 else j <- j + 1
  }
  a
}

x_nw <- nw_corner(angebot, nachfrage)
x_nw
```
:::
Die Kosten dieser Lösung erhält man als Summe der elementweisen Produkte von Transport- und Kostenmatrix:
```{r}
#| label: chtp-nw-kosten
kosten_nw <- sum(x_nw * kosten)
round(kosten_nw, 2)
```
Die Nordwestecken-Lösung kostet `r round(kosten_nw, 2)` € pro Tag. Ein Blick auf die Matrix zeigt das Problem: Die Filiale Darmstadt (C5) wird komplett aus Wiesbaden-Erbenheim beliefert, mit `r kosten["S1", "C5"]` € je Box die teuerste Verbindung der gesamten Matrix. Die Regel richtet sich allein nach der **Reihenfolge** der Zeilen und Spalten, die Kosten spielen keine Rolle.
### Vogel'sche Approximationsmethode
Die **Vogel'sche Approximationsmethode** [@reinfeld1958mathematical] berücksichtigt die Kosten auf geschickte Weise. Ihre Leitfrage lautet: **Wo wäre eine falsche Entscheidung am teuersten?** Dazu berechnet sie für jede Zeile und jede Spalte eine **Strafkosten-Differenz** (*penalty*):
$$\Delta = c_{(2)} - c_{(1)},$$
die Differenz zwischen der zweitgünstigsten und der günstigsten noch verfügbaren Zelle. Ein großes $\Delta$ bedeutet: Kann diese Zeile oder Spalte nicht über ihre günstigste Zelle bedient werden, kostet jede Einheit mindestens $\Delta$ mehr. Das sind Opportunitätskosten.
Ein Beispiel aus dem Fall: In der Spalte Wiesbaden (C1) ist Wiesbaden-Erbenheim mit `r kosten["S1","C1"]` € je Box die günstigste Küche, die zweitgünstigste ist Raunheim mit `r kosten["S3","C1"]` €. Muss Wiesbaden aus Raunheim beliefert werden, kostet das `r round(diff(sort(kosten[,"C1"]))[1], 3)` € mehr je Box, bei `r nachfrage["C1"]` Boxen also bis zu `r round(diff(sort(kosten[,"C1"]))[1] * nachfrage["C1"], 2)` € pro Tag.
Der Algorithmus lautet:
1. Berechne für jede aktive Zeile und Spalte die Strafkosten-Differenz $\Delta$.
2. Wähle die Zeile oder Spalte mit dem **größten** $\Delta$.
3. Wähle darin die **günstigste** aktive Zelle $(i^*, j^*)$.
4. Transportiere $x_{i^*j^*} = \min(s_{i^*}, a_{j^*})$ und aktualisiere Restangebot und Restnachfrage.
5. Streiche die erschöpfte Zeile bzw. Spalte und beginne von vorn, solange aktive Zeilen und Spalten existieren.
Mit jeder gestrichenen Zeile oder Spalte ändert sich die Menge der verfügbaren Zellen. Die Penalties müssen deshalb **in jeder Iteration neu** berechnet werden. Bleibt in einer Zeile oder Spalte nur noch eine Zelle übrig, ist $\Delta = 0$, und die Zuordnung ist ohnehin erzwungen.
::: {.r-exkurs}
**R-Exkurs: Einen Algorithmus protokollieren**
Um die VAM Schritt für Schritt nachzuvollziehen, schreiben wir eine Variante, die nicht nur das Endergebnis liefert, sondern den **Zustand jeder Iteration** in einer Liste ablegt. Das Muster ist allgemein nützlich: Vor der Schleife wird eine leere Liste `schritte <- list()` angelegt, und in jedem Durchlauf hängt `schritte[[length(schritte) + 1]] <- ...` ein neues Element an. Drei Hilfsfunktionen kommen hinzu: `setdiff()` entfernt gestrichene Zeilen oder Spalten aus der Menge der aktiven Indizes, `which.max()` liefert die Position des größten Penalties, und `sort()` sortiert die Kosten einer Zeile, sodass $c_{(1)}$ und $c_{(2)}$ an den ersten beiden Positionen stehen.
```{r}
#| label: chtp-vam-trace
vam_trace <- function(cost, supply, demand) {
  alloc <- matrix(0, nrow(cost), ncol(cost), dimnames = dimnames(cost))
  zeilen <- seq_len(nrow(cost)); spalten <- seq_len(ncol(cost))
  penalty <- function(v) { v <- sort(v); if (length(v) >= 2) v[2] - v[1] else 0 }
  schritte <- list()
  while (length(zeilen) > 0 && length(spalten) > 0) {
    rp <- sapply(zeilen,  function(i) penalty(cost[i, spalten]))
    cp <- sapply(spalten, function(j) penalty(cost[zeilen, j]))
    if (max(rp) >= max(cp)) {                       # Zeile hat größtes Delta
      i <- zeilen[which.max(rp)]; j <- spalten[which.min(cost[i, spalten])]
      wahl <- paste("Zeile", rownames(cost)[i]); delta <- max(rp)
    } else {                                        # Spalte hat größtes Delta
      j <- spalten[which.max(cp)]; i <- zeilen[which.min(cost[zeilen, j])]
      wahl <- paste("Spalte", colnames(cost)[j]); delta <- max(cp)
    }
    q <- min(supply[i], demand[j])
    alloc[i, j] <- q
    supply[i] <- supply[i] - q; demand[j] <- demand[j] - q
    gestrichen <- c(if (supply[i] == 0) rownames(cost)[i],
                    if (demand[j] == 0) colnames(cost)[j])
    if (supply[i] == 0) zeilen  <- setdiff(zeilen, i)
    if (demand[j] == 0) spalten <- setdiff(spalten, j)
    schritte[[length(schritte) + 1]] <- tibble(
      Iteration = length(schritte) + 1, Wahl = wahl, Delta = round(delta, 3),
      Zelle = paste(rownames(cost)[i], "→", colnames(cost)[j]), Menge = q,
      Kosten = round(q * cost[i, j], 2), gestrichen = paste(gestrichen, collapse = ", "))
  }
  list(allocation = alloc, total_cost = sum(alloc * cost),
       protokoll = bind_rows(schritte))
}
```
`bind_rows()` fügt am Ende alle Einzeltabellen der Liste zu einem gemeinsamen Protokoll zusammen.
:::
```{r}
#| label: chtp-vam-protokoll
vam <- vam_trace(kosten, angebot, nachfrage)

kbl(vam$protokoll, booktabs = TRUE,
    caption = "Iterationen der Vogel'schen Approximationsmethode") |>
  kable_styling(full_width = FALSE, bootstrap_options = c("striped", "condensed"))
```
Das Protokoll macht die Logik der Methode sichtbar. In der ersten Iteration hat die Spalte **Wiesbaden** mit `r vam$protokoll$Delta[1]` das größte Penalty und wird über ihre günstigste Zelle, Wiesbaden-Erbenheim, vollständig bedient. Danach folgt **Frankfurt** mit der größten Nachfrage, vollständig aus Raunheim. In der dritten Iteration ist erstmals eine **Zeile** ausschlaggebend: Wiesbaden-Erbenheim hat nach dem Streichen von C1 nur noch teure Alternativen, sein Penalty steigt auf `r vam$protokoll$Delta[3]`, und die verbleibenden 32 Boxen gehen nach Offenbach. Die Methode benötigt genau $m + n - 1 = 8$ Iterationen. In der letzten ist $\Delta = 0$, weil nur noch eine Zelle übrig ist.
```{r}
#| label: chtp-vam-ergebnis
vam$allocation
c(Kosten = round(vam$total_cost, 2))
# Zulässigkeit: Zeilensummen = Angebot, Spaltensummen = Nachfrage
all(rowSums(vam$allocation) == angebot, colSums(vam$allocation) == nachfrage)
```
Die Funktion `vogels_approximation()` aus `R/scm_functions.R` implementiert dasselbe Verfahren und ergänzt bei unbalancierten Problemen automatisch eine Dummy-Quelle bzw. -Senke. Für den balancierten Fall liefert sie dasselbe Ergebnis:
```{r}
#| label: chtp-vam-fun
round(vogels_approximation(kosten, angebot, nachfrage)$total_cost, 2)
```
## Exakte Lösung als lineares Programm
Wie gut ist die VAM-Lösung? Weil das Transportproblem ein LP ist, lässt es sich mit `ompr` (Kapitel [-@sec-standort-2]) exakt lösen. Gegenüber dem WLP sind alle Variablen **kontinuierlich** (`type = "continuous"`), und es gibt keine Fixkosten.
```{r}
#| label: chtp-lp
#| message: false
library(ompr)
library(ompr.roi)
library(ROI.plugin.glpk)

m <- nrow(kosten); n <- ncol(kosten)

tp_modell <- MIPModel() |>
  add_variable(x[i, j], i = 1:m, j = 1:n, type = "continuous", lb = 0) |>
  set_objective(sum_expr(kosten[i, j] * x[i, j], i = 1:m, j = 1:n), "min") |>
  add_constraint(sum_expr(x[i, j], j = 1:n) <= angebot[i], i = 1:m) |>
  add_constraint(sum_expr(x[i, j], i = 1:m) == nachfrage[j], j = 1:n)

tp_loesung <- solve_model(tp_modell, with_ROI(solver = "glpk"))
kosten_opt <- objective_value(tp_loesung)
```
::: {.r-exkurs}
**R-Exkurs: Matrixzellen über Indexmatrizen ansprechen**
`get_solution()` liefert die Lösung als lange Tabelle mit den Spalten `i`, `j` und `value`. Um daraus wieder eine Transportmatrix zu machen, nutzen wir eine Besonderheit der Matrixindizierung: Übergibt man einer Matrix in eckigen Klammern eine **zweispaltige Matrix** aus Zeilen- und Spaltenindizes, werden genau diese Zellen angesprochen. `cbind(c(1, 2), c(3, 1))` adressiert also die Zellen (1,3) und (2,1). So lassen sich viele Einzelzellen in einem Schritt lesen oder beschreiben, ohne Schleife.
```{r}
#| label: chtp-indexmatrix
x_tab <- get_solution(tp_loesung, x[i, j]) |> filter(value > 1e-6)
x_opt <- matrix(0, m, n, dimnames = dimnames(kosten))
x_opt[cbind(x_tab$i, x_tab$j)] <- x_tab$value    # alle Zellen auf einmal setzen
x_opt
```
:::
```{r}
#| label: chtp-vergleich
#| fig-cap: "Transportkosten der drei Verfahren"
vergleich <- tibble(
  Verfahren = factor(c("Nordwestecke", "VAM", "LP-Optimum"),
                     levels = c("Nordwestecke", "VAM", "LP-Optimum")),
  Kosten = c(kosten_nw, vam$total_cost, kosten_opt)
) |>
  mutate(Abweichung = Kosten / kosten_opt - 1)

ggplot(vergleich, aes(x = Verfahren, y = Kosten, fill = Verfahren)) +
  geom_col(show.legend = FALSE) +
  geom_text(aes(label = paste0(round(Kosten, 2), " €")), vjust = -0.4) +
  scale_fill_manual(values = c("#9AA5B1", "#52B788", "#0B6E4F")) +
  labs(x = NULL, y = "Transportkosten (€/Tag)") +
  theme_minimal(base_size = 13)
```
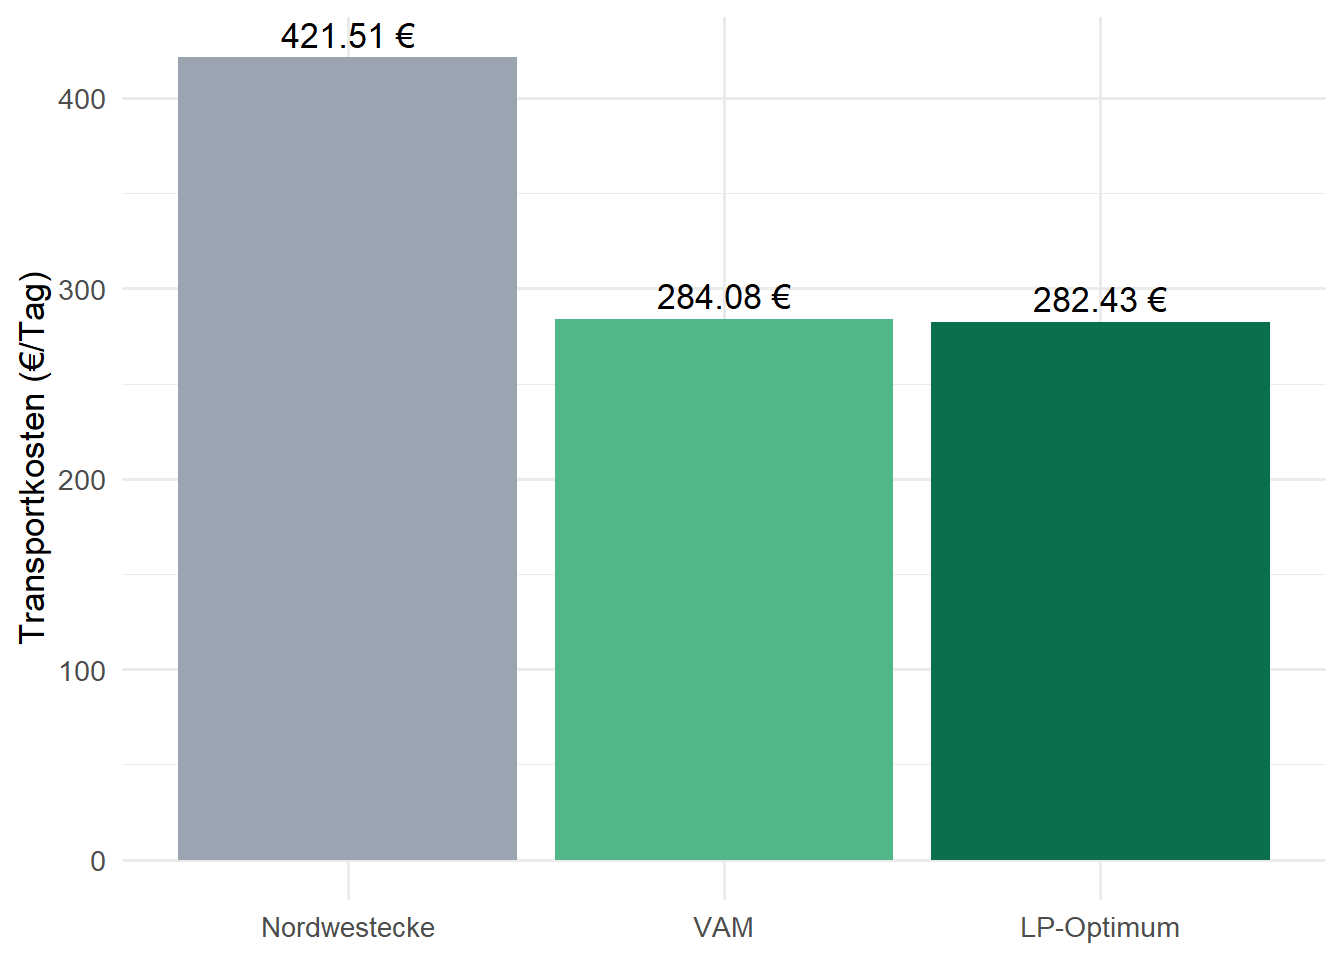
Die VAM liegt nur **`r round(vergleich$Abweichung[2] * 100, 1)` %** über dem Optimum, die Nordwestecken-Regel dagegen **`r round(vergleich$Abweichung[1] * 100, 0)` %**. Der Unterschied zwischen VAM und Optimum betrifft allein die Aufteilung der Filialen Rüsselsheim und Offenbach zwischen Raunheim und Wiesbaden-Erbenheim. Über die vier Adventswochen (24 Liefertage) spart der optimale Plan gegenüber der Nordwestecke rund `r format(round(24 * (kosten_nw - kosten_opt)), big.mark = ".", decimal.mark = ",")` €, gegenüber der VAM nur `r round(24 * (vam$total_cost - kosten_opt))` €.
::: {.vertiefung}
**Theorie-Vertiefung: Verbesserungsverfahren und Dualität**
Ein Eröffnungsverfahren liefert eine Basislösung mit $m + n - 1$ Basisvariablen. Ob sie optimal ist, prüft die **MODI-Methode** (*modified distribution*) mit den Dualvariablen des LP: Für jede Zeile $i$ wird ein Potenzial $u_i$ und für jede Spalte $j$ ein Potenzial $v_j$ so bestimmt, dass für alle Basiszellen $c_{ij} = u_i + v_j$ gilt. Für die Nichtbasiszellen ergeben sich daraus die **reduzierten Kosten** $\bar{c}_{ij} = c_{ij} - u_i - v_j$. Sind alle $\bar{c}_{ij} \geq 0$, ist die Lösung optimal. Andernfalls wird die Zelle mit den negativsten reduzierten Kosten in die Basis aufgenommen und entlang eines geschlossenen Zyklus (*stepping stone*) umverteilt. Ökonomisch sind $u_i$ und $v_j$ **Schattenpreise**: Sie geben an, um wie viel sich die Gesamtkosten ändern, wenn Küche $i$ eine Box mehr anbietet bzw. Filiale $j$ eine Box mehr nachfragt. Moderne LP-Solver führen diese Schritte intern aus. Die Interpretation der Schattenpreise bleibt aber auch für die Praxis wertvoll.
:::
## Grenzen des Modells
Das Transportproblem beruht auf zwei Annahmen, die in den folgenden Kapiteln aufgehoben werden:
- **Die Kosten $c_{ij}$ sind gegeben.** In der Praxis müssen sie aus Fahrzeugkosten und Entfernungen im Straßennetz abgeleitet werden. Wie man Kostensätze je Kilometer berechnet, zeigt Kapitel [-@sec-verkehrsmittel]. Wie man kürzeste Entfernungen im Straßennetz bestimmt, zeigt Kapitel [-@sec-kuerzeste-wege].
- **Die Kosten sind linear in der Menge.** Das Modell unterstellt Direktverkehre (Pendelfahrten), deren Kosten proportional zur Menge sind. Tatsächlich fährt ein Kühlfahrzeug mehrere Filialen nacheinander an, und die Kosten hängen von der Fahrstrecke ab, nicht von der Zahl der Boxen. Das ist Gegenstand der Tourenplanung in Kapitel [-@sec-tourenplanung].
Weitere Erweiterungen sind Umschlagpunkte (*Transshipment*), mehrere Produkte, Kapazitäten auf Verbindungen oder Mindestmengen je Fahrt. Letztere machen das Modell wieder zu einem gemischt-ganzzahligen Problem.
## Zusammenfassung
Das **Transportproblem** verteilt die Angebotsmengen gegebener Quellen kostenminimal auf die Nachfragemengen gegebener Senken. Es ist ein Spezialfall des WLP mit festen Standorten und bindenden Kapazitäten, ein reines LP mit ganzzahligen Optimallösungen und höchstens $m + n - 1$ genutzten Verbindungen. Unbalancierte Probleme werden über Dummy-Quellen bzw. -Senken ausgeglichen. Die **Nordwestecken-Regel** liefert schnell eine zulässige, aber kostenblinde Startlösung. Die **Vogel'sche Approximationsmethode** priorisiert Zeilen und Spalten mit hohen Opportunitätskosten und lag im Weihnachtsszenario von SushiFresh weniger als ein Prozent über dem Optimum. Mit `ompr` lässt sich das Modell in wenigen Zeilen exakt lösen.
Auf der R-Seite haben Sie Algorithmen mit `while`-Schleifen und Zustandsvariablen umgesetzt, Zwischenschritte in einer Liste protokolliert und mit `bind_rows()` zusammengeführt sowie Matrixzellen über Indexmatrizen (`cbind()`) gezielt angesprochen.
::: {.kontrollfragen}
**Kontrollfragen**
1. Formulieren Sie Zielfunktion und Nebenbedingungen des Transportproblems. Worin unterscheidet es sich vom Warehouse Location Problem?
2. Was bedeutet es, wenn ein Transportproblem unbalanciert ist? Wie werden Über- und Unterkapazität ausgeglichen, und wie sind die Kosten der Dummy-Knoten zu interpretieren?
3. Warum liefert die LP-Lösung eines Transportproblems bei ganzzahligen Angebots- und Nachfragemengen automatisch ganzzahlige Transportmengen?
4. Erläutern Sie die Grundidee der Vogel'schen Approximationsmethode. Warum liefert sie in der Regel bessere Startlösungen als die Nordwestecken-Regel?
5. Führen Sie die ersten beiden Iterationen der VAM für das Weihnachtsszenario von Hand durch und vergleichen Sie Ihr Ergebnis mit dem Protokoll.
6. Am 18. Dezember fällt in Raunheim eine Kühlzelle aus, die Kapazität sinkt auf 700 Boxen. Formulieren Sie das unbalancierte Problem mit einer Dummy-Küche, deren Kosten dem entgangenen Deckungsbeitrag von 4,50 € je Box entsprechen, und lösen Sie es mit `vogels_approximation()` und `ompr`. Welche Filialen erhalten weniger Ware?
7. Was geben die Potenziale $u_i$ und $v_j$ der MODI-Methode ökonomisch an?
8. Welche Annahmen des Transportproblems sind für die tägliche Belieferung der Filialen unrealistisch, und welche Modelle heben sie auf?
:::
::: {.callout-tip}
## Übungen und Fallstudie
Aufgaben zur Klausurvorbereitung mit ausklappbaren Musterlösungen (Teil 1) und eine vertiefende Gruppenfallstudie (Teil 2) zu diesem Kapitel finden Sie in **[Fallstudie 3: Diskrete Standortplanung und Transportplanung](https://tkirschstein.github.io/SCM_BDBM/case_studies/case_study_03_wlp_batterielogistik)**.
:::