# Der Bullwhip-Effekt und das Beergame {#sec-bullwhip}
```{r ch8-setup}
#| include: false
library(dplyr)
library(tidyr)
library(ggplot2)
library(knitr)
library(kableExtra)
# Funktionen aus scm_functions.R einbinden (u. a. simuliere_tS())
source("../R/scm_functions.R")
source("../R/scm_helpers.R") # Darstellungshilfen (Farben, Tabellen, Formatierung)
# Farben für die Grafiken dieses Kapitels
farbe_nachfrage <- "#1F4E79"
farbe_bestellung <- "#C00000"
farbe_bestand <- "#70AD47"
```
::: {.lernziele}
**Lernziele**
Nach diesem Kapitel können Sie …
- den Bullwhip-Effekt entlang einer Supply Chain **erklären**,
- wesentliche **Ursachen und Folgen** des Bullwhip-Effekts **beurteilen**,
- Order-up-to-Level $S$ und Sicherheitsbestand $SB$ **bestimmen**,
- Maßnahmen zur Reduktion des Bullwhip-Effekts **einordnen**,
- Zeitreihen in R als Vektoren begreifen und mit `diff()` sowie `dplyr::lag()` analysieren,
- eine mehrstufige Lieferkette in einer eigenen Simulationsschleife in R abbilden und gefacettet visualisieren.
**Literatur zur Vertiefung**
- Grundlegende Ursachen und Gegenmaßnahmen des Bullwhip-Effekts: @thonemann2023operations, Kapitel 8, insbesondere 8.2.
- Empirische Untersuchung der Informationsübertragung: @bray2012information.
- Messung, Aggregation und Wirkung von Bullwhip-Effekten: @yao2020empirically.
:::
## Von der einzelnen Stufe zur Kette
In den vorangegangenen Kapiteln haben wir Unsicherheit stets aus der Perspektive **einer einzelnen** Stufe einer Supply Chain betrachtet: Ein Händler oder Produzent kennt (näherungsweise) die Verteilung der Nachfrage, bildet daraus einen Sicherheitsbestand und legt einen Ziellagerbestand fest, der einen gewünschten Servicegrad realisiert. Das Pooling-Prinzip und das Newsvendor-Modell beantworten damit die Frage: *Wie viel sollte eine Stufe bevorraten, wenn sie mit unsicherer Nachfrage konfrontiert ist?*
In der Realität ist aber praktisch jede Stufe einer Supply Chain gleichzeitig Kunde einer vorgelagerten und Lieferant einer nachgelagerten Stufe. Die "Nachfrage", mit der sich ein Großhändler auseinandersetzen muss, ist nicht die Nachfrage der Endkonsumenten, sondern die **Bestellmenge des Einzelhändlers** – und diese Bestellmenge ist selbst bereits das Ergebnis einer Bestandsentscheidung, die auf einer geschätzten, unsicheren Nachfrage beruht. Jede Stufe filtert, interpretiert und verstärkt damit die Information, die sie an die nächste Stufe weitergibt. Genau dieses Phänomen der stufenweisen Verstärkung von Nachfrageschwankungen entlang einer Lieferkette ist Gegenstand dieses Kapitels: der **Bullwhip-Effekt** (deutsch gelegentlich auch *Peitscheneffekt*).
Wir nähern uns dem Thema wie gewohnt über ein durchgehendes Fallbeispiel, leiten daraus eine formale Definition und ein Messkonzept ab, ordnen die Ursachen und Folgen des Effekts ein und lernen mit dem **Beergame** ein klassisches Lehrspiel kennen, das wir anschließend selbst in R nachbauen. Am Ende steht ein Überblick über Gegenmaßnahmen, die in der Praxis eingesetzt werden, um die Peitsche zu "entschärfen".
## Fallbeispiel: die SushiFresh-Supply-Chain
Wir greifen erneut die **SushiFresh GmbH** aus den vorigen Kapiteln auf: den regionalen Hersteller frischer Sushi-Boxen mit einer Zentralküche in **Raunheim** (vgl. die Standortanalyse in Kapitel [-@sec-standort-2] und die Pooling-Argumente in Kapitel [-@sec-unsicherheit-pooling]), der sechs Supermarkt-Filialen im Rhein-Main-Gebiet beliefert – darunter die bereits aus den Kapiteln [-@sec-unsicherheit-pooling] und [-@sec-newsvendor] bekannte, besonders nachfragestarke Filiale **Frankfurt** ($\mu=280$, $\sigma=55$ Sushi-Boxen pro Tag). Für die Produktion ist SushiFresh auf die tägliche Lieferung frischer Fischfilets angewiesen, die der Fischgroßhändler **Nord-Fisch KG** liefert. Nord-Fisch beschafft Rohfisch, produziert daraus Filets und lagert diese, um schnell liefern zu können. Die Kette ist also dreistufig; Bestellungen fließen stromaufwärts, Lieferungen stromabwärts:
$$
\text{Supermarkt-Filialen}
\;\longleftrightarrow\;
\text{SushiFresh GmbH}
\;\longleftrightarrow\;
\text{Nord-Fisch KG}
$$
Die **Filialen** beobachten die Endkundennachfrage (z. B. Frankfurt: $\mu=280$, $\sigma=55$) und bestellen täglich Sushi-Boxen bei SushiFresh. **SushiFresh** erhält diese Bestellungen als seine Nachfrage, bestellt Fisch bei Nord-Fisch und hält einen Vorrat an Fischfilets. **Nord-Fisch** wiederum sieht nur die Bestellungen von SushiFresh. SushiFresh und Nord-Fisch halten beide einen (Sicherheits-)Bestand an Fischfilets, um Fehlmengen zu vermeiden – die zentrale Frage lautet also: Wie hoch sollte dieser Bestand sein, und wie wirken die Bestellentscheidungen auf die vorgelagerte Stufe?
Jede Stufe beobachtet nur die Bestellungen der ihr unmittelbar nachgelagerten Stufe und muss daraus – ohne Einblick in die tatsächliche Endkundennachfrage – ihre eigene Bestellentscheidung ableiten. Damit wir diese Entscheidung formal fassen können, benötigen wir drei Bestandsgrößen, die in jeder Periode $t$ fortgeschrieben werden:
- der **physische Bestand** $i_t$: die tatsächlich im Lager verfügbare Menge, $i_t = \max(0,\, i_{t-1} + q_{t-l} - d_t)$
- der **Nettobestand** $n_t$: der physische Bestand abzüglich offener Fehlmengen (Backorders), $n_t = i_{t-1} + q_{t-l} - d_t$
- der **disponible Bestand** $p_t$: der Nettobestand zuzüglich aller bereits ausgelösten, aber noch nicht eingetroffenen Bestellungen (der sogenannten *Pipeline*), $p_t = n_t + \sum_{\tau=t-l+1}^{t-1} q_\tau$
Dabei bezeichnet $d_t$ den Bedarf in Periode $t$, $q_t$ die Bestellmenge und $l$ die **Wiederbeschaffungszeit** (WBZ) in Perioden. Legt eine Stufe einen Ziellagerbestand (**Order-up-to-Level**) $S$ fest, ergibt sich die Bestellmenge als Auffüllung des disponiblen Bestands auf $S$:
$$ q_t = \max\bigl(0,\; S - p_t\bigr) $$
Der Ziellagerbestand selbst setzt sich – wie im Kapitel zum Newsvendor-Modell hergeleitet – aus einem Grundbedarf über die **Schutzperiode** $l+1$ (die Zeit von einer Bestellentscheidung bis zur nächsten möglichen Reaktion auf eine neue Lieferung) und einem Sicherheitsbestand zusammen:
$$ S = \mu \cdot (l+1) + z_\alpha \cdot \sigma \cdot \sqrt{l+1} $$
Hierbei sind $\mu$ und $\sigma$ die erwartete Nachfrage pro Periode und ihre Standardabweichung, die in der Praxis aus vergangenen Bedarfen **geschätzt** werden müssen, und $z_\alpha$ das Quantil der Standardnormalverteilung zum gewünschten Servicegrad $\alpha$.
Genau an dieser Schätzung setzt der Bullwhip-Effekt an. Simulieren wir SushiFresh GmbH für zwölf Tage mit der moderat schwankenden Sushi-Boxen-Nachfrage der Filiale Frankfurt ($\mu=280$, $\sigma=55$), einer Wiederbeschaffungszeit von zwei Tagen (ein Tag Vorlauf für die Fischanlieferung durch Nord-Fisch KG, ein weiterer Tag für Produktion und Auslieferung an die Filiale) und einem – zunächst fest vorgegebenen – Ziellagerbestand von $S=990$, können wir die Funktion `simuliere_tS()` aus `R/scm_functions.R` nutzen, die diese Fortschreibung von physischem, Netto- und disponiblem Bestand automatisiert:
```{r ch8-sushi-sim}
# Beobachtete Sushi-Boxen-Nachfrage der Filiale Frankfurt (Stueck je Tag,
# mu = 280, sigma = 55 - vgl. Newsvendor- und Pooling-Kapitel)
nachfrage <- c(234, 256, 344, 410, 278, 322, 212, 256, 278, 234, 256, 278)

# Simulation einer (t,S)-Bestandspolitik bei SushiFresh GmbH: taegliche
# Bestellentscheidung (t=1), fester Ziellagerbestand S = 990,
# Anfangsbestand 990, Wiederbeschaffungszeit 2 Tage
sushi_sim <- simuliere_tS(
  bedarf         = nachfrage,
  t              = 1,
  S              = 990,
  anfangsbestand = 990,
  wbz            = 2
)

sushi_sim |>
  select(Periode, Bedarf, Nettobestand, Disponibler_Bestand_vor_Bestellung, Bestellmenge) |>
  kable(digits = 1, align = "r",
        caption = "Simulierte Bestands- und Bestellentwicklung von SushiFresh GmbH (Filiale Frankfurt)")
```
Obwohl der Ziellagerbestand $S=990$ über alle zwölf Tage konstant bleibt, folgt die Bestellmenge exakt dem Verlauf der Nachfrage, nur um die Wiederbeschaffungszeit versetzt: Weil zwischen Bestellung und Lieferung zwei Tage liegen, wirkt sich jede Bedarfsabweichung erst mit Verzögerung – dafür aber vollständig – auf den disponiblen Bestand und damit auf die nächste Bestellung aus. Diesen Zusammenhang können wir direkt an den Standardabweichungen ablesen:
```{r ch8-sushi-vergleich}
sd_nachfrage  <- sd(sushi_sim$Bedarf)
sd_bestellung <- sd(sushi_sim$Bestellmenge)

tibble(
  Größe             = c("Nachfrage d[t]", "Bestellmenge q[t]"),
  Standardabweichung = round(c(sd_nachfrage, sd_bestellung), 2)
) |>
  kable(align = "lr")
```
::: {.definition}
**Definition: Bullwhip-Effekt**
Der **Bullwhip-Effekt** (auch *Peitscheneffekt* oder *Forrester-Effekt*) liegt vor, wenn die Variabilität der Bestellungen einer Stufe einer Supply Chain größer ist als die Variabilität der Nachfrage, mit der diese Stufe konfrontiert ist – und diese Verstärkung sich mit jeder weiteren vorgelagerten Stufe fortsetzt bzw. verschärft [@cachon2024matching]. Formal gilt häufig
$$
\operatorname{Var}(d_t) \;<\; \operatorname{Var}\!\bigl(q_t^{\,i}\bigr) \;<\; \operatorname{Var}\!\bigl(q_t^{\,i+1}\bigr) \;<\; \operatorname{Var}\!\bigl(q_t^{\,i+2}\bigr) \;<\; \dots
$$
wobei $q_t^{\,i}$ die Bestellmenge der $i$-ten Stufe (von den Endkunden aus gezählt) in Periode $t$ bezeichnet.
:::
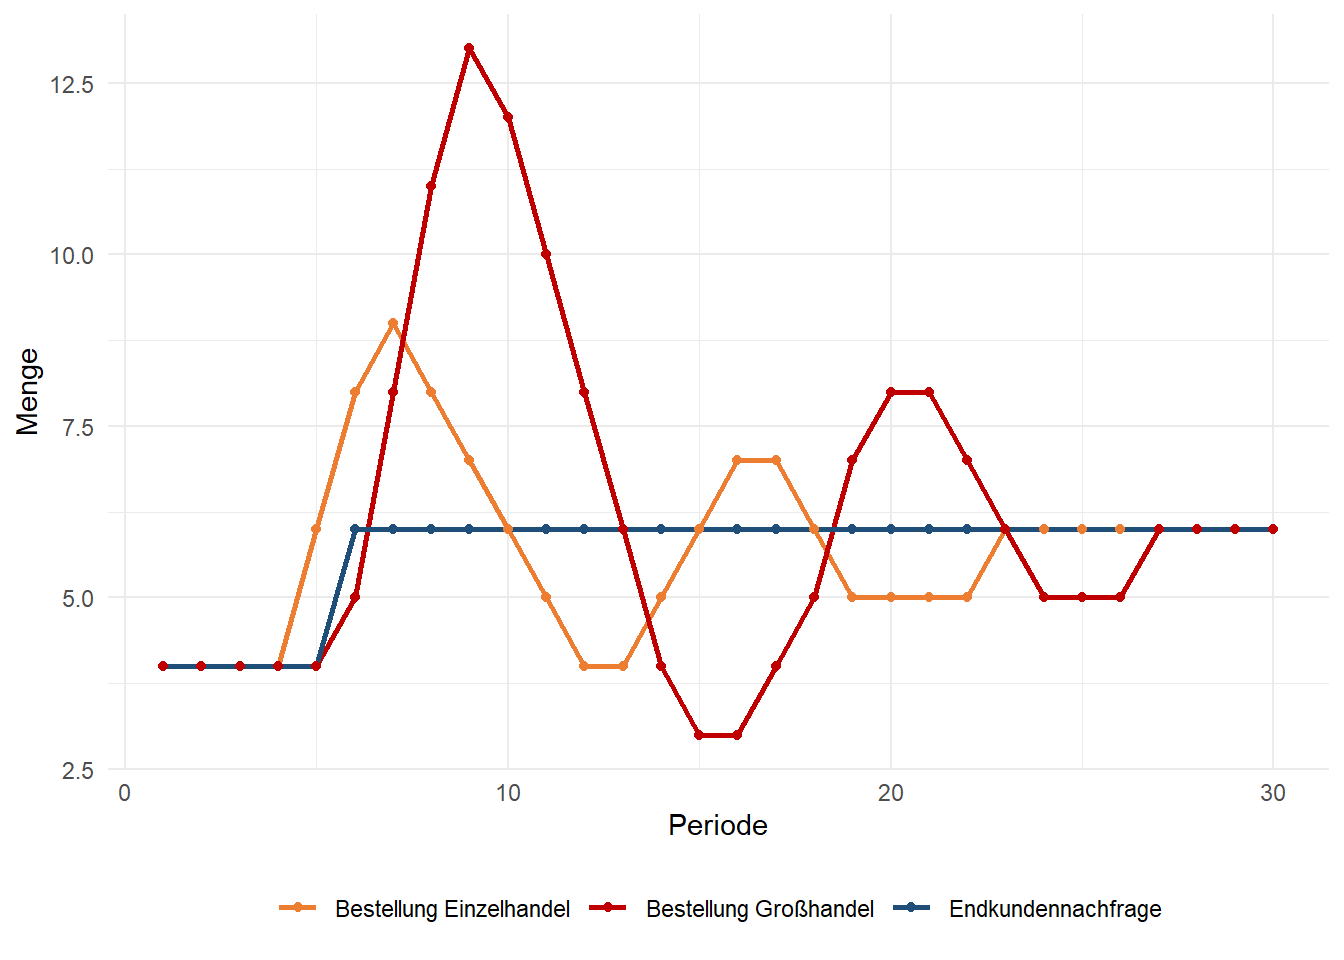
Die Vorlesung zitiert die Definition von @cachon2024matching im Original: "The bullwhip effect is present in a supply chain if the variability of demand at one level of the supply chain is greater than the variability of demand at the next downstream level in the supply chain, where variability is measured with the coefficient of variation." Wichtig ist der Zusatz zum **Variationskoeffizienten** $VK = \sigma/\mu$: Er macht Stufen vergleichbar, auf denen in unterschiedlichen Einheiten oder Größenordnungen gerechnet wird (z. B. Sushi-Boxen bei der Filiale, Kilogramm Fisch beim Großhändler). Die typischen Verläufe zeigt die folgende, schematische Abbildung: Die Endkundennachfrage steigt einmalig von 4 auf 6 Einheiten; die Bestellungen des Einzelhandels schwingen darauf über, die des Großhandels noch stärker und länger, bevor sich alle Stufen auf dem neuen Niveau einpendeln.
```{r ch8-typische-verlaeufe}
#| fig-cap: "Schematischer Verlauf: Aufschaukeln eines einmaligen Nachfragesprungs über zwei Stufen"
verlauf <- tibble(
  Periode = 1:30,
  Endkundennachfrage = c(rep(4, 5), rep(6, 25)),
  `Bestellung Einzelhandel` = c(rep(4, 4), 6, 8, 9, 8, 7, 6, 5, 4, 4, 5, 6, 7, 7, 6,
                                5, 5, 5, 5, 6, 6, 6, 6, 6, 6, 6, 6),
  `Bestellung Großhandel` = c(rep(4, 5), 5, 8, 11, 13, 12, 10, 8, 6, 4, 3, 3, 4, 5,
                              7, 8, 8, 7, 6, 5, 5, 5, 6, 6, 6, 6)
) |>
  pivot_longer(-Periode, names_to = "Reihe", values_to = "Menge")

ggplot(verlauf, aes(Periode, Menge, colour = Reihe)) +
  geom_line(linewidth = 1) + geom_point(size = 1.5) +
  scale_colour_manual(values = c("Endkundennachfrage" = "#1F4E79",
                                 "Bestellung Einzelhandel" = "#ED7D31",
                                 "Bestellung Großhandel" = "#C00000")) +
  labs(y = "Menge", colour = NULL) +
  theme_minimal() + theme(legend.position = "bottom")
```
Die Folgen stromaufwärts sind ein "Aufschaukeln" der Bestellmengen, eine steigende Volatilität der Bestände und häufigere Fehlmengen – obwohl sich die Endkundennachfrage nur ein einziges Mal und nur moderat verändert hat.
Der Grund für diese Verstärkung liegt bereits in der Struktur der Bestellregel: Die Bestellmenge $q_t = S - p_t$ setzt sich aus mehreren Bestandteilen zusammen, die sich **nicht** eins zu eins in der tatsächlichen Nachfrage widerspiegeln,
$$
q_t = \underbrace{\hat{\mu}\cdot(l+1)}_{\text{erwarteter Bedarf}} \;+\; \underbrace{(n_{t-1}^{\text{Soll}} - n_{t-1})}_{\text{Bestandskorrektur}} \;+\; \underbrace{z_\alpha\,\hat\sigma\sqrt{l+1}}_{\text{Sicherheitsbestandskorrektur}},
$$
und für eine vorgelagerte Stufe ist nicht erkennbar, ob eine höhere Bestellmenge eine dauerhafte Verschiebung der Endkundennachfrage anzeigt oder nur eine kurzfristige Bestandskorrektur ist. Diese Mehrdeutigkeit erschwert die eigene Prognose der vorgelagerten Stufe – ihr Prognosefehler $\hat\sigma$ steigt, und mit ihm (über den obigen Term) auch ihre eigene Bestellmengen-Varianz. Der Effekt pflanzt sich damit von Stufe zu Stufe fort und wird typischerweise **größer**, je weiter man sich von den Endkunden entfernt.
## R-Exkurs: Zeitreihen als Vektoren und die Funktion `diff()`
::: {.r-exkurs}
**R-Exkurs: Zeitreihen und `diff()`**
Eine **Zeitreihe** ist in R zunächst nichts Besonderes: ein einfacher numerischer Vektor, dessen Reihenfolge der zeitlichen Abfolge der Beobachtungen entspricht. Der Vektor `nachfrage` aus dem Sushi-Boxen-Beispiel enthält zwölf Werte für zwölf Tage – mehr braucht R zunächst nicht, um mit einer Zeitreihe zu arbeiten.
Eine sehr häufige Frage bei Zeitreihen lautet: *Wie stark verändert sich die Größe von einer Periode zur nächsten?* Dafür bietet R die Funktion `diff()`, die für einen Vektor `x` der Länge $n$ einen neuen Vektor der Länge $n-1$ zurückgibt, dessen $t$-tes Element $x_{t+1} - x_t$ ist:
```{r ch8-diff-demo}
# diff() berechnet die Veränderung von einer Periode zur naechsten:
# diff(x)[t] = x[t+1] - x[t]
veraenderung_nachfrage <- diff(nachfrage)
veraenderung_nachfrage
# ein Wert weniger als im Ausgangsvektor, da fuer Periode 1
# kein Vorperiodenwert existiert
length(nachfrage)
length(veraenderung_nachfrage)
# mittlere absolute Veraenderung als einfaches Volatilitaetsmass:
# vergleicht man dies fuer Nachfrage und Bestellmenge im ersten,
# einfachen Fallbeispiel mit konstantem S
mean(abs(diff(nachfrage)))
mean(abs(diff(sushi_sim$Bestellmenge)))
```
Die mittlere absolute Periodenveränderung von Bestellmenge und Nachfrage ist in diesem ersten, einfachen Fallbeispiel **identisch** – kein Zufall, sondern eine direkte Folge der Bestellregel: Bei täglicher Überprüfung ($t=1$) und **konstantem** Ziellagerbestand $S$ gilt exakt $q_t = d_t$ (nur um die Wiederbeschaffungszeit zeitversetzt geliefert), denn jede Bestellung füllt die Bestandsposition wieder genau auf das in der Vorperiode verbrauchte Niveau auf. Eine Verstärkung entsteht erst, sobald der Ziellagerbestand selbst – wie in der Praxis üblich – aus rollierend geschätzten Nachfrageparametern neu berechnet wird; genau das bilden wir weiter unten in der mehrstufigen Simulation nach. `diff()` lässt sich zudem mit dem Argument `lag` auf größere Zeitabstände (`diff(x, lag = 2)`) oder mit `differences` auf mehrfache Differenzenbildung erweitern – darauf gehen wir hier aber nicht weiter ein.
:::
## Messung des Bullwhip-Effekts: das Varianzverhältnis
Um den Bullwhip-Effekt nicht nur qualitativ zu beschreiben, sondern zu quantifizieren, wird in der Literatur meist das **Varianzverhältnis** (*bullwhip ratio*) verwendet:
$$
B \;=\; \frac{\operatorname{Var}(q_t)}{\operatorname{Var}(d_t)}
\qquad \text{bzw. stufenweise} \qquad
B^{\,i} \;=\; \frac{\operatorname{Var}\!\bigl(q_t^{\,i}\bigr)}{\operatorname{Var}\!\bigl(q_t^{\,i-1}\bigr)}.
$$
Gilt $B>1$, verstärkt eine Stufe die Varianz der an sie herangetragenen Nachfrage; $B=1$ bedeutet, dass die Bestellvarianz genau der Nachfragevarianz entspricht (kein Bullwhip-Effekt); $B<1$ würde sogar eine Glättung anzeigen. In der ursprünglichen Definition wird statt der reinen Varianz oft der **Variationskoeffizient** ($\text{VK}=\sigma/\mu$) verwendet, um Größenordnungseffekte zwischen den Stufen auszugleichen; für die praktische Anwendung – insbesondere wenn $\mu$ zwischen den Stufen ähnlich bleibt – ist das einfache Varianzverhältnis jedoch die gebräuchlichere und leichter zu berechnende Kennzahl.
Für unser Sushi-Boxen-Beispiel lässt sich $B$ mit einer Zeile R-Code berechnen:
```{r ch8-sushi-bullwhip-mass}
bullwhip_mass_sushi <- var(sushi_sim$Bestellmenge) / var(sushi_sim$Bedarf)
round(bullwhip_mass_sushi, 2)
```
In diesem ersten, bewusst einfach gehaltenen Fallbeispiel ergibt sich $B=1{,}00$ – SushiFresh GmbH verstärkt die Nachfrageschwankung der Filiale Frankfurt hier noch **nicht**. Das ist kein Fehler, sondern folgt zwingend aus der Bestellregel: Solange der Ziellagerbestand $S$ **konstant** bleibt und täglich überprüft wird, entspricht die Bestellmenge exakt der (zeitversetzten) Nachfrage – die Order-up-to-Regel reicht die Nachfrage lediglich unverändert weiter. Der Bullwhip-Effekt entsteht erst, wenn $S$ selbst über rollierend **geschätzte** Nachfrageparameter $\hat\mu$ und $\hat\sigma$ periodisch neu berechnet wird, wie es in der Praxis – und im nachfolgenden Abschnitt zur mehrstufigen Simulation – der Fall ist: Dort wird die Bestellmenge einer Stufe zur (verzerrten) "Nachfrage" der nächsten Stufe, und mit jeder erneuten Schätzung von $\hat\mu$ und $\hat\sigma$ wächst die Bestellvarianz weiter an, **obwohl** jede Stufe sich strikt an dieselbe einfache, rationale Order-up-to-Regel hält. Der Bullwhip-Effekt ist damit kein Zeichen für irrationales Verhalten Einzelner, sondern eine strukturelle Eigenschaft der Interaktion von rollierender Prognose, Bestandspolitik und Wiederbeschaffungszeit.
## Rollierende Parameterschätzung: wie der Bullwhip-Effekt entsteht
In der Praxis kennt SushiFresh die Parameter $\mu$ und $\sigma$ nicht, sondern **schätzt** sie laufend aus den zuletzt beobachteten Bedarfen – etwa mit einem gleitenden Mittelwert und der empirischen Standardabweichung über die letzten $T$ Tage:
$$
\hat{\mu}_t = \frac{1}{T} \sum_{\tau=t-T}^{t-1} d_\tau,
\qquad
\hat{\sigma}_t = \sqrt{\frac{1}{T-1} \sum_{\tau=t-T}^{t-1} \big(d_\tau - \hat{\mu}_t\big)^2 } .
$$
$\hat\sigma_t$ misst dabei die Streuung der Nachfrage um die Prognose und damit den **Prognosefehler**. Mit diesen Schätzwerten wird der Ziellagerbestand jeden Tag neu berechnet: $S_t = (l+1)\,\hat\mu_t + z_\alpha\,\hat\sigma_t\sqrt{l+1}$. Die Vorlesung rechnet dieses Vorgehen für dieselben zwölf Tage durch, mit einem Schätzfenster von $T = 3$ Tagen, $l = 2$ und $\alpha = 95\,\%$:
```{r ch8-dynamisch}
fenster     <- 3
wbz_s       <- 2
z_95        <- qnorm(0.95)
n_t         <- length(nachfrage)

mu_hat <- sigma_hat <- S_t <- numeric(n_t)
bestellung_dyn <- lieferung_dyn <- netto_dyn <- dispo_dyn <- numeric(n_t)
netto_vor <- 990                               # Anfangsbestand

for (t in seq_len(n_t)) {
  # 1. Parameterschaetzung aus den (hoechstens) 'fenster' Vortagen;
  #    am ersten Tag: Planwerte der Filiale Frankfurt (280 / 55)
  hist <- if (t == 1) numeric(0) else nachfrage[max(1, t - fenster):(t - 1)]
  mu_hat[t]    <- if (length(hist) == 0) 280 else mean(hist)
  sigma_hat[t] <- if (length(hist) < 2) 55 else sd(hist)
  S_t[t]       <- (wbz_s + 1) * mu_hat[t] + z_95 * sigma_hat[t] * sqrt(wbz_s + 1)

  # 2. Lieferung der Bestellung von vor wbz Tagen trifft ein, Bedarf faellt an
  lieferung_dyn[t] <- if (t > wbz_s) bestellung_dyn[t - wbz_s] else 0
  netto_dyn[t]     <- netto_vor + lieferung_dyn[t] - nachfrage[t]

  # 3. disponibler Bestand = Nettobestand + noch offene Bestellungen
  offen <- if (t == 1) 0 else sum(bestellung_dyn[max(1, t - wbz_s + 1):(t - 1)])
  dispo_dyn[t] <- netto_dyn[t] + offen

  # 4. Auffuellen auf den (neu geschaetzten) Ziellagerbestand
  bestellung_dyn[t] <- max(0, S_t[t] - dispo_dyn[t])
  netto_vor <- netto_dyn[t]
}

tibble(Tag = 1:n_t, Bedarf = nachfrage, mu_hat = mu_hat, sigma_hat = sigma_hat,
       S_t = S_t, Bestellung = bestellung_dyn) |>
  kable(digits = 1, caption = "Bestellentscheidungen bei rollierender Parameterschätzung")
c(sd_Nachfrage  = sd(nachfrage),
  sd_Bestellung = sd(bestellung_dyn),
  B             = var(bestellung_dyn) / var(nachfrage))
```
Die Standardabweichung der Bestellmengen ist nun mit rund `r round(sd(bestellung_dyn))` Boxen deutlich größer als die der Nachfrage (`r round(sd(nachfrage))` Boxen); das Varianzverhältnis beträgt $B \approx `r round(var(bestellung_dyn) / var(nachfrage), 1)`$. **SushiFresh erzeugt damit zusätzliche Unsicherheit für Nord-Fisch**, obwohl sich an der Endkundennachfrage nichts geändert hat. Die Ursache ist gut an den Tagen 4 und 5 zu erkennen: Die hohen Bedarfe der Tage 3 und 4 (344 und 410 Boxen) gehen in das Schätzfenster ein und erhöhen $\hat\mu_t$ – und jede Erhöhung von $\hat\mu_t$ wirkt mit dem Multiplikator $(l+1) = 3$ auf den Ziellagerbestand, der innerhalb von zwei Tagen um mehr als 400 Boxen steigt. Gleichzeitig steigt $\hat\sigma_t$, weil der Prognosefehler wächst. SushiFresh bestellt deshalb nicht nur den Mehrverbrauch nach, sondern baut zusätzlich Bestand auf – und reduziert die Bestellungen umso stärker, sobald die hohen Werte das Schätzfenster wieder verlassen haben.
::: {.vertiefung}
**Theorie-Vertiefung: Eine untere Schranke für den Bullwhip-Effekt**
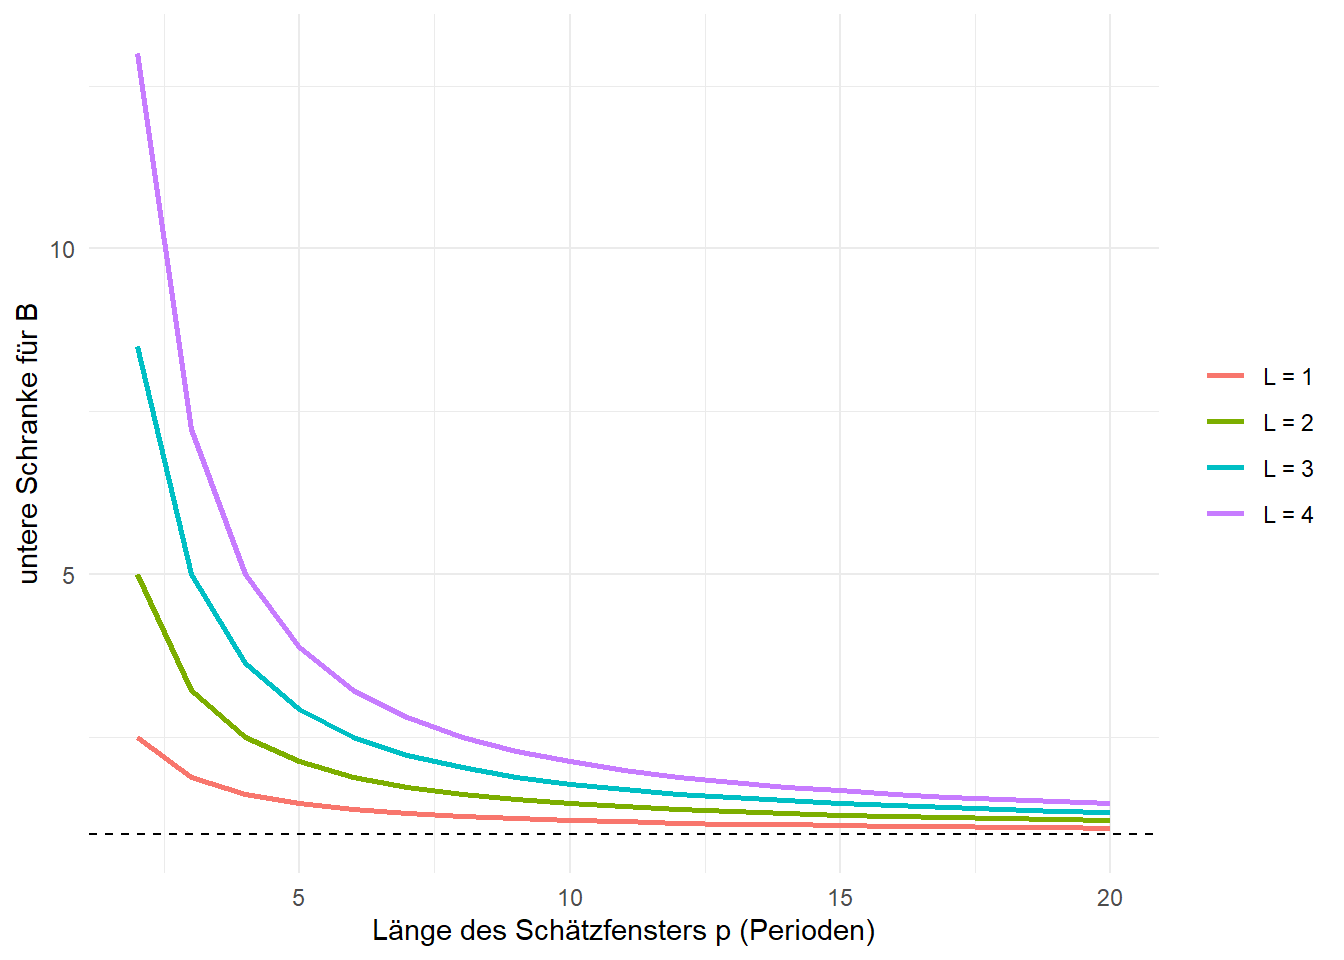
@chen2000quantifying haben den in der Tabelle sichtbaren Mechanismus analytisch untersucht. Betrachtet wird eine Stufe, die nach einer Order-up-to-Politik bestellt, die Wiederbeschaffungszeit $L$ hat und die mittlere Nachfrage mit einem gleitenden Durchschnitt über die letzten $p$ Perioden schätzt. Für unabhängige, identisch verteilte Nachfrage zeigen sie, dass das Varianzverhältnis mindestens
$$
B = \frac{\operatorname{Var}(q)}{\operatorname{Var}(d)} \;\geq\; 1 + \frac{2L}{p} + \frac{2L^2}{p^2}
$$
beträgt. (Die Schranke gilt, wenn auch die Standardabweichung geschätzt wird; wird nur der Mittelwert geschätzt, gilt sie mit Gleichheit.) Aus der Formel lassen sich drei Einsichten ablesen:
1. **Der Bullwhip-Effekt ist unvermeidlich**, sobald Parameter geschätzt werden: Für jede positive Wiederbeschaffungszeit ist $B > 1$ – auch bei völlig rationalen Entscheidern.
2. **Längere Wiederbeschaffungszeiten verstärken ihn quadratisch.** Eine Verkürzung von $L$ ist deshalb einer der wirksamsten Hebel.
3. **Längere Schätzfenster dämpfen ihn.** Mit wachsendem $p$ reagiert die Prognose träger auf einzelne Ausreißer, und $B$ sinkt gegen 1 – allerdings um den Preis, dass echte Nachfrageverschiebungen später erkannt werden.
Für das Beispiel der Vorlesung ($L = 2$, $p = 3$) ergibt sich eine Schranke von $1 + 4/3 + 8/9 \approx 3{,}2$. Für mehrstufige Ketten, in denen jede Stufe unabhängig prognostiziert, multiplizieren sich die Verstärkungen der einzelnen Stufen; teilen alle Stufen dagegen die Endkundennachfrage (zentralisierte Information), addieren sich die Wiederbeschaffungszeiten nur noch in der Formel, und der Effekt fällt deutlich kleiner aus.
:::
```{r ch8-chen-schranke}
#| fig-cap: "Untere Schranke des Varianzverhältnisses nach Chen et al. (2000) in Abhängigkeit vom Schätzfenster p"
expand_grid(L = 1:4, p = 2:20) |>
  mutate(B_min = 1 + 2 * L / p + 2 * L^2 / p^2,
         L = factor(paste("L =", L))) |>
  ggplot(aes(p, B_min, colour = L)) +
  geom_line(linewidth = 1) +
  geom_hline(yintercept = 1, linetype = "dashed") +
  labs(x = "Länge des Schätzfensters p (Perioden)", y = "untere Schranke für B", colour = NULL) +
  theme_minimal()
```
## R-Exkurs: Zeitversatz mit `dplyr::lag()`
::: {.r-exkurs}
**R-Exkurs: `dplyr::lag()`**
Weil zwischen Bestellung und Lieferung eine Wiederbeschaffungszeit liegt, möchte man Zeitreihen häufig **um eine oder mehrere Perioden verschoben** miteinander vergleichen – zum Beispiel die heutige Bestellmenge mit der Nachfrage der Vorperiode. Dafür stellt das `tidyverse`-Paket `dplyr` die Funktion `lag()` bereit: `dplyr::lag(x, n = 1)` gibt einen Vektor derselben Länge wie `x` zurück, dessen Werte um `n` Positionen "nach hinten" verschoben sind; die ersten `n` Werte werden dabei mit `NA` aufgefüllt.
```{r ch8-lag-demo}
sushi_sim_lag <- sushi_sim |>
  mutate(
    # Nachfrage der Vorperiode neben die heutige Bestellmenge stellen
    Bedarf_Vorperiode = dplyr::lag(Bedarf, n = 1)
  )

sushi_sim_lag |>
  select(Periode, Bedarf, Bedarf_Vorperiode, Bestellmenge) |>
  head(6) |>
  kable(align = "r")
```
Anders als `diff()`, das eine Differenz *berechnet* und dabei die Vektorlänge verkürzt, *verschiebt* `lag()` lediglich die Werte und erhält die ursprüngliche Länge – die Funktion eignet sich deshalb besonders gut, um verschobene Spalten direkt in ein bestehendes `tibble` einzufügen und dort mit anderen Spalten der gleichen Periode zu kombinieren (z. B. für eine anschließende `mutate()`-Berechnung einer Differenz `Bestellmenge - Bedarf_Vorperiode` oder eine Korrelation `cor(..., use = "complete.obs")`). Das Gegenstück `dplyr::lead()` verschiebt entsprechend "nach vorne" und ist z. B. hilfreich, wenn man eine Bestellung mit der Lieferung vergleichen möchte, die erst *danach* eintrifft.
:::
## Das Beergame
Die bisherigen Überlegungen zeigen den Bullwhip-Effekt als Konsequenz einer *rationalen* Bestandsregel unter Wiederbeschaffungszeiten. In der Praxis kommen weitere, meist verhaltensbedingte Verstärkungseffekte hinzu – diese werden besonders eindrücklich durch das **Beergame** demonstriert, ein am MIT entwickeltes Planspiel, das seit Jahrzehnten fester Bestandteil der Ausbildung im Supply Chain Management ist.
::: {.callout-note}
## Spielprinzip
Im Beergame bilden vier Spielergruppen die vierstufige Lieferkette eines fiktiven Biers ab: **Einzelhandel – Großhandel – Distributor – Brauerei**. Jede Stufe kennt nur die Bestellungen ihrer unmittelbar nachgelagerten Stufe, nicht aber die tatsächliche Endkundennachfrage und nicht die Entscheidungen der anderen Stufen. Kommunikation zwischen den Stufen ist untersagt. In jeder Spielrunde (Periode) muss jede Gruppe – ohne Rücksprache – eine Bestellmenge bei der eigenen vorgelagerten Stufe festlegen; Lieferungen treffen erst nach einer festen Verzögerung ein. Die Endkundennachfrage selbst ist im klassischen Spielaufbau denkbar einfach: über weite Strecken konstant, mit einem einmaligen, moderaten Sprung.
:::
Trotz dieser simplen, fast schon "langweiligen" Nachfrage zeigt sich im Beergame regelmäßig ein ausgeprägtes Aufschaukeln der Bestellmengen entlang der Kette: Bestände laufen zunächst leer, es kommt zu Fehlmengen, Spieler reagieren mit überproportionalen Nachbestellungen, und sobald die Lieferungen eintreffen, sitzen alle Stufen auf deutlich zu hohen Beständen. Das Spiel macht damit unmittelbar erfahrbar, was wir oben bereits formal hergeleitet haben: **Lokale, rationale Entscheidungen auf jeder Stufe führen – ohne bösen Willen und ohne fehlerhafte Information – in Summe zu einem für die gesamte Kette suboptimalen Ergebnis.** Genau diese Eigenschaft, dass individuelle Optimierung nicht automatisch zu einem globalen Optimum führt, ist eine der zentralen Lehren des Supply Chain Managements insgesamt.
::: {.vertiefung}
**Theorie-Vertiefung: Verhaltensursachen – was das Beergame über Entscheider zeigt**
Das Beergame geht auf die Arbeiten von Jay Forrester zur *Industrial Dynamics* zurück, der bereits 1961 zeigte, dass Verzögerungen und Rückkopplungen in Produktions- und Distributionssystemen zu Schwingungen führen [@forrester1961industrial]. @sterman1989modeling hat das Spielverhalten systematisch ausgewertet und festgestellt, dass die Bestellungen der Teilnehmer gut durch eine einfache **Ankerungs- und Anpassungsheuristik** beschrieben werden: Man bestellt die erwartete Nachfrage plus einen Bruchteil der Lücke zwischen Soll- und Istbestand – und plus einen *noch kleineren* Bruchteil der Lücke in der Pipeline. Genau darin liegt der Fehler: Die Spieler **vernachlässigen die bereits bestellten, aber noch nicht gelieferten Mengen** (*supply line underweighting*). Sie bestellen deshalb immer wieder nach, obwohl die Ware bereits unterwegs ist, und stehen einige Perioden später vor überfüllten Lagern. Sterman spricht von einer *Fehlwahrnehmung von Rückkopplung*: Menschen unterschätzen systematisch, wie stark Verzögerungen die Wirkung ihrer eigenen Entscheidungen verschieben.
Für die Formeln dieses Kapitels bedeutet das: Die Order-up-to-Regel $q_t = S - p_t$ berücksichtigt die Pipeline über den *disponiblen* Bestand $p_t$ korrekt. Menschen, die stattdessen nur auf den physischen Bestand schauen, erzeugen einen noch stärkeren Bullwhip-Effekt als die rationale Regel. Die rationalen Ursachen (Prognoseaktualisierung, Lieferzeiten) und die verhaltensbedingten Ursachen verstärken sich in der Praxis also gegenseitig.
:::
Wir können den Kern des Beergames – eine mehrstufige Kette, in der jede Stufe nur die Bestellungen ihrer Nachbarstufe beobachtet und daraus eine eigene Bestellentscheidung ableitet – mit den Werkzeugen dieses Buches direkt in R nachbilden.
## R-Exkurs: eine mehrstufige Simulationsschleife
::: {.r-exkurs}
**R-Exkurs: Simulation einer mehrstufigen Lieferkette**
Bislang haben wir mit `simuliere_tS()` immer nur *eine* Stufe simuliert. Das Prinzip des Beergames – mehrere Stufen, von denen jede die Bestellungen der nachgelagerten Stufe als "ihre" Nachfrage interpretiert – lässt sich aber ohne großen Mehraufwand als **verschachtelte Schleife** programmieren: eine äußere Schleife über die Stufen, eine innere Schleife über die Perioden. Jede Stufe verwendet dieselbe einfache Order-up-to-Regel wie SushiFresh GmbH oben, schätzt ihren Erwartungswert und ihre Standardabweichung aber **rollierend** aus den zuletzt beobachteten Bestellungen der nachgelagerten Stufe – sie kennt ja nur diese, nicht die tatsächliche Endkundennachfrage.
```{r ch8-mehrstufig-sim}
# Anzahl Perioden und Stufen der Modellkette (wie im Beergame):
# Filiale Frankfurt bestellt bei SushiFresh GmbH, SushiFresh GmbH
# bestellt bei Nord-Fisch KG
n_perioden <- 30
stufen     <- c("Filiale Frankfurt", "SushiFresh GmbH", "Nord-Fisch KG")
n_stufen   <- length(stufen)

# Steuerungsparameter (hier fuer alle Stufen identisch angenommen)
wbz         <- 2            # Wiederbeschaffungszeit in Perioden
fenster     <- 4            # Fenster der rollierenden Nachfrageschaetzung
servicegrad <- 0.95
z_alpha     <- qnorm(servicegrad)
anfangsbestand <- 660

# Endkundennachfrage der Filiale Frankfurt: zunaechst konstant,
# danach ein moderater Sprung (z.B. eine Werbeaktion)
kundennachfrage <- c(rep(220, 6), rep(280, n_perioden - 6))

# Matrizen zur Speicherung je Periode (Zeile) und Stufe (Spalte)
beobachtete_nachfrage <- matrix(0, n_perioden, n_stufen, dimnames = list(NULL, stufen))
bestellung            <- matrix(0, n_perioden, n_stufen, dimnames = list(NULL, stufen))
lieferung             <- matrix(0, n_perioden, n_stufen, dimnames = list(NULL, stufen))
nettobestand          <- matrix(0, n_perioden, n_stufen, dimnames = list(NULL, stufen))
disponibler_bestand   <- matrix(0, n_perioden, n_stufen, dimnames = list(NULL, stufen))

# aeussere Schleife: jede Stufe wird vollstaendig ueber alle Perioden simuliert,
# bevor die naechste (vorgelagerte) Stufe an der Reihe ist
for (s in seq_len(n_stufen)) {

  netto_vorperiode <- anfangsbestand

  # innere Schleife: Fortschreibung Periode fuer Periode
  for (t in seq_len(n_perioden)) {

    # die von Stufe s "gesehene" Nachfrage: bei der ersten Stufe die
    # tatsaechliche Endkundennachfrage, sonst die Bestellung der
    # nachgelagerten (downstream) Stufe
    beobachtete_nachfrage[t, s] <- if (s == 1) {
      kundennachfrage[t]
    } else {
      bestellung[t, s - 1]
    }

    # Lieferungen treffen wbz Perioden nach der Bestellung ein
    lieferung[t, s] <- if (t > wbz) bestellung[t - wbz, s] else 0

    # Fortschreibung des Nettobestands dieser Stufe
    nettobestand[t, s] <- netto_vorperiode + lieferung[t, s] - beobachtete_nachfrage[t, s]

    # rollierende Schaetzung von mu und sigma aus den zuletzt
    # beobachteten Bestellungen/Nachfragen dieser Stufe
    hist_index <- seq_len(t - 1L)
    hist_index <- tail(hist_index, min(fenster, length(hist_index)))

    if (length(hist_index) == 0L) {
      mu_hat    <- beobachtete_nachfrage[t, s]
      sigma_hat <- 0
    } else {
      beobachtungen <- beobachtete_nachfrage[hist_index, s]
      mu_hat        <- mean(beobachtungen)
      sigma_hat     <- if (length(beobachtungen) > 1L) sd(beobachtungen) else 0
    }

    # dynamischer Ziellagerbestand dieser Periode (vgl. Formel oben)
    S_t <- (wbz + 1) * mu_hat + z_alpha * sigma_hat * sqrt(wbz + 1)

    # offene Bestellungen: die noch nicht gelieferten Bestellungen
    # der letzten (wbz - 1) Perioden
    off_index <- seq.int(max(1L, t - wbz + 1L), t - 1L)
    offene <- if (t == 1L || length(off_index) == 0L) {
      0
    } else {
      sum(bestellung[off_index, s])
    }

    disponibler_bestand[t, s] <- nettobestand[t, s] + offene
    bestellung[t, s]          <- max(0, S_t - disponibler_bestand[t, s])

    netto_vorperiode <- nettobestand[t, s]
  }
}
```
Der Code unterscheidet sich von der Ein-Stufen-Simulation nur durch die zusätzliche äußere Schleife über `s` und dadurch, dass die "Nachfrage" jeder Stufe nicht extern vorgegeben, sondern aus der Bestellspalte der jeweils vorherigen Stufe entnommen wird (`bestellung[t, s - 1]`). Genau dieser Mechanismus – jede Stufe reicht ihre eigene, bereits verzerrte Bestellmenge als "Nachfrage" an die nächste Stufe weiter – ist der algorithmische Kern des Bullwhip-Effekts.
:::
## R-Exkurs: Varianzverhältnis und gefacettete Visualisierung
::: {.r-exkurs}
**R-Exkurs: Bullwhip-Maß und `facet_wrap()`**
Mit den Ergebnismatrizen aus dem vorigen Exkurs lässt sich das Varianzverhältnis nun für jede Stufe berechnen – sowohl gegenüber der tatsächlichen Endkundennachfrage als auch gegenüber der jeweils direkt vorgelagerten Stufe:
```{r ch8-bullwhip-mass}
# Varianzverhaeltnis jeder Stufe gegenueber der Endkundennachfrage
bullwhip_kunde <- apply(bestellung, 2, function(x) var(x) / var(kundennachfrage))

# Varianzverhaeltnis jeder Stufe gegenueber der unmittelbar vorgelagerten Stufe
bullwhip_vorstufe <- c(
  bullwhip_kunde[1],
  var(bestellung[, 2]) / var(bestellung[, 1]),
  var(bestellung[, 3]) / var(bestellung[, 2])
)

tibble(
  Stufe                          = stufen,
  `B ggü. Endkundennachfrage`    = round(bullwhip_kunde, 2),
  `B ggü. vorgelagerter Stufe`   = round(bullwhip_vorstufe, 2)
) |>
  kable(align = "lrr",
        caption = "Varianzverhältnis je Stufe der simulierten Beergame-Kette")
```
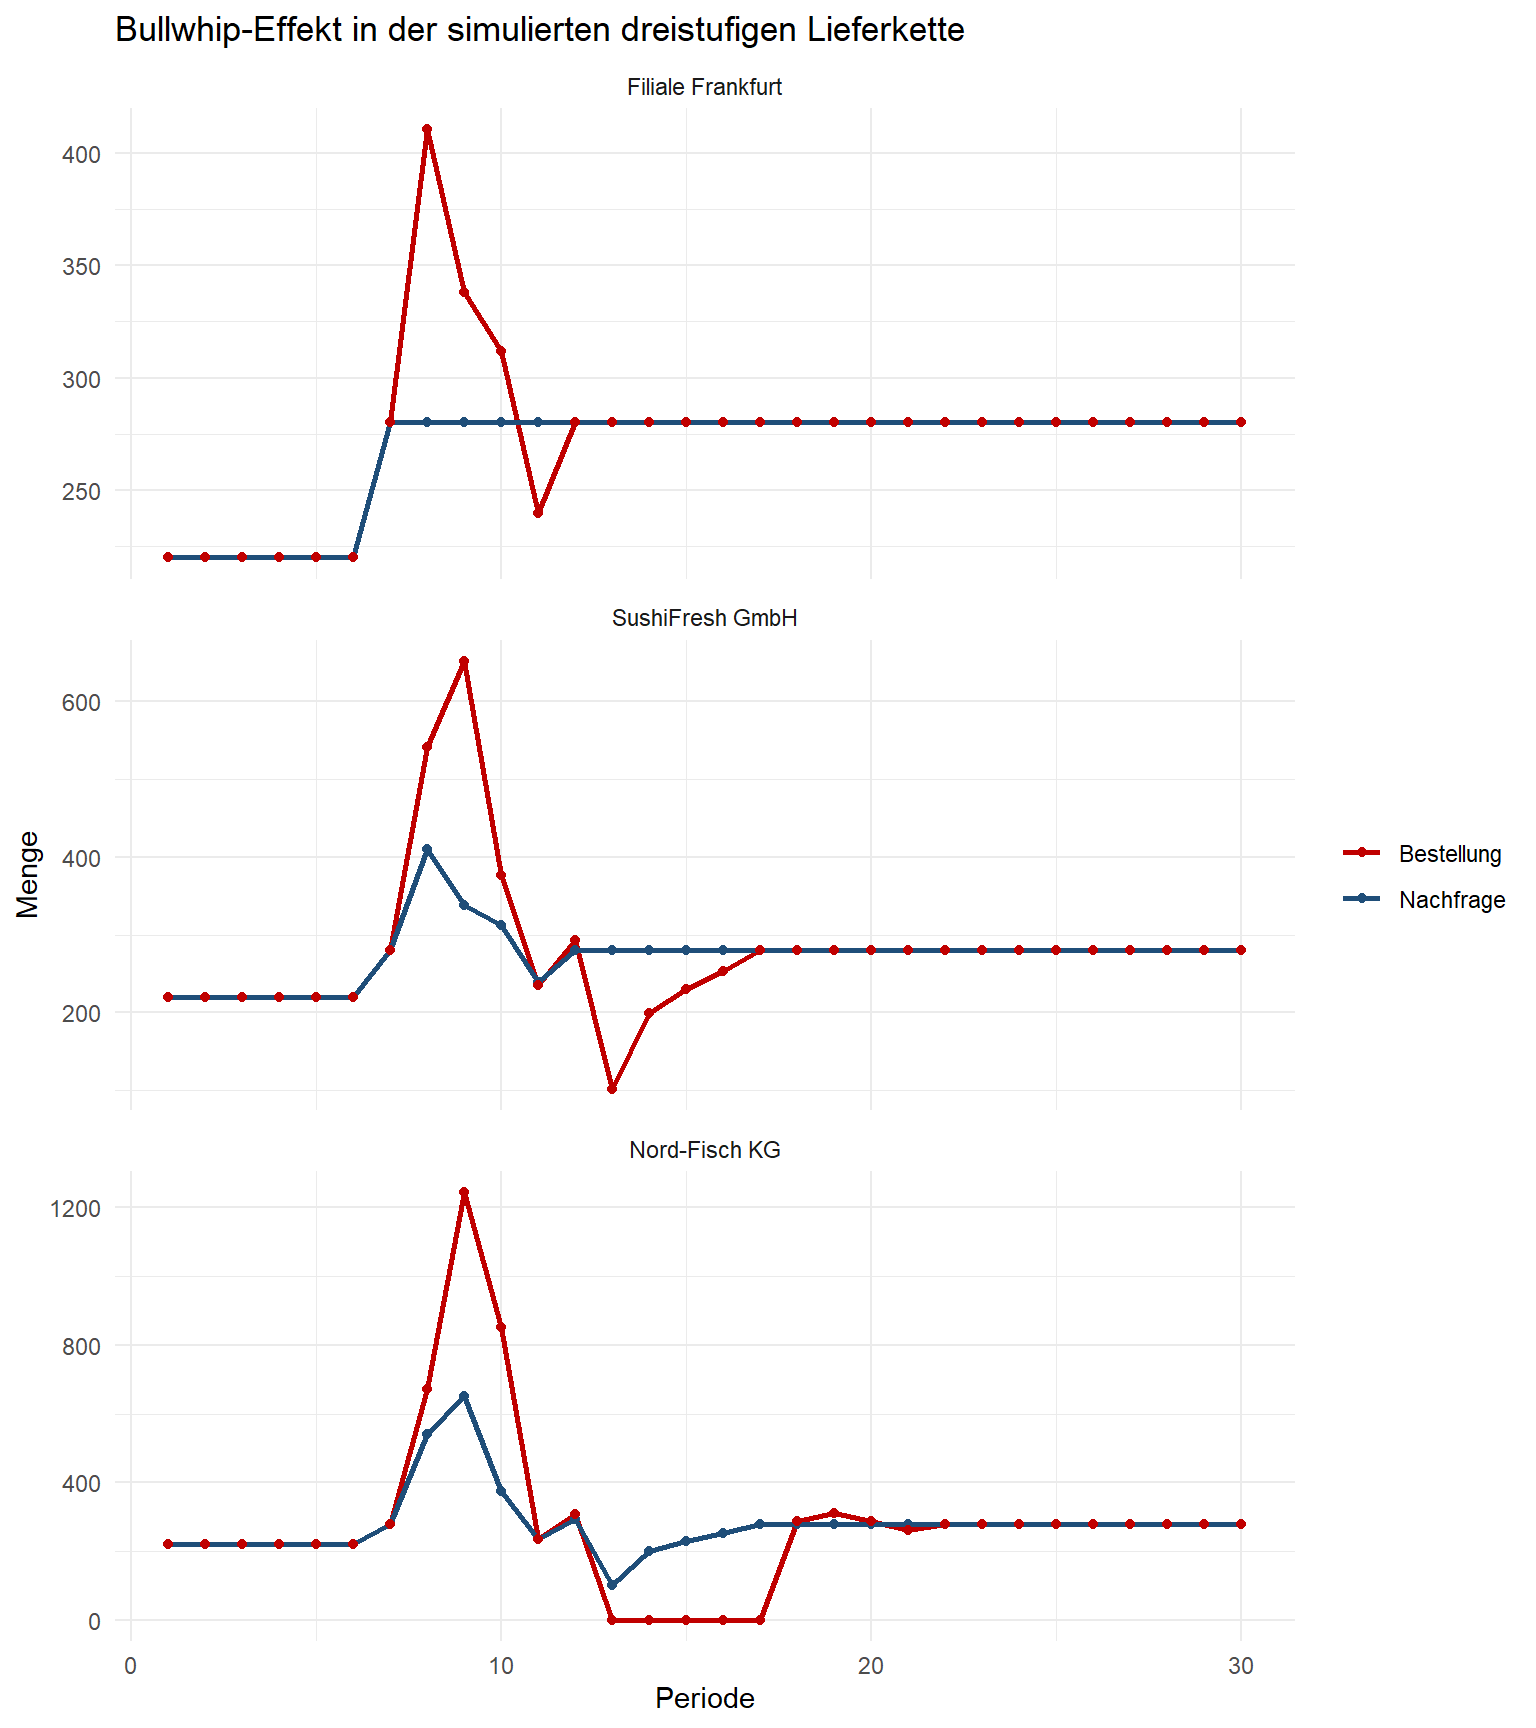
Um den Effekt auch grafisch sichtbar zu machen, bringen wir die Matrizen zunächst mit `pivot_longer()` in ein *long format* und stellen dann für jede Stufe einen eigenen Teilplot dar. Genau dafür ist `facet_wrap()` aus `ggplot2` gemacht: Es erzeugt automatisch ein Panel pro Ausprägung einer Gruppierungsvariable – hier je eine Teilgrafik pro Stufe der Kette:
```{r ch8-bullwhip-plot}
#| fig-width: 8
#| fig-height: 9
sim_daten <- tibble(
  Periode    = rep(seq_len(n_perioden), times = n_stufen),
  Stufe      = factor(rep(stufen, each = n_perioden), levels = stufen),
  Nachfrage  = as.vector(beobachtete_nachfrage),
  Bestellung = as.vector(bestellung)
) |>
  pivot_longer(
    cols      = c(Nachfrage, Bestellung),
    names_to  = "Größe",
    values_to = "Menge"
  )

ggplot(sim_daten, aes(x = Periode, y = Menge, color = `Größe`)) +
  geom_line(linewidth = 1) +
  geom_point(size = 1.5) +
  facet_wrap(~ Stufe, ncol = 1, scales = "free_y") +
  scale_color_manual(values = c(Nachfrage = farbe_nachfrage, Bestellung = farbe_bestellung)) +
  labs(
    title = "Bullwhip-Effekt in der simulierten dreistufigen Lieferkette",
    x = "Periode", y = "Menge", color = NULL
  ) +
  theme_minimal()
```
In der Grafik ist gut zu erkennen, wie der anfängliche Nachfragesprung bei der Filiale Frankfurt noch moderat, bei Nord-Fisch KG dagegen bereits stark überzeichnet ankommt – die Bestellmenge "überschwingt" mit jeder Stufe stärker, bevor sie sich wieder auf ein neues Niveau einpendelt. Genau dieses Muster – nicht die absolute Höhe der Bestellungen – ist die charakteristische "Peitschenform", die dem Bullwhip-Effekt seinen Namen gibt.
:::
## Wiederbeschaffungszeit-Effekte
Die Simulation legt bereits nahe, dass die Wiederbeschaffungszeit $l$ eine zentrale Stellschraube des Bullwhip-Effekts ist. Das lässt sich auch analytisch begründen: Ändert sich die geschätzte Nachfragerate $\hat\mu$ um $\Delta\hat\mu$ – etwa weil ein einzelner hoher Bedarfswert in das rollierende Schätzfenster rutscht –, verändert sich der Ziellagerbestand gemäß der Formel $S=\hat\mu\cdot(l+1)+z_\alpha\hat\sigma\sqrt{l+1}$ um
$$
\Delta S = \Delta \hat\mu \cdot (l+1),
$$
und diese Änderung wird über die Bestellregel $q_t = S - p_t$ **unmittelbar und vollständig** in eine veränderte Bestellmenge übersetzt. Je länger die Wiederbeschaffungszeit, desto größer der Multiplikator $(l+1)$ – und desto stärker reagiert die Bestellmenge auf jede noch so kleine Prognoseänderung. Auch der Sicherheitsbestandsterm wächst mit $\sqrt{l+1}$, wenngleich unterproportional zum Grundbedarfsterm. Wir können diesen Zusammenhang direkt mit `diff()` aus dem ersten R-Exkurs sichtbar machen, indem wir den Ziellagerbestand für steigende Wiederbeschaffungszeiten berechnen und die Grenzzunahme je zusätzlichem WBZ-Tag bestimmen:
```{r ch8-wbz-sensitivitaet}
# Nachfrageparameter der Filiale Frankfurt (mu = 280, sigma = 55)
mu_beispiel    <- 280
sigma_beispiel <- 55

tibble(
  WBZ = 0:4,
  Zielbestand_S = mu_beispiel * (0:4 + 1) +
    z_alpha * sigma_beispiel * sqrt(0:4 + 1)
) |>
  mutate(
    # Grenzzunahme des Zielbestands je zusaetzlichem WBZ-Tag
    Grenzzunahme = c(NA, diff(Zielbestand_S))
  ) |>
  kable(digits = 1, align = "r")
```
Die Tabelle zeigt: Mit jedem zusätzlichen Tag Wiederbeschaffungszeit steigt der erforderliche Ziellagerbestand – und mit ihm die Bandbreite, innerhalb derer Bestellmengen schwanken können. Kürzere Lieferzeiten wirken daher doppelt: Sie reduzieren nicht nur den benötigten Sicherheitsbestand (das kennen wir bereits aus dem Pooling-Kapitel), sondern dämpfen auch die Weitergabe von Prognoseschwankungen entlang der Kette.
## Ursachen des Bullwhip-Effekts
Die bisherige Herleitung erklärt den Bullwhip-Effekt bereits vollständig aus dem Zusammenspiel von Bestandspolitik, rollierender Prognose und Wiederbeschaffungszeit. In der grundlegenden Arbeit von @lee1997bullwhip werden vier Ursachen unterschieden, die sich in der Praxis meist überlagern:
**Demand Signaling / Prognoseaktualisierung.** Jede Stufe interpretiert die Bestellmenge der nachgelagerten Stufe fälschlich als eigenständiges Nachfragesignal und aktualisiert darauf ihre Prognose – genau der Mechanismus, den wir in der Simulation oben nachgebaut haben. Da die Bestellmenge selbst bereits eine verzerrte, geglättete oder verzögerte Version der Endkundennachfrage ist, verstärkt sich der Prognosefehler mit jeder Stufe.
**Order Batching (Auftragsbündelung).** Aus Gründen der Bestellkosten, Transportkapazitäten (Losgrößen, Lkw-Ladungen) oder periodischer Bestellzyklen bestellen viele Unternehmen nicht kontinuierlich, sondern in gebündelten, größeren Losen. Für die vorgelagerte Stufe erscheinen dadurch künstliche, in Wirklichkeit gar nicht vorhandene Nachfragespitzen.
**Preisschwankungen und Promotions.** Temporäre Preisnachlässe oder Sonderaktionen führen dazu, dass Kunden – Endverbraucher wie gewerbliche Abnehmer – *Forward Buying* betreiben: Sie kaufen in der Aktionsperiode deutlich mehr, als sie kurzfristig benötigen, und in der Folgeperiode entsprechend weniger. Die beobachtete Nachfrage schwankt dadurch stärker, als es der tatsächliche Verbrauch rechtfertigen würde.
**Rationierung und Shortage Gaming.** Kommt es – etwa wegen einer Lieferengpasssituation – zu einer anteiligen Zuteilung (*Rationierung*) durch den Lieferanten, haben Kunden einen Anreiz, ihre Bestellmengen strategisch zu überhöhen, um trotz Rationierung genügend Ware zugeteilt zu bekommen. Sobald sich die Lage entspannt, werden überzählige Bestellungen storniert – für den Lieferanten bleibt eine scheinbar hochvolatile, in Wahrheit aber strategisch verzerrte Nachfrage zurück.
Die Vorlesung fächert diese vier Grundursachen in eine feinere Übersicht mit acht Mechanismen auf, die sich in der Praxis gut als Checkliste eignet:
| Ursache | Wirkungsmechanismus | Zuordnung nach Lee et al. |
|:---|:---|:---|
| Lokale Prognosen | Bestellungen werden als tatsächliche Nachfrage interpretiert | Demand Signaling |
| Prognoseaktualisierung | Kleine Nachfrageänderungen führen zu Anpassungen der Zielbestände | Demand Signaling |
| Lange Lieferzeiten | Entscheidungen müssen weit in die Zukunft wirken (Multiplikator $l+1$) | Demand Signaling (verstärkend) |
| Auftragsbündelung | Seltene Großbestellungen erzeugen künstliche Bedarfsspitzen | Order Batching |
| Preisaktionen | Vorratskäufe verzerren die beobachtete Nachfrage | Preisschwankungen |
| Rationierung | Akteure bestellen strategisch mehr als ihren tatsächlichen Bedarf | Shortage Gaming |
| Fehlende Transparenz | Endkundennachfrage ist nicht für alle Stufen sichtbar | übergreifend |
| Lokale Zielsysteme | Stufen optimieren individuell statt systemweit | übergreifend |
Alle vier Ursachen haben gemeinsam, dass sie auf **fehlender oder verzögerter Information** über die tatsächliche Endkundennachfrage beruhen und dass jede Stufe ausschließlich lokal – im eigenen Interesse und mit eigenen, unvollständigen Informationen – optimiert, ohne die Rückwirkung auf die gesamte Kette zu berücksichtigen.
## Empirische Befunde und Folgen
Der Bullwhip-Effekt ist kein theoretisches Konstrukt, sondern empirisch vielfach belegt. In einer Stichprobe von 4.689 börsennotierten US-Unternehmen zeigten rund **zwei Drittel** eine positive Verstärkung der Beschaffungs- gegenüber der Absatzvariabilität [@bray2012information]. Die mittlere Verstärkung betrug 15,8 % der Nachfragevariabilität, der Median 6,7 % – die Verteilung ist also rechtsschief: Wenige Unternehmen weisen einen sehr starken Effekt auf. In absoluten Größen lag die quartalsweise Standardabweichung der vorgelagerten Bestellungen im Mittel um rund 20 Mio. US-Dollar über derjenigen der beobachteten Nachfrage. Ergänzende Arbeiten zeigen, dass ein stärkerer Bullwhip-Effekt systematisch mit höheren Lagerbeständen **und gleichzeitig** mehr Fehlmengen einhergeht [@yao2020empirically; @chen2012bullwhip] – Sicherheitsbestände allein kompensieren die zusätzliche Unsicherheit also nicht. Bemerkenswert ist zudem, dass auf aggregierter Ebene (z. B. Monats- oder Kategoriedaten) berechnete Kennzahlen den tatsächlichen Bullwhip-Effekt auf Ebene einzelner Artikel und Wochen systematisch unterschätzen [@yao2020empirically] – wer den Effekt im eigenen Unternehmen messen will, sollte deshalb möglichst granular vorgehen. Auch Studien zu realen Zulieferernetzwerken – etwa im Toyota-Produktionsnetzwerk – bestätigen, dass die Struktur einer Lieferkette (Anzahl Stufen, Konzentration der Zulieferer) die Weitergabe und Verstärkung von Schwankungen maßgeblich mitbestimmt [@kito2014structure].
Als Management-Botschaft fasst die Vorlesung zusammen: Nicht nur die Endkundennachfrage erzeugt Volatilität, sondern *Nachfragesignal + lokale Disposition = Bestellvarianz*. Die operativen und ökonomischen Folgen des Bullwhip-Effekts sind vielfältig:
| Operative Folgen | Ökonomische Folgen |
|---|---|
| Schwankende Produktionsprogramme | Höhere Kapitalbindung |
| Instabile Kapazitätsauslastung | Höhere Lagerkosten |
| Eiltransporte und Sondermaßnahmen | Höhere Obsoleszenzrisiken |
| Hohe Bestände und dennoch Fehlmengen | Höhere Rüst- und Produktionskosten |
| Niedrigere Lieferfähigkeit | Höhere Transportkosten |
| Höhere Planungsunsicherheit | Umsatz- und Deckungsbeitragsverluste |
## Gegenmaßnahmen
Da die Ursachen des Bullwhip-Effekts vor allem in fehlender Information und lokaler Optimierung liegen, setzen die wirksamsten Gegenmaßnahmen genau dort an:
| Hebel | Maßnahme | Wirkung |
|---|---|---|
| Informationsfluss | Point-of-Sale-Daten (POS) mit vorgelagerten Stufen teilen | reduziert den Prognosefehler an jeder Stufe |
| Bestandsverantwortung | **Vendor Managed Inventory (VMI)**: der Lieferant disponiert den Bestand seines Kunden selbst | vermeidet doppelte, gegenläufige Bestandsanpassungen |
| Gemeinsame Planung | **CPFR** (*Collaborative Planning, Forecasting and Replenishment*): Kunde und Lieferant erstellen eine gemeinsame Prognose | reduziert lokale Prognoseverzerrungen |
| Bestellpolitik | kleine, häufige statt große, seltene Bestellungen | reduziert Order-Batching-Effekte |
| Lieferzeit | Informations- und Lieferzeiten verkürzen (u. a. durch **EDI**, elektronischen Datenaustausch) | reduziert die Schutzperiode und damit den Verstärkungsfaktor $(l+1)$ |
| Preispolitik | stabile Preise statt häufiger Promotions (*Every-Day-Low-Pricing*) | reduziert künstliche Bedarfsspitzen durch Forward Buying |
| Allokation | Rationierung nach historischen Verkaufsmengen statt nach aktuellen Bestellmengen | reduziert Anreize zum Shortage Gaming |
| Steuerungslogik | Gesamtoptimum statt rein lokaler Zielgrößen anstreben | koordiniert Bestell- und Bestandsentscheidungen über die ganze Kette |
Der gemeinsame Nenner dieser Maßnahmen ist **Koordination**: Je mehr Information eine Stufe über die tatsächliche Endkundennachfrage – statt nur über die (bereits verzerrten) Bestellungen ihrer direkten Nachbarstufe – erhält, desto kleiner wird der Prognosefehler, und desto geringer fällt die Verstärkung entlang der Kette aus [@lee1997bullwhip; @chopra2025supply]. Genau diese Erkenntnis ist einer der wichtigsten Impulse für die informationstechnische Vernetzung von Supply Chains, wie sie heute über ERP-Systeme, elektronischen Datenaustausch und gemeinsame Planungsplattformen Standard ist.
## Zusammenfassung
Dieses Kapitel hat gezeigt, dass eine scheinbar harmlose, rationale Bestandspolitik – der Order-up-to-Ansatz aus den vorigen Kapiteln –, sobald sie über mehrere Stufen hintereinander angewendet wird, systematisch zu einer Verstärkung der Nachfrageschwankungen führt: dem **Bullwhip-Effekt**. Wir haben diesen Effekt formal definiert, mit dem **Varianzverhältnis** $B=\operatorname{Var}(q_t)/\operatorname{Var}(d_t)$ gemessen und in einer eigenen R-Simulation einer mehrstufigen Lieferkette – dem Kern des klassischen **Beergames** – nachvollzogen. Die vier klassischen Ursachen (Demand Signaling, Order Batching, Preisschwankungen, Rationierung) erklären, warum der Effekt selbst bei rationalem Verhalten aller Beteiligten auftritt, während empirische Studien seine erhebliche wirtschaftliche Bedeutung belegen. Gegenmaßnahmen wie Informationsaustausch, VMI und CPFR setzen konsequent an der zugrundeliegenden Ursache an: fehlender Transparenz über die tatsächliche Nachfrage.
Auf der R-Seite haben Sie in diesem Kapitel gelernt, Zeitreihen als einfache Vektoren zu begreifen und mit `diff()` Periodenveränderungen zu berechnen, mit `dplyr::lag()` Zeitreihen gegeneinander zu verschieben, eine mehrstufige Simulation als verschachtelte Schleife zu programmieren sowie Ergebnisse mehrerer Gruppen mit `facet_wrap()` übersichtlich nebeneinander darzustellen.
::: {.kontrollfragen}
**Kontrollfragen**
1. Definieren Sie den Bullwhip-Effekt und erläutern Sie, warum ihn ein Varianzverhältnis $B>1$ anzeigt.
2. Warum kann der Bullwhip-Effekt auch dann auftreten, wenn jede Stufe einer Supply Chain vollkommen rational nach einer Order-up-to-Regel bestellt?
3. Nennen und erläutern Sie die vier klassischen Ursachen des Bullwhip-Effekts nach Lee, Padmanabhan und Whang.
4. Wie wirkt sich eine längere Wiederbeschaffungszeit $l$ auf die Stärke des Bullwhip-Effekts aus, und warum?
5. Beschreiben Sie Aufbau und Ziel des Beergames. Welche zentrale Erkenntnis des Supply Chain Managements macht es erfahrbar?
6. Erklären Sie den Unterschied zwischen `diff()` und `dplyr::lag()` bei der Arbeit mit Zeitreihen in R.
7. Was besagt der Begriff Vendor Managed Inventory (VMI), und inwiefern reduziert er den Bullwhip-Effekt?
8. Berechnen Sie die untere Schranke des Varianzverhältnisses nach Chen et al. für $L = 2$ und ein Schätzfenster von $p = 3$ bzw. $p = 10$ Perioden. Was folgt daraus für die Wahl des Prognoseverfahrens?
9. Warum bestellen Teilnehmer des Beergames systematisch zu viel, sobald Fehlmengen aufgetreten sind? Erläutern Sie den Begriff *supply line underweighting*.
10. Skizzieren Sie mit eigenen Worten, wie eine mehrstufige Simulationsschleife in R aufgebaut sein muss, damit jede Stufe die Bestellungen der jeweils nachgelagerten Stufe als eigene Nachfrage verwendet.
:::
## Ausblick
Mit dem Bullwhip-Effekt schließt der Teil zum Unsicherheits- und Risikomanagement in Supply Chains den Bogen zu einem Thema, das alle vorangegangenen Kapitel implizit begleitet hat: dem Umgang mit **Unsicherheit** in Supply Chains. Standortentscheidungen, Kostenstrukturen, Pooling-Effekte und das Newsvendor-Modell haben gezeigt, wie einzelne Stufen und einzelne Entscheidungen unter unsicherer Nachfrage optimiert werden können; der Bullwhip-Effekt macht deutlich, dass die **Summe** lokal optimaler Entscheidungen eine Lieferkette als Ganzes destabilisieren kann, wenn Information nicht geteilt wird.
In der unternehmerischen Praxis wird diesem Spannungsfeld nicht mit einem einzelnen Modell begegnet, sondern mit einem Bündel an **Koordinationsmechanismen**, die in diesem Kapitel bereits angesprochen wurden: dem systematischen Teilen von Verkaufsdaten, gemeinsamer Bedarfsplanung (CPFR), der Übertragung von Bestandsverantwortung an Lieferanten (VMI) sowie einer durchgängigen informationstechnischen Vernetzung der Supply-Chain-Partner. Diese Mechanismen ersetzen die in diesem Buch entwickelten quantitativen Modelle nicht – sie sind vielmehr die organisatorische und technische Infrastruktur, innerhalb derer Parameter wie $\mu$, $\sigma$ und $l$ überhaupt zuverlässig geschätzt und die hier hergeleiteten Formeln sinnvoll angewendet werden können. Die folgenden Kapitel wenden sich der **Distributionslogistik** zu, also der Frage, wie die Ware physisch zum Kunden gelangt. Sie folgen dem Warenfluss von innen nach außen: von der Kommissionierung im Lager (Kapitel [-@sec-lager]) über Verkehrsmittel und Transportkosten (Kapitel [-@sec-verkehrsmittel]) und die Wege im Straßennetz (Kapitel [-@sec-kuerzeste-wege]) bis zur Tourenplanung (Kapitel [-@sec-tourenplanung]).
::: {.callout-tip}
## Übungen und Fallstudie
Aufgaben zur Klausurvorbereitung mit ausklappbaren Musterlösungen (Teil 1) und eine vertiefende Gruppenfallstudie (Teil 2) zu diesem Kapitel finden Sie in **[Fallstudie 6: Der Bullwhip-Effekt](https://tkirschstein.github.io/SCM_BDBM/case_studies/case_study_06_bullwhip)**.
:::