# Standortplanung II – Diskrete Netzwerkplanungsmodelle {#sec-standort-2}
```{r}
#| label: ch5-setup
#| echo: false
#| warning: false
#| message: false
# Funktionen aus scm_functions.R einbinden (u.a. vogels_approximation(),
# .wlp_cost(), add_heuristic_wlp(), drop_heuristic_wlp())
source("../R/scm_functions.R")
source("../R/scm_helpers.R") # Darstellungshilfen (Farben, Tabellen, Formatierung)
library(tidyverse)
library(knitr)
library(kableExtra)
```
::: {.lernziele}
**Lernziele**
Nach diesem Kapitel können Sie …
- diskrete Standort- und Netzwerkplanungsprobleme **formulieren**,
- Transport-, Umschlags- und Standortentscheidungen in einem Netzwerk **modellieren**,
- zentrale Entscheidungsvariablen, Zielfunktionen und Nebenbedingungen **interpretieren**,
- Ergebnisse diskreter Netzwerkmodelle für strategische Standortentscheidungen **bewerten**,
- ein WLP mit dem R-Paket `ompr` exakt lösen und das Ergebnis ökonomisch einordnen,
- die Grundideen konstruktiver Add- und Drop-Heuristiken nachvollziehen, in R anwenden und ihre Lösungsgüte beurteilen,
- Listen, `purrr::map()` und Matrizen als R-Werkzeuge zur Strukturierung und Auswertung von Netzwerkplanungsdaten einsetzen.
**Literatur zur Vertiefung**
- Transport-, Umschlags- und Netzwerkmodelle: @guenther2012produktion, Kapitel 4.
- Diskrete Standortmodelle, Algorithmen und Anwendungen: @daskin2013network, Kapitel 1–4.
- Theorie und Anwendungen der Standortplanung: @drezner2002facility.
:::
## Von der kontinuierlichen zur diskreten Standortplanung
Im vorangegangenen Kapitel haben Sie gelernt, wie man mit dem Center-of-Gravity-Ansatz und dem Weiszfeld-Algorithmus einen *beliebigen* Punkt in der Ebene bestimmt, der die gewichteten Entfernungen zu einer Menge von Nachfragepunkten minimiert. Am Beispiel der **SushiFresh GmbH** – einem regionalen Hersteller frischer Sushi-Boxen im Rhein-Main-Gebiet, der täglich sechs Supermarkt-Filialen beliefert – lag der so berechnete Optimalpunkt zwischen Raunheim und Frankfurt, deutlich zur nachfragestärksten Filiale Frankfurt hin verschoben. Dieser kontinuierliche Blick auf die Standortwahl ist analytisch elegant, in der unternehmerischen Praxis aber nur bedingt hilfreich: SushiFresh kann eine Produktionsstätte nicht exakt an den berechneten Koordinaten errichten, sondern muss unter den tatsächlich verfügbaren Gewerbegrundstücken, Hallen oder Bestandsimmobilien auswählen. Genehmigungsrecht, Grundstückspreise, Verkehrsanbindung und Lebensmittelhygiene-Auflagen schränken die Menge realistisch nutzbarer Standorte auf eine **endliche, vorab bekannte Menge von Alternativen** ein. Genau dies ist der Ausgangspunkt der **diskreten Standortplanung**: Anstelle eines Optimierungsproblems über die gesamte Ebene $\mathbb{R}^2$ steht eine **Auswahlentscheidung** aus einer festen Liste potenzieller Standorte im Mittelpunkt.
In Kapitel [-@sec-standort-1] wurde die Standortfrage für SushiFresh bereits zweimal aufgegriffen: Zunächst wurde mittels **AHP** (*Analytic Hierarchy Process*) eine qualitative Bewertung dreier Kandidatenstandorte vorgenommen – mit dem Ergebnis, dass **Mainz-Hechtsheim** knapp vor Raunheim lag, wobei die Kriteriengewichte auf nicht ganz konsistenten Urteilen beruhten. Anschließend lieferte der **Center-of-Gravity-/Weiszfeld-Ansatz** einen kontinuierlichen Optimalpunkt in der Mitte des Absatzgebiets. Dieses Kapitel stellt die Standortfrage ein drittes Mal – nun auf Basis harter **Kostenzahlen**: fixe Kosten für den Betrieb eines Standorts und variable Transportkosten zu den belieferten Filialen. Wie sich zeigen wird, kommt eine rein kostenbasierte, diskrete Analyse zu einem anderen Ergebnis als die qualitative Vorauswahl – und genau diese Spannung zwischen beiden Verfahren wird am Ende des Kapitels explizit diskutiert.
::: {.definition}
**Definition: Diskrete Standortplanung**
Bei der diskreten Standortplanung wird aus einer endlichen Menge vorab definierter, potenzieller Standorte diejenige Teilmenge ausgewählt, die eine gegebene Zielgröße (in der Regel die Summe aus fixen Standort- und variablen Transportkosten) minimiert. Im Gegensatz zur kontinuierlichen Standortplanung ist der Lösungsraum nicht mehr stetig, sondern **kombinatorisch**: Jede mögliche Teilmenge von Standorten stellt eine zulässige Lösung dar.
:::
Diskrete Standortentscheidungen sind stets eingebettet in ein größeres **Supply-Chain-Netzwerk**, das sich grob in die Stufen Beschaffung, Produktion, Distribution und Absatz gliedern lässt. Auf jeder dieser Stufen können Knoten (Lieferantenwerke, Produktionsstätten, Lagerhäuser, Cross-Docking-Punkte) geöffnet, geschlossen oder miteinander verbunden werden; man spricht in diesem Zusammenhang auch von **Netzwerkdesign**. Die Vorlesung betont dabei, dass in der Praxis meist nur ein **Ausschnitt** des Gesamtnetzes betrachtet wird: Man wählt konkrete Standorte auf einer oder zwei Stufen aus und hält die übrigen Stufen fest. Dieses Kapitel konzentriert sich entsprechend auf die Frage, welche Produktions- und Distributionsstandorte SushiFresh betreiben und welche Filiale von welchem Standort beliefert werden soll. Die vorgestellten Modelle lassen sich jedoch unmittelbar auf andere Netzwerkstufen übertragen.
Wir nähern uns der diskreten Standortplanung in zwei Schritten. Zunächst betrachten wir kurz den **Spezialfall**, dass die Standorte bereits feststehen und nur noch die Liefermengen optimal auf die Filialen verteilt werden müssen – das klassische **Transportproblem**, dessen Lösungsverfahren Kapitel [-@sec-transportplanung] vertieft. Anschließend erweitern wir das Modell um die eigentliche Standortentscheidung: das **Warehouse Location Problem (WLP)**, bei dem sowohl die Frage „wo?" als auch die Frage „wie viel wohin?" simultan zu beantworten ist.
## Fallbeispiel: SushiFresh GmbH
::: {.fallstudie}
**Fallstudie: Entscheidungssituation**
SushiFresh muss entscheiden, welche Kandidatenstandorte für Produktion und Distribution ausgebaut werden und welche Filiale von welchem Standort versorgt werden soll. Das Unternehmen möchte die Entscheidung so treffen, dass die jährlichen Gesamtkosten aus Fixkosten und Transport minimiert werden. Gegenüber Kapitel [-@sec-standort-1] wurde die Liste der Kandidaten um zwei weitere Gewerbeflächen erweitert: **Frankfurt-Höchst** und **Neu-Isenburg**, beide näher an den nachfragestarken Filialen im Osten des Absatzgebiets gelegen.
:::
Die sechs Filialen (Nachfrageknoten $j$, in der Vorlesung als C1–C6 bezeichnet) mit ihrer mittleren täglichen Nachfrage $\mu_j$ und der Nachfragestreuung $\sigma_j$, die uns erst in Kapitel [-@sec-unsicherheit-pooling] wieder begegnet:
```{r}
#| label: ch5-filialen-tabelle
filialen_fall <- tibble(
  ID    = paste0("C", 1:6),
  Filiale = c("Wiesbaden", "Mainz", "Frankfurt", "Ruesselsheim", "Darmstadt", "Offenbach"),
  lat   = c(50.0782, 50.0000, 50.1109, 49.9904, 49.8728, 50.0956),
  lon   = c(8.2398, 8.2711, 8.6821, 8.4116, 8.6512, 8.7761),
  mu    = c(120, 150, 280, 90, 110, 95),
  sigma = c(25, 30, 55, 20, 24, 22)
)

filialen_fall |>
  kbl(col.names = c("ID", "Filiale", "Breitengrad", "Längengrad", "μ (Boxen/Tag)", "σ")) |>
  kable_styling(bootstrap_options = c("striped", "condensed"), full_width = FALSE)
```
Die fünf Kandidatenstandorte (Angebotsknoten $i$, S1–S5) mit ihren Fixkosten: Die in Kapitel [-@sec-standort-1] genannten Beträge von 180.000 € bis 260.000 € sind einmalige Investitions- und Erschließungskosten. Für ein Jahresmodell werden sie – vereinfacht, ohne Verzinsung – linear auf eine Nutzungsdauer von fünf Jahren verteilt. So ergeben sich die jährlichen Fixkosten $f_i$:
```{r}
#| label: ch5-standorte-tabelle
standorte_fall <- tibble(
  ID          = paste0("S", 1:5),
  Standort    = c("Wiesbaden-Erbenheim", "Mainz-Hechtsheim", "Raunheim",
                  "Frankfurt-Hoechst", "Neu-Isenburg"),
  lat         = c(50.0632, 49.9698, 50.0000, 50.11146, 50.0543),
  lon         = c(8.2999, 8.2831, 8.4650, 8.54218, 8.7072),
  Investition = c(180000, 210000, 260000, 240000, 200000)
) |>
  mutate(Fixkosten = Investition / 5)   # lineare Verteilung auf 5 Jahre

standorte_fall |>
  kbl(col.names = c("ID", "Standort", "Breitengrad", "Längengrad",
                    "Investition (€)", "Fixkosten f_i (€/Jahr)"),
      format.args = list(big.mark = ".", decimal.mark = ",")) |>
  kable_styling(bootstrap_options = c("striped", "condensed"), full_width = FALSE)
```
Für die Transportkosten wird angenommen, dass jede Box auf jedem Kilometer Straßenweg 0,02 € kostet (anteilige Fahrzeug-, Personal- und Kühlkosten). Aus Straßenentfernungen und diesem Kostensatz ergibt sich die **Transportkostenmatrix** $c_{ij}$ in € je Box. Für das Fallbeispiel ist sie – wie in der Vorlesung – vorgegeben und didaktisch vereinfacht; sie ist daher nicht in jedem Eintrag mit den tatsächlichen Entfernungen im Rhein-Main-Gebiet identisch. Wie man reale Straßendistanzen selbst berechnet, zeigt der (nicht ausgeführte) Code im Anschluss.
```{r}
#| label: ch5-kostenmatrix
transportkostensatz <- 0.02   # EUR je Box und Kilometer

# Transportkosten c_ij in EUR je Box (Zeilen: Standorte S1-S5, Spalten: Filialen C1-C6)
kosten_mat <- matrix(
  c(0.12348, 0.41478, 0.47474, 0.55152, 0.85996, 0.18220,
    0.09206, 0.51490, 0.59168, 0.88578, 0.73856, 0.78004,
    0.48168, 0.27202, 0.17036, 0.54650, 0.44772, 0.12592,
    0.61176, 0.66708, 0.89392, 0.33502, 0.68526, 0.74242,
    0.50226, 0.87512, 0.90576, 0.60740, 0.32042, 0.11400),
  nrow = 5, byrow = TRUE,
  dimnames = list(standorte_fall$ID, filialen_fall$ID)
)

# Implizite Strassendistanzen in km (Kosten / Kostensatz)
round(kosten_mat / transportkostensatz, 1)
```
```{r}
#| label: ch5-osrm
#| eval: false
# Nicht ausgefuehrt (benoetigt Internetzugang): So lassen sich die
# Strassendistanzen mit dem OSRM-Routingdienst selbst berechnen.
library(osrm)
tab <- osrmTable(
  src = standorte_fall[, c("lon", "lat")],
  dst = filialen_fall[, c("lon", "lat")],
  measure = "distance"
)
dist_km <- tab$distances / 1000
```
::: {.callout-note}
## Hinweis zur Lesart der Matrix
In realen Anwendungen ist eine Transportkostenmatrix weder symmetrisch noch an der Luftlinie orientiert: Straßenwege, Autobahnauffahrten und Rheinbrücken bestimmen die tatsächliche Entfernung, und Fahrzeiten können je nach Tageszeit stark schwanken. Solche Effekte sind der Grund, warum diskrete Modelle in der Praxis mit Straßendistanzen oder -fahrzeiten statt mit euklidischen Distanzen arbeiten – und warum die kontinuierlichen Verfahren aus Kapitel [-@sec-standort-1] nur eine erste Orientierung liefern.
:::
## Ein Spezialfall: das Transportproblem
Bevor wir die Standortentscheidung modellieren, lohnt ein Blick auf den Spezialfall, in dem die Standorte bereits **feststehen**. Dann bleibt nur die Frage, welche Filiale von welchem Standort mit welcher Menge beliefert wird. Das ist das klassische **Transportproblem**: $m$ Quellen mit Angebotsmengen $s_i$, $n$ Senken mit Nachfragemengen $a_j$ und Transportkosten $c_{ij}$ je Einheit. Mit den Transportmengen $x_{ij} \geq 0$ lautet das Modell
$$
\min \sum_{i} \sum_{j} c_{ij} \cdot x_{ij} \quad \text{u.d.N.} \quad \sum_{j} x_{ij} \leq s_i \;\; \forall i, \qquad \sum_{i} x_{ij} = a_j \;\; \forall j, \qquad x_{ij} \geq 0.
$$
Das Warehouse Location Problem erweitert genau dieses Modell um die Entscheidung, *welche* Quellen überhaupt geöffnet werden. Die Transportmengen $x_{ij}$ und die Kostenmatrix $c_{ij}$ tauchen deshalb im WLP unverändert wieder auf. Lösungsverfahren für das Transportproblem, also die Nordwestecken-Regel, die Vogel'sche Approximationsmethode und die exakte Lösung als LP, behandelt Kapitel [-@sec-transportplanung]. Es greift die Standortentscheidung dieses Kapitels auf und fragt, was passiert, wenn die Kapazität der gewählten Zentralküche in der Adventszeit nicht mehr ausreicht.
::: {.r-exkurs}
**R-Exkurs: Matrizen als Kosten- und Transporttableaus**
Bislang haben Sie tabellarische Daten vor allem als `data.frame`/`tibble` kennengelernt, bei denen jede Spalte einen benannten, inhaltlich unterschiedlichen Merkmalsvektor darstellt (z. B. Ort, Längengrad, Bedarf). Ein Kosten- oder Transporttableau ist dagegen eine **homogene, rein numerische Tabelle**, bei der es nicht auf Spaltennamen im inhaltlichen Sinn ankommt, sondern auf die *Position* (Zeile $i$, Spalte $j$). Dafür ist der R-Datentyp **Matrix** (`matrix()`) die natürliche Wahl – wie oben bei `kosten_mat`. Zeilen und Spalten lassen sich über `dimnames` benennen und dann gezielt ansprechen:
```{r}
#| label: ch5-matrix-zugriff
kosten_mat["S3", ] # alle Kostensaetze von Raunheim
kosten_mat[, "C3"] # Kosten, Frankfurt von jedem Standort zu beliefern
apply(kosten_mat, 2, which.min) # je Filiale: Zeilenindex des guenstigsten Standorts
```
Mit `rowSums()` und `colSums()` lässt sich später sehr einfach prüfen, ob eine berechnete Zuordnung zulässig ist: Die Spaltensummen einer Liefermatrix müssen der Nachfrage der Filialen entsprechen.
:::
## Das Warehouse Location Problem
In der Praxis ist meist nicht nur zu klären, *wie* Filialen beliefert werden, sondern auch, *von welchen* Standorten aus überhaupt geliefert werden soll. Für SushiFresh ist das die eigentliche strategische Frage: Lohnt es sich, mehrere Standorte gleichzeitig zu betreiben, oder ist eine **Konsolidierung** auf einen oder zwei Standorte günstiger? Jede Standorteröffnung ist mit einer fixen jährlichen Kostenbelastung verbunden, unabhängig davon, wie viel später tatsächlich über diesen Standort geliefert wird. Dieses Entscheidungsproblem heißt **Warehouse Location Problem (WLP)** oder auch **Uncapacitated Facility Location Problem**, wenn – wie hier – keine Kapazitätsobergrenzen je Standort unterstellt werden.
::: {.definition}
**Definition: Warehouse Location Problem**
Gegeben seien eine Menge potenzieller Standorte $i \in I$ mit jährlichen Eröffnungskosten $f_i$ sowie eine Menge von Kundenstandorten $j \in J$ mit Nachfragemengen $a_j$. Für jede mögliche Transportverbindung $(i,j) \in E \subseteq I \times J$ entstehen Transportkosten $c_{ij}$ pro belieferter Einheit. Gesucht ist die Teilmenge der zu eröffnenden Standorte sowie die zugehörige Zuordnung von Kunden zu Standorten, welche die Summe aus Eröffnungs- und Transportkosten minimiert.
:::
Im Unterschied zum Transportproblem enthält das WLP nun **zwei Arten von Entscheidungsvariablen**: eine binäre Standortentscheidung $y_i \in \{0,1\}$ (Standort $i$ wird eröffnet oder nicht) und weiterhin die kontinuierlichen Transportmengen $x_{ij} \geq 0$. Das vollständige Modell lautet:
$$
\min \rightarrow \sum_{i \in I} y_i \cdot f_i + \sum_{(i,j) \in E} x_{ij} \cdot c_{ij}
$$
unter den Nebenbedingungen
$$
\begin{align}
\sum_{(i,j) \in E} x_{ij} &= a_j & \forall j \in J &\quad\rightarrow \text{Nachfrage vollständig befriedigen} \\
x_{ij} &\leq y_i \cdot a_j & \forall (i,j) \in E &\quad\rightarrow \text{nur Transporte von eröffneten Standorten} \\
x_{ij} &\geq 0 & \forall (i,j) \in E &\quad\rightarrow \text{Transportmengen nicht negativ} \\
y_i &\in \{0,1\} & \forall i \in I &\quad\rightarrow \text{Standort wird eröffnet oder nicht}
\end{align}
$$
Die zweite Nebenbedingung ist der entscheidende Unterschied zum reinen Transportproblem: Solange $y_i = 0$ ist (Standort $i$ nicht eröffnet), zwingt sie *alle* zugehörigen Transportmengen $x_{ij}$ auf null – ein geschlossener Standort kann keine Filiale beliefern. Erst wenn $y_i = 1$ gesetzt wird, ist $x_{ij}$ bis maximal zur vollen Nachfrage $a_j$ zulässig. Weil sowohl kontinuierliche als auch binäre Variablen im selben Modell auftreten, handelt es sich um ein **gemischt-ganzzahliges lineares Optimierungsmodell** (*Mixed-Integer Linear Program*, MILP) – eine deutlich schwierigere Problemklasse als das reine LP des Transportproblems.
::: {.vertiefung}
**Theorie-Vertiefung: Struktur der Optimallösung und "starke" Formulierungen**
Weil das WLP keine Kapazitätsgrenzen kennt, hat seine Optimallösung eine einfache Struktur: Sobald feststeht, welche Standorte geöffnet sind, wird jede Filiale **vollständig vom günstigsten offenen Standort** beliefert. Eine Aufteilung einer Filiale auf mehrere Standorte kann nie besser sein, da jede Box auf der billigsten verfügbaren Verbindung transportiert werden sollte. Die eigentliche Schwierigkeit des Problems liegt deshalb allein in der kombinatorischen Auswahl der Standortmenge – bei $|I|$ Kandidaten gibt es $2^{|I|}-1$ nichtleere Teilmengen. Genau diese Beobachtung nutzen die Add- und Drop-Heuristiken sowie die Hilfsfunktion `.wlp_cost()`.
Für die exakte Lösung mit einem MILP-Solver ist die Formulierung der Kopplungsbedingung bedeutsam. Statt der hier verwendeten **disaggregierten** Form $x_{ij} \leq y_i \cdot a_j$ (eine Bedingung je Verbindung) ließe sich auch eine **aggregierte** Form $\sum_j x_{ij} \leq y_i \cdot \sum_j a_j$ (eine Bedingung je Standort) aufschreiben. Beide Formulierungen haben dieselben ganzzahligen Lösungen. Solver arbeiten jedoch mit der **LP-Relaxation**, in der $y_i$ Werte zwischen 0 und 1 annehmen darf. In der aggregierten Form genügt dann ein sehr kleines $y_i$, um einen Standort "ein bisschen" zu öffnen und alle Filialen darüber zu beliefern – die Relaxation liefert eine schwache untere Schranke, und das Branch-and-Bound-Verfahren muss viele Verzweigungen durchsuchen. Die disaggregierte Form verlangt dagegen für jede einzelne Verbindung $y_i \geq x_{ij}/a_j$ und liegt damit viel näher an der ganzzahligen Lösung; man spricht von einer **starken Formulierung**. Für das unkapazitierte WLP ist die LP-Relaxation der disaggregierten Form häufig bereits ganzzahlig [@daskin2013network].
:::
Anders als im Transportproblem des vorigen Abschnitts rechnen wir das WLP auf **Jahresbasis**: Die Fixkosten $f_i$ sind Jahreswerte, und auch die Nachfrage muss von der Tages- auf die Jahresebene hochgerechnet werden. Das Zahlenbeispiel der Vorlesung verwendet dafür vereinfachend den Faktor 1.000 ($a_j = 1.000 \cdot \mu_j$). Wir übernehmen diese Annahme zunächst und prüfen am Ende des Kapitels, wie empfindlich das Ergebnis auf eine realistischere Hochrechnung mit 365 Verkaufstagen reagiert. Bevor wir die Daten zusammenstellen, lohnt sich ein Blick auf ein weiteres zentrales R-Konzept: die **Liste**.
::: {.r-exkurs}
**R-Exkurs: Listen als flexible Datenstruktur**
Ein Vektor in R kann nur Elemente **eines** Datentyps aufnehmen, und ein `data.frame`/`tibble` verlangt, dass alle Spalten dieselbe Länge haben. Häufig möchte man aber unterschiedlich strukturierte, unterschiedlich lange oder unterschiedlich typisierte Objekte gemeinsam verwalten – etwa den Namen eines Standorts (Text), seine Koordinaten (ein Vektor der Länge 2), seine Fixkosten (eine Zahl) und einen Status (logisch). Genau dafür ist die **Liste** (`list()`) gedacht: ein Container, dessen Elemente beliebige – auch verschiedenartige – R-Objekte sein dürfen.
Der Zugriff auf ein benanntes Element erfolgt entweder mit dem Dollarzeichen `$name` oder mit doppelten eckigen Klammern `[["name"]]` bzw. `[[position]]`. Der Unterschied zu einfachen eckigen Klammern `[ ]` ist wichtig: `liste[1]` liefert eine *Teilliste* mit einem Element, `liste[[1]]` liefert den *Inhalt* dieses Elements selbst.
```{r}
#| label: ch5-liste-basics
# Eine einzelne Standortinformation als Liste
standort_info <- list(
  name        = "Wiesbaden-Erbenheim",
  koordinaten = c(lon = 8.2999, lat = 50.0632),  # Vektor als Element
  fixkosten   = 36000,
  aktiv       = TRUE
)

standort_info$name                     # Zugriff via $
standort_info[["fixkosten"]] # Zugriff via [[ ]] mit Namen
standort_info[["koordinaten"]]["lat"] # verschachtelter Zugriff
```
Listen sind nicht nur zur *Eingabe* nützlich – auch die **Rückgabewerte** vieler R-Funktionen sind Listen, sobald mehr als ein Ergebnis zurückgegeben werden soll. So liefern etwa `add_heuristic_wlp()` und `drop_heuristic_wlp()`, die wir weiter unten einsetzen, ihr Ergebnis als Liste mit den Feldern `open_warehouses`, `fixed_cost`, `transport_cost`, `total_cost` und `assignment`.
:::
Für die eigentliche Rechnung benötigen wir die Fixkosten und die Jahresnachfrage als **benannte Vektoren** sowie die Kostenmatrix `kosten_mat`:
```{r}
#| label: ch5-wlp-daten
fixkosten_vec  <- setNames(standorte_fall$Fixkosten, standorte_fall$ID)   # EUR/Jahr
nachfrage_jahr <- setNames(filialen_fall$mu * 1000, filialen_fall$ID)     # Boxen/Jahr (Faktor 1.000)

fixkosten_vec
nachfrage_jahr
```
Fünf Standorte bedeuten $2^5 - 1 = 31$ mögliche nichtleere Standortkonfigurationen – klein genug, um sie im nächsten R-Exkurs vollständig durchzurechnen.
::: {.r-exkurs}
**R-Exkurs: `purrr::map()` – eine Funktion auf jedes Element anwenden**
Häufig möchte man dieselbe Berechnung auf jedes Element einer Liste oder eines Vektors anwenden – zum Beispiel: "berechne für jede mögliche Standortkombination die Gesamtkosten". Statt dafür eine `for`-Schleife (Kapitel [-@sec-standort-1]) zu schreiben, bietet das `tidyverse`-Paket `purrr` dafür die Funktionenfamilie `map()`. `map(x, f)` wendet die Funktion `f` auf jedes Element von `x` an und gibt eine Liste zurück; `map_dbl(x, f)` tut dasselbe, verlangt aber, dass `f` je Element eine einzelne Zahl (`double`) liefert, und vereinfacht das Ergebnis dann automatisch zu einem numerischen Vektor. Das ist der direkte Verwandte von `sapply()` aus Kapitel [-@sec-standort-1], mit dem Vorteil, dass der Rückgabetyp klar feststeht und Fehler dadurch früher auffallen.
Wir erzeugen zunächst alle nichtleeren Teilmengen der fünf Standorte mit der Basis-R-Funktion `combn()` und werten sie anschließend mit `map_dbl()` und der Hilfsfunktion `.wlp_cost()` aus `scm_functions.R` aus, die für eine gegebene Menge offener Standorte die optimale Filialzuordnung (jede Filiale zum günstigsten offenen Standort) sowie die resultierenden Gesamtkosten berechnet:
```{r}
#| label: ch5-purrr-map
n_I <- length(fixkosten_vec)

# Alle nichtleeren Teilmengen von {1, ..., 5}: combn(5, k) liefert alle
# Kombinationen der Groesse k, unlist(..., recursive = FALSE) fasst sie zu
# einer einzigen Liste zusammen
alle_teilmengen <- unlist(
  lapply(1:n_I, function(k) combn(n_I, k, simplify = FALSE)),
  recursive = FALSE
)
length(alle_teilmengen)  # 2^5 - 1 = 31
# Fuer jede Teilmenge die Gesamtkosten berechnen
kosten_je_teilmenge <- map_dbl(alle_teilmengen, function(S) {
  .wlp_cost(S, fixkosten_vec, kosten_mat, nachfrage_jahr)$total
})

beste_teilmenge <- alle_teilmengen[[which.min(kosten_je_teilmenge)]]
standorte_fall$Standort[beste_teilmenge]
round(min(kosten_je_teilmenge))
```
Die vollständige Enumeration zeigt: Am günstigsten ist es, **zwei** Standorte zu betreiben – **Wiesbaden-Erbenheim und Raunheim** – mit Gesamtkosten von rund `r format(round(min(kosten_je_teilmenge)), big.mark = ".", decimal.mark = ",")` €/Jahr. Die zehn besten Konfigurationen im Überblick:
```{r}
#| label: ch5-brute-force-tabelle
brute_force_df <- map_dfr(alle_teilmengen, function(S) {
  res <- .wlp_cost(S, fixkosten_vec, kosten_mat, nachfrage_jahr)
  tibble(
    Standorte       = paste(standorte_fall$ID[S], collapse = " + "),
    Anzahl          = length(S),
    Fixkosten       = res$fixed,
    Transportkosten = round(res$transport),
    Gesamtkosten    = round(res$total)
  )
}) |>
  arrange(Gesamtkosten)

brute_force_df |>
  head(10) |>
  kbl(col.names = c("Offene Standorte", "Anzahl", "Fixkosten (€)",
                    "Transportkosten (€)", "Gesamtkosten (€/Jahr)"),
      format.args = list(big.mark = ".", decimal.mark = ",")) |>
  kable_styling(bootstrap_options = c("striped", "condensed"), full_width = FALSE) |>
  row_spec(1, bold = TRUE, background = "#E8F4F1")
```
Die Rangliste ist aufschlussreich. Erstens liegen die besten Lösungen sehr dicht beieinander: Die Kombination Mainz-Hechtsheim + Raunheim und der **Einzelstandort Raunheim** sind nur wenige tausend Euro pro Jahr teurer als das Optimum. Zweitens kommt Raunheim in allen vorderen Lösungen vor – der Standort mit den höchsten Investitionskosten ist das Rückgrat jedes guten Netzes, weil er laut Kostenmatrix die nachfragestarke Filiale Frankfurt und die meisten übrigen Filialen am günstigsten erreicht. Drittens lohnt sich ein zweiter Standort im Westen (Wiesbaden-Erbenheim) nur knapp: Er spart Transportkosten zur Filiale Wiesbaden, die die zusätzlichen Fixkosten gerade eben übersteigen.
Diese Brute-Force-Suche funktioniert nur, weil $|I|=5$ sehr klein ist. Bei $|I|=20$ Standorten gäbe es bereits über eine Million, bei $|I|=50$ mehr als $10^{15}$ Teilmengen – eine vollständige Suche ist dann selbst auf leistungsfähigen Rechnern aussichtslos. Für realistische Instanzen braucht es daher entweder **effiziente exakte Verfahren** oder **Heuristiken**.
:::
## Exakte Lösung mit ompr
Das WLP lässt sich als MILP mit spezialisierten Solvern exakt lösen, ohne alle Teilmengen einzeln auszuwerten. In R übernimmt das Paket **`ompr`** (*Optimization Modeling Package for R*) die algebraische Formulierung des Modells; die eigentliche numerische Lösung wird über `ompr.roi` an einen Solver – hier `glpk`, das freie *GNU Linear Programming Kit* – delegiert. Der Charme von `ompr` liegt darin, dass sich Zielfunktion und Nebenbedingungen fast wörtlich aus der mathematischen Formulierung in R-Code übersetzen lassen.
::: {.r-exkurs}
**R-Exkurs: Algebraische Optimierungsmodellierung mit `ompr`**
Bislang haben wir Optimierungsprobleme (Center of Gravity, Weiszfeld) über **maßgeschneiderte Algorithmen** gelöst. `ompr` verfolgt einen generischeren Ansatz: Man beschreibt das Modell **deklarativ** (Variablen, Zielfunktion, Nebenbedingungen) und überlässt die Lösungssuche einem universellen Solver. Der Workflow gliedert sich in sechs Schritte:
1. `MIPModel()` – ein leeres Modellobjekt anlegen,
2. `add_variable()` – Entscheidungsvariablen mit Typ (`binary`, `continuous`, `integer`) und Indexmenge definieren,
3. `set_objective()` – die Zielfunktion formulieren (`sum_expr()` bildet dabei Summen über Indexmengen, analog zum $\sum$ in der mathematischen Notation),
4. `add_constraint()` – Nebenbedingungen formulieren, ebenfalls indiziert,
5. `solve_model()` – das Modell an einen konkreten Solver übergeben,
6. `get_solution()` – die optimalen Werte der Entscheidungsvariablen aus dem Ergebnisobjekt extrahieren.
Im folgenden Code entspricht `y[i]` der binären Standortvariable $y_i$ und `x[i,j]` der Transportmengenvariable $x_{ij}$. `sum_expr(f[i] * y[i], i = 1:n_I)` bildet exakt den Ausdruck $\sum_{i\in I} f_i \cdot y_i$; die beiden `add_constraint()`-Aufrufe setzen die Nachfrage- bzw. Kopplungsnebenbedingung aus dem WLP-Modell um.
```{r}
#| label: ch5-ompr-model
#| message: false
library(ompr)
library(ompr.roi)
library(ROI.plugin.glpk)

n_J  <- length(nachfrage_jahr)
f    <- fixkosten_vec     # Eroeffnungskosten f_i (EUR/Jahr)
a    <- nachfrage_jahr    # Nachfrage a_j (Boxen/Jahr)
c_ij <- kosten_mat        # Transportkosten (EUR/Box)

modell <- MIPModel() |>
  # Entscheidungsvariable y_i: Standort i eroeffnen (1) oder nicht (0)
  add_variable(y[i], i = 1:n_I, type = "binary") |>
  # Entscheidungsvariable x_ij: Transportmenge von Standort i zu Filiale j
  add_variable(x[i, j], i = 1:n_I, j = 1:n_J, type = "continuous", lb = 0) |>
  # Zielfunktion: Eroeffnungskosten + Transportkosten minimieren
  set_objective(
    sum_expr(f[i] * y[i], i = 1:n_I) +
      sum_expr(c_ij[i, j] * x[i, j], i = 1:n_I, j = 1:n_J),
    sense = "min") |>
  # NB1: Nachfrage jeder Filiale j vollstaendig befriedigen
  add_constraint(sum_expr(x[i, j], i = 1:n_I) == a[j], j = 1:n_J) |>
  # NB2: Transport nur von eroeffneten Standorten (x_ij <= y_i * a_j)
  add_constraint(x[i, j] <= y[i] * a[j], i = 1:n_I, j = 1:n_J)

ergebnis_milp <- solve_model(modell, with_ROI(solver = "glpk", verbose = FALSE))
```
:::
Nach dem Lösen extrahieren wir mit `get_solution()` die optimalen Werte der Variablen $y_i$ und $x_{ij}$ sowie mit `objective_value()` den optimalen Zielfunktionswert $Z^*$:
```{r}
#| label: ch5-ompr-solution
y_sol <- get_solution(ergebnis_milp, y[i])
x_sol <- get_solution(ergebnis_milp, x[i, j])

offene_idx       <- y_sol$i[y_sol$value > 0.5]
offene_standorte <- standorte_fall$Standort[offene_idx]
offene_standorte
round(objective_value(ergebnis_milp))
```
```{r}
#| label: ch5-ompr-zuordnung
x_sol |>
  filter(value > 0.001) |>
  mutate(Standort = standorte_fall$Standort[i],
         Filiale  = filialen_fall$Filiale[j],
         Menge    = value,
         Transportkosten = round(c_ij[cbind(i, j)] * value)) |>
  select(Standort, Filiale, Menge, Transportkosten) |>
  kbl(col.names = c("Standort", "Filiale", "Menge x_ij (Boxen/Jahr)", "Transportkosten (€/Jahr)"),
      format.args = list(big.mark = ".", decimal.mark = ",")) |>
  kable_styling(bootstrap_options = c("striped", "condensed"), full_width = FALSE)
```
Der Solver bestätigt das Ergebnis der vollständigen Enumeration: Es werden **Wiesbaden-Erbenheim** und **Raunheim** eröffnet. Wiesbaden-Erbenheim beliefert dabei nur die Filiale Wiesbaden, alle übrigen fünf Filialen werden aus Raunheim versorgt – jede Filiale vollständig von genau einem Standort, wie es die Theorie für das unkapazitierte WLP vorhersagt. Der entscheidende Unterschied zur Enumeration ist der **Rechenweg**: `ompr`/`glpk` musste nicht alle 31 Teilmengen einzeln auswerten, sondern nutzt intern Branch-and-Bound- und Schnittebenenverfahren, mit denen auch WLP-Instanzen mit hunderten Standorten und Kunden in vertretbarer Zeit exakt gelöst werden können.
## Heuristische Lösungsverfahren: Add- und Drop-Heuristik
Trotz der Leistungsfähigkeit moderner MILP-Solver bleibt das WLP ein **NP-schweres** Problem: Im ungünstigsten Fall wächst die zur exakten Lösung benötigte Rechenzeit exponentiell mit der Anzahl der Standorte und Kunden. Für sehr große Praxisinstanzen – ein deutschlandweites Filialnetz mit hunderten Kandidatenstandorten und tausenden Filialen, gegebenenfalls mit weiteren Nebenbedingungen (Kapazitäten, mehrstufige Netzwerke) – kann selbst ein guter Solver an Zeit- oder Speichergrenzen stoßen. In solchen Fällen sind **konstruktive Heuristiken** häufig der praktikable Weg zu einer brauchbaren, wenn auch nicht notwendigerweise optimalen Lösung.
Die Grundidee beider im Folgenden vorgestellten Heuristiken ist **greedy** (gierig): Ausgehend von einer zulässigen Startkonfiguration wird in jedem Schritt genau diejenige Änderung vorgenommen, die die Gesamtkosten am stärksten reduziert; das Verfahren stoppt, sobald keine weitere Verbesserung mehr möglich ist. Filialen werden dabei stets dem *günstigsten offenen* Standort zugeordnet ($\sigma(j) = \arg\min_{i \in S} c_{ij}$), sodass sich die Gesamtkosten einer Standortmenge $S$ eindeutig berechnen lassen als
$$Z(S) = \underbrace{\sum_{i \in S} f_i}_{\text{Eröffnung}} + \underbrace{\sum_{j \in J} \min_{i \in S} c_{ij} \cdot a_j}_{\text{Transport}}.$$
Die **Add-Heuristik** startet mit der leeren Menge $S = \emptyset$ und fügt in jedem Schritt denjenigen Standort $i^*$ hinzu, dessen Öffnung die Gesamtkosten am stärksten senkt: $\Delta_i = Z(S) - Z(S \cup \{i\})$, $i^* = \arg\max_{i \notin S} \Delta_i$. Ist $\Delta_{i^*} > 0$, wird $i^*$ geöffnet, andernfalls bricht das Verfahren ab. Ökonomisch lohnt sich das Hinzufügen eines Standorts genau dann, wenn die dadurch erzielbare **Transportkosteneinsparung** größer ist als seine **Eröffnungskosten**. Die Transportkosten sinken dabei von Schritt zu Schritt, die Fixkosten steigen.
Die **Drop-Heuristik** geht den umgekehrten Weg: Sie startet mit *allen* Standorten geöffnet ($S = I$) und schließt in jedem Schritt denjenigen Standort, dessen Schließung die Gesamtkosten am stärksten senkt ($\Delta_i = Z(S) - Z(S \setminus \{i\})$), bis auch hier keine weitere Verbesserung mehr möglich ist. Ein Standort wird geschlossen, wenn seine Fixkosten höher sind als die Transportkosten, die entstehen, weil seine Filialen auf den nächstbesten Standort umgehängt werden müssen.
| Merkmal | Add-Heuristik | Drop-Heuristik |
|:---|:---|:---|
| Start | $S = \emptyset$ (Kosten $\infty$) | $S = I$ (alle Fixkosten fallen an) |
| Richtung | aufbauend | abbauend |
| Aufwand je Schritt | $\mathcal{O}(\lvert I \rvert \cdot \lvert J \rvert)$ | $\mathcal{O}(\lvert I \rvert \cdot \lvert J \rvert)$ |
| Tendenz | eher wenige Standorte | eher mehr Standorte |
Beide Varianten sind in `R/scm_functions.R` als `add_heuristic_wlp()` bzw. `drop_heuristic_wlp()` implementiert (inklusive der internen Kostenberechnung über `.wlp_cost()`). Mit `verbose = TRUE` protokollieren sie jeden Schritt:
```{r}
#| label: ch5-add-heuristik
names(fixkosten_vec) <- standorte_fall$Standort   # Namen fuer lesbares Protokoll

add_ergebnis <- add_heuristic_wlp(
  fixed_costs        = fixkosten_vec,
  transport_cost_mat = kosten_mat,
  demand             = nachfrage_jahr,
  verbose            = TRUE
)
round(add_ergebnis$total_cost)
```
Die Add-Heuristik öffnet im ersten Schritt **Raunheim** – den Standort, der für sich allein die geringsten Gesamtkosten aller Einzelstandorte verursacht. Im zweiten Schritt wird Wiesbaden-Erbenheim hinzugefügt, weil die Transportkosteneinsparung bei der Filiale Wiesbaden die zusätzlichen Fixkosten übersteigt. Danach kann kein weiterer Standort die Kosten senken.
```{r}
#| label: ch5-drop-heuristik
drop_ergebnis <- drop_heuristic_wlp(
  fixed_costs        = fixkosten_vec,
  transport_cost_mat = kosten_mat,
  demand             = nachfrage_jahr,
  verbose            = TRUE
)
round(drop_ergebnis$total_cost)
```
Die Drop-Heuristik startet mit allen fünf offenen Standorten und schließt nacheinander Mainz-Hechtsheim, Frankfurt-Höchst und Neu-Isenburg – jeweils den Standort, dessen Fixkosten den geringsten "Transportnutzen" stiften. Übrig bleiben Wiesbaden-Erbenheim und Raunheim: **Add- und Drop-Heuristik konvergieren hier unabhängig voneinander auf dieselbe, nachweislich optimale Lösung.** Das ist keineswegs selbstverständlich – bei anderen Kostenstrukturen können beide Verfahren in unterschiedlichen, suboptimalen Lösungen enden –, zeigt hier aber, wie deutlich die Kostenstruktur des Fallbeispiels auf diese Konfiguration hinweist.
```{r}
#| label: ch5-vergleich-tabelle
vergleich <- tibble(
  Verfahren = c("Optimum (MILP)", "Add-Heuristik", "Drop-Heuristik"),
  `Offene Standorte` = c(paste(offene_standorte, collapse = ", "),
                         paste(add_ergebnis$open_names, collapse = ", "),
                         paste(drop_ergebnis$open_names, collapse = ", ")),
  Fixkosten = c(sum(f[offene_idx]), add_ergebnis$fixed_cost, drop_ergebnis$fixed_cost),
  Gesamtkosten = round(c(objective_value(ergebnis_milp),
                         add_ergebnis$total_cost, drop_ergebnis$total_cost))
) |>
  mutate(Transportkosten = Gesamtkosten - Fixkosten,
         `Gap zum Optimum (%)` = round((Gesamtkosten / Gesamtkosten[1] - 1) * 100, 2))

vergleich |>
  kbl(format.args = list(big.mark = ".", decimal.mark = ",")) |>
  kable_styling(bootstrap_options = c("striped", "condensed"), full_width = FALSE)
```
```{r}
#| label: ch5-heuristik-verlauf
#| fig-cap: "Gesamtkosten in Abhängigkeit von der Anzahl offener Standorte: bestes Netz je Standortanzahl sowie die Pfade von Add- und Drop-Heuristik"
bestes_je_anzahl <- brute_force_df |>
  group_by(Anzahl) |>
  slice_min(Gesamtkosten, n = 1) |>
  ungroup()

ggplot(bestes_je_anzahl, aes(Anzahl, Gesamtkosten / 1000)) +
  geom_line(colour = "#2F3E46") +
  geom_point(size = 3, colour = "#2F3E46") +
  geom_text(aes(label = Standorte), vjust = -1, size = 3) +
  labs(x = "Anzahl offener Standorte", y = "Gesamtkosten (T€/Jahr)",
       subtitle = "Bestes Netz je Standortanzahl (vollständige Enumeration)") +
  scale_y_continuous(limits = c(250, 420)) +
  theme_minimal(base_size = 12)
```
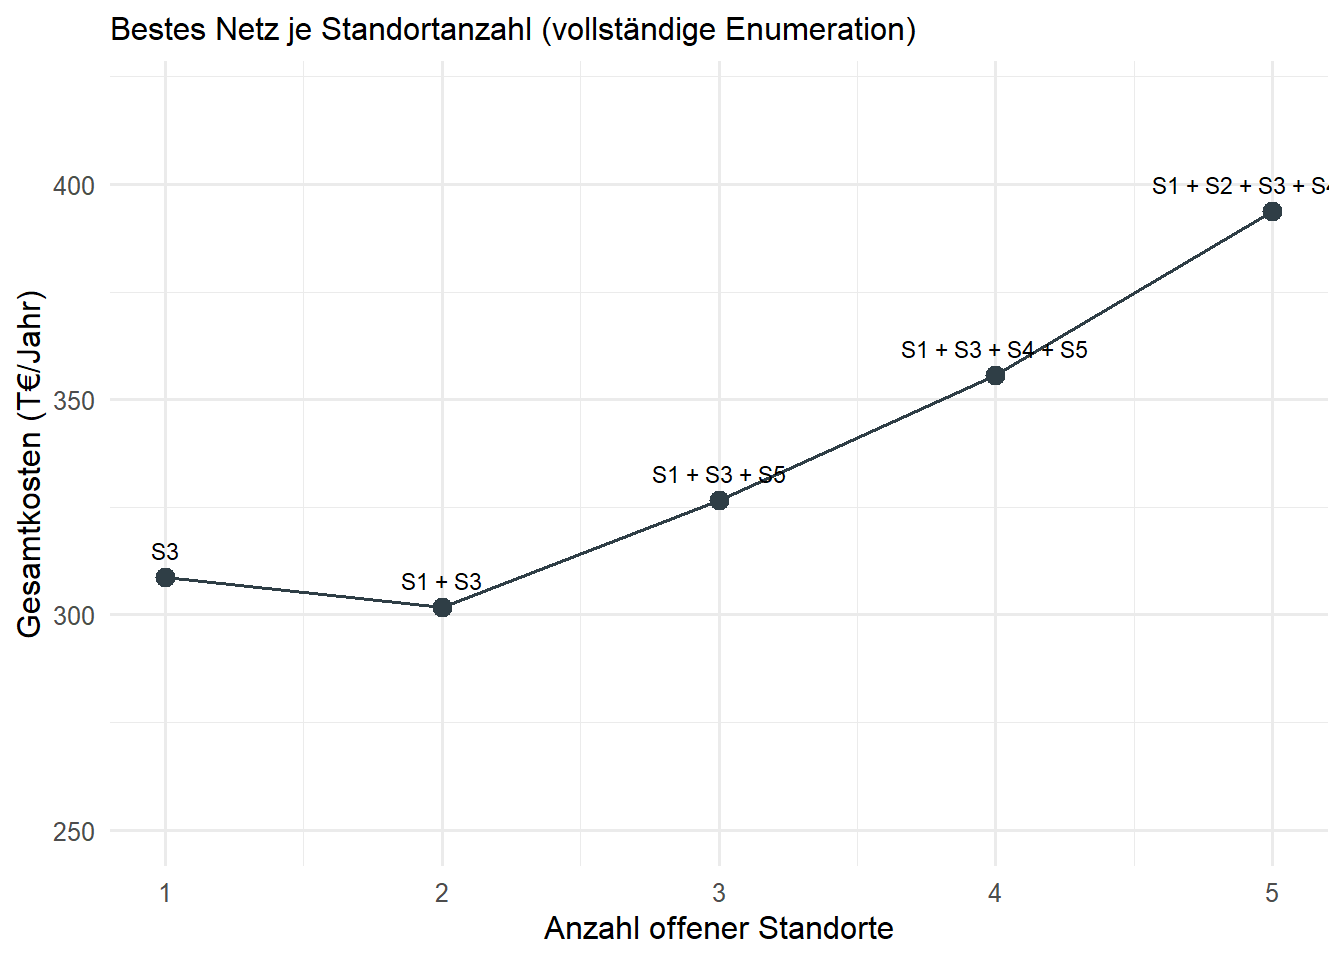
Die Abbildung zeigt die typische **U-Form** der Gesamtkosten über der Anzahl der Standorte – dieselbe Abwägungslogik, die in Kapitel [-@sec-logistikkosten] als "Entscheidung über die Anzahl der Lager" eingeführt wurde: Mit jedem zusätzlichen Standort sinken die Transportkosten, während die Fixkosten steigen. Das Minimum liegt bei zwei Standorten, die Kurve ist in der Umgebung des Minimums aber sehr flach.
Für die Praxis gilt: Add- und Drop-Heuristik sollten – wenn möglich – parallel gerechnet und mit dem Ergebnis eines exakten Verfahrens (oder zumindest einer bekannten unteren Schranke) verglichen werden, bevor eine Standortentscheidung mit langjähriger Bindungswirkung getroffen wird. Gerade bei Distributionsstandorten, die nur mit hohem Aufwand revidierbar sind, ist ein belastbares Gütemaß (der *Gap* zum Optimum) unverzichtbar [@chopra2025supply].
## Wie robust ist die Lösung? Eine Sensitivitätsanalyse
Die flache Kostenkurve legt nahe, dass die Optimallösung empfindlich auf Annahmen reagieren könnte. Die wichtigste Annahme des Zahlenbeispiels ist die Hochrechnung der Tages- auf die Jahresnachfrage mit dem Faktor 1.000. Verkauft SushiFresh an 365 Tagen im Jahr, wäre die tatsächliche Jahresmenge – und damit das Gewicht der Transportkosten gegenüber den Fixkosten – deutlich kleiner. Mit `map_dfr()` lässt sich das Optimum für verschiedene Hochrechnungsfaktoren bestimmen:
```{r}
#| label: ch5-sensitivitaet
bestes_netz <- function(faktor) {
  a_tmp  <- filialen_fall$mu * faktor
  kosten <- map_dbl(alle_teilmengen, ~ .wlp_cost(.x, fixkosten_vec, kosten_mat, a_tmp)$total)
  S      <- alle_teilmengen[[which.min(kosten)]]
  tibble(Tage_pro_Jahr = faktor,
         Optimales_Netz = paste(standorte_fall$Standort[S], collapse = " + "),
         Gesamtkosten = round(min(kosten)))
}

map_dfr(c(250, 300, 365, 500, 750, 1000), bestes_netz) |>
  kbl(format.args = list(big.mark = ".", decimal.mark = ",")) |>
  kable_styling(bootstrap_options = c("striped", "condensed"), full_width = FALSE)
```
Das Ergebnis ist lehrreich: Bei einer realistischen Hochrechnung mit 365 Verkaufstagen ist nicht mehr die Zweistandortlösung, sondern der **Einzelstandort Raunheim** optimal. Je geringer das Transportvolumen, desto weniger lohnt sich die Fixkostenbelastung eines zweiten Standorts; erst bei deutlich höheren Jahresmengen rechnet sich die zusätzliche Nähe zur Filiale Wiesbaden. Die Sensitivitätsanalyse zeigt damit, dass die Frage "ein oder zwei Standorte?" im Fallbeispiel auf der Kippe steht – während die Rolle von **Raunheim als zentralem Standort** in allen Szenarien stabil bleibt.
## Qualitative vs. quantitative Standortbewertung
An dieser Stelle lohnt sich ein Blick zurück auf Kapitel [-@sec-standort-1]: Dort hatte die **AHP-Analyse** unter den drei ursprünglichen Kandidaten knapp **Mainz-Hechtsheim** favorisiert – vor allem wegen der dort sehr gut eingeschätzten Fachkräfteverfügbarkeit. Die in diesem Kapitel durchgeführte **quantitative Kostenoptimierung** kommt zu einem deutlich anderen Schluss: Mainz-Hechtsheim taucht in keiner der besten Lösungen auf; kostenoptimal sind Raunheim (allein oder zusammen mit Wiesbaden-Erbenheim).
```{r}
#| label: ch5-ahp-vs-milp
map_dfr(1:3, function(i) {
  res <- .wlp_cost(i, fixkosten_vec, kosten_mat, nachfrage_jahr)
  tibble(Standort = standorte_fall$Standort[i], Fixkosten = res$fixed,
         Transportkosten = round(res$transport), Gesamtkosten = round(res$total))
}) |>
  kbl(caption = "Die drei ursprünglichen Kandidaten als Einzelstandort (Faktor 1.000)",
      format.args = list(big.mark = ".", decimal.mark = ",")) |>
  kable_styling(bootstrap_options = c("striped", "condensed"), full_width = FALSE)
```
Der Grund für die Diskrepanz liegt in den Transportkosten: Mainz-Hechtsheim liegt am westlichen Rand des Absatzgebiets, während der Großteil der Nachfrage (allen voran Frankfurt) weiter östlich anfällt. Die Transportkosten eines Einzelstandorts Mainz-Hechtsheim sind deshalb weit höher als die von Raunheim – ein Nachteil, den weder die niedrigeren Fixkosten noch die gute Fachkräfteverfügbarkeit aufwiegen können, sobald man Letztere nicht in Euro bewertet.
Diese Beobachtung ist kein Widerspruch, sondern verdeutlicht die **unterschiedliche Funktion** beider Verfahren im Entscheidungsprozess: Der AHP eignet sich für eine erste **Vorauswahl** unter schwer quantifizierbaren, teils weichen Kriterien und für die Einbindung unterschiedlicher Stakeholder-Perspektiven. Er ersetzt aber keine belastbare **Kostenoptimierung**, sobald harte Zahlen verfügbar sind. Umgekehrt greift eine reine Kostenoptimierung zu kurz, wenn schwer monetarisierbare Aspekte ignoriert werden: Wenn in Raunheim tatsächlich kaum geeignete Fachkräfte zu finden wären, würde sich das in höheren Personalkosten, Qualitätsproblemen oder Anlaufschwierigkeiten niederschlagen, die das WLP nicht kennt. In der Praxis ergänzen sich beide Verfahren: qualitative Verfahren zur Reduktion des Suchraums und zur Prüfung von K.-o.-Kriterien, quantitative Optimierungsmodelle zur finalen, kostenbasierten Entscheidung zwischen den verbleibenden Kandidaten.
::: {.fallstudie}
**Fallstudie: Zwischenergebnis für SushiFresh**
Das WLP empfiehlt einen zentralen Standort in **Raunheim**, gegebenenfalls ergänzt um einen zweiten Standort in Wiesbaden-Erbenheim. Da die Zweistandortlösung im Zahlenbeispiel nur rund `r format(round(brute_force_df$Gesamtkosten[brute_force_df$Standorte == "S3"] - min(brute_force_df$Gesamtkosten)), big.mark = ".", decimal.mark = ",")` €/Jahr günstiger ist als der Einzelstandort Raunheim und bei realistischer Hochrechnung sogar teurer, spricht vieles für eine **Konsolidierung der Produktion in einer Zentralküche in Raunheim**. Einen wichtigen Effekt blendet das WLP allerdings aus: die Bestände, die an jedem Standort zur Absicherung gegen Nachfrageschwankungen vorgehalten werden müssen. Genau diese Frage – wie viel Sicherheitsbestand spart eine zentrale gegenüber einer dezentralen Versorgung? – untersucht Kapitel [-@sec-unsicherheit-pooling]. Sie liefert ein zusätzliches, gewichtiges Argument für die Konsolidierung. Zuvor fragt Kapitel [-@sec-transportplanung], wie die Ware verteilt wird, wenn die Kapazität der Zentralküche in Spitzenzeiten nicht ausreicht.
:::
## Zusammenfassung
Dieses Kapitel hat den Übergang von der kontinuierlichen zur **diskreten Standortplanung** vollzogen: Statt eines beliebigen Punktes in der Ebene wird eine Teilmenge aus einer endlichen Liste vorab definierter Standortkandidaten gesucht. Als methodischen Ausgangspunkt haben wir das **klassische Transportproblem** eingeordnet, bei dem die belieferten Standorte bereits feststehen und nur die Transportflüsse kostenminimal zu bestimmen sind. Seine Lösungsverfahren folgen in Kapitel [-@sec-transportplanung].
Das **Warehouse Location Problem** erweitert dieses Modell um die eigentliche Standortentscheidung: Eine binäre Variable $y_i$ pro Standort entscheidet über Eröffnung oder Nichteröffnung, gekoppelt an die Transportmengen $x_{ij}$ über die Nebenbedingung $x_{ij} \leq y_i \cdot a_j$. Weil sowohl binäre als auch kontinuierliche Variablen auftreten, handelt es sich um ein MILP, das sich mit `ompr` in wenigen, an die mathematische Formulierung angelehnten Codezeilen exakt lösen lässt. Am Beispiel von SushiFresh zeigte sich, dass der zentral gelegene Standort Raunheim trotz der höchsten Investitionskosten das Rückgrat jedes guten Netzes bildet; ob ein zweiter Standort in Wiesbaden-Erbenheim hinzukommt, hängt – wie die Sensitivitätsanalyse zeigte – von der Hochrechnung der Nachfrage ab. Die qualitative AHP-Empfehlung (Mainz-Hechtsheim) wurde durch die Kostenoptimierung nicht bestätigt, was die Notwendigkeit beider Verfahren im Entscheidungsprozess unterstreicht. Da das WLP NP-schwer ist, sind für große Instanzen konstruktive **Add-** und **Drop-Heuristiken** ein praktikabler Ausweg – im Fallbeispiel fanden beide das globale Optimum, was allerdings keine allgemeingültige Eigenschaft dieser Verfahren ist.
Auf der R-Seite haben Sie mit diesem Kapitel vier neue Bausteine kennengelernt: **Listen** als flexibler Container für heterogene Daten und Funktionsergebnisse; **`purrr::map()`/`map_dbl()`/`map_dfr()`** zur kompakten Anwendung einer Funktion auf jedes Element einer Liste; **Matrizen** als natürliche Repräsentation positionsbasierter Tableaus mit `rowSums()`/`colSums()` zur Konsistenzprüfung; und die **algebraische Optimierungsmodellierung** mit `ompr`.
::: {.kontrollfragen}
**Kontrollfragen**
1. Worin unterscheidet sich die diskrete von der kontinuierlichen Standortplanung, und warum ist die diskrete Variante für die meisten praktischen Standortentscheidungen realistischer?
2. Worin unterscheiden sich Transportproblem und Warehouse Location Problem? Welche Entscheidung trifft das WLP zusätzlich?
3. Welche zusätzliche Entscheidungsvariable enthält das Warehouse Location Problem im Vergleich zum Transportproblem, und welche Rolle spielt die Nebenbedingung $x_{ij} \leq y_i \cdot a_j$? Warum ist sie der aggregierten Form $\sum_j x_{ij} \leq y_i \sum_j a_j$ vorzuziehen?
4. Beschreiben Sie Add- und Drop-Heuristik in eigenen Worten. Unter welcher Bedingung lohnt es sich in der Add-Heuristik, einen weiteren Standort zu öffnen?
5. Was versteht man unter dem "Gap zum Optimum", und warum ist er bei heuristischen Standortentscheidungen eine wichtige Kennzahl?
6. Erklären Sie den Unterschied zwischen einer Liste (`list()`) und einem `data.frame`/`tibble`. Nennen Sie ein Beispiel aus diesem Kapitel, bei dem eine R-Funktion ihr Ergebnis sinnvollerweise als Liste zurückgibt.
7. Warum ist im SushiFresh-Beispiel bei 365 Verkaufstagen ein Standort, bei 1.000 "Tagen" dagegen sind zwei Standorte optimal? Argumentieren Sie mit der Struktur der Zielfunktion.
8. Die AHP-Analyse (Kapitel [-@sec-standort-1]) favorisiert Mainz-Hechtsheim, die WLP-Analyse Raunheim. Erklären Sie die Diskrepanz und diskutieren Sie, wie beide Verfahren in der Praxis sinnvoll kombiniert werden können.
:::
::: {.callout-tip}
## Übungen und Fallstudie
Aufgaben zur Klausurvorbereitung mit ausklappbaren Musterlösungen (Teil 1) und eine vertiefende Gruppenfallstudie (Teil 2) zu diesem Kapitel finden Sie in **[Fallstudie 3: Diskrete Standortplanung und Transportplanung](https://tkirschstein.github.io/SCM_BDBM/case_studies/case_study_03_wlp_batterielogistik)**.
:::