%%{init: {
  "theme": "base",
  "themeVariables": {
    "fontSize": "11px"
  },
  "flowchart": {
    "nodeSpacing": 20,
    "rankSpacing": 25
  }
}}%%

flowchart TB
    A["Schafhaltung"] --> B["Schur und Sortierung<br/>der Rohwolle"]
    B --> D["Spinnen zu Wollgarn"]
    D --> E["Weben des weißen Wolltuchs"]
    E --> F["Walken, Reinigen,<br/>Bleichen, Zuschneiden"]
    F -->|"ca. 100 Sesterzen je Pfund"| H["Anbringen des Purpursaums<br/>Konfektion der Toga"]

    P2["Schneckenzucht"]
    P2 --> P3["Drüsen entnehmen<br/>(Hypobranchialdrüse)"]
    P3 --> P4["Drüsen salzen &<br/>über mehrere Tage erhitzen"]
    P4 --> P7["Wolle / Wollpartien<br/>purpur färben"]
    P7 -->|"4.000 Sesterzen je Pfund"| H

    T["Gesamtwert: 400 - 1.200 Sesterzen je Toga"]

    H ~~~ T

    classDef raw fill:#f5f1e8,stroke:#7a6a4f,color:#2b2b2b;
    classDef proc fill:#eef4fb,stroke:#5179a6,color:#112d3d;
    classDef purple fill:#f4e8fb,stroke:#7a3ea1,color:#321744;
    classDef note fill:#fff8d9,stroke:#b89b2e,color:#3a3212,stroke-width:0.01px;

    class A,B,D,E raw;
    class P2,P3,P4,P7 purple;
    class F,H proc;
    class T note;
Supply Chain Management & Distribution
Wintersemester 26/27
Thomas Kirschstein
Einführung & Organisatorisches
Organisatorisches
Dozent: Prof. Dr. Thomas Kirschstein (HS RheinMain + Fraunhofer)
Unterlagen + Materialien: https://github.com/tkirschstein/SCM_BDBM
Klausur: zusammen mit BBA-Kurs
Inverted classroom: - Studium der Inhalte vor Veranstaltung mit Folien + Reader - Ablauf Präsenz-Veranstaltungen: 1. Input: Vertiefung methodischer Komponenten -> Diskussion im Plenum 2. Rückfragen: Unklarheiten klären auf Basis von Rückfragen 3. Fallstudienlösungen: Studenten präsentieren Lösungen
Literatur
Applegate, David L., Robert E. Bixby, Vašek Chvátal, and William J. Cook. 2006. The Traveling Salesman Problem: A Computational Study. Princeton University Press.
Baumast, Annett, and Jens Pape, eds. 2013. Betriebliches Nachhaltigkeitsmanagement. UTB / Verlag Eugen Ulmer.
Bray, Robert L., and Haim Mendelson. 2012. “Information Transmission and the Bullwhip Effect: An Empirical Investigation.” Management Science 58 (5): 860–75. https://doi.org/10.1287/mnsc.1110.1467.
Cachon, Gérard, and Christian Terwiesch. 2024. Matching Supply with Demand: An Introduction to Operations Management. 5th ed. McGraw Hill.
Chen, Li, and Hau L. Lee. 2012. “Bullwhip Effect Measurement and Its Implications.” Operations Research 60 (4): 771–84.
Chopra, Sunil, and Peter Meindl. 2025. Supply Chain Management: Strategy, Planning, and Operation. 8th ed. Pearson.
Christopher, Martin. 2023. Logistics & Supply Chain Management. 6th ed. Pearson.
Clarke, G., and J. W. Wright. 1964. “Scheduling of Vehicles from a Central Depot to a Number of Delivery Points.” Operations Research 12 (4): 568–81.
Cooper, Leon. 1968. “Solutions of Generalized Locational Equilibrium Models.” Journal of Regional Science 8 (1): 1–18. https://doi.org/10.1111/j.1467-9787.1968.tb01319.x.
Council of Supply Chain Management Professionals (CSCMP). 2013. CSCMP Supply Chain Management Definitions and Glossary of Terms. https://cscmp.org/CSCMP/Educate/SCM_Definitions_and_Glossary_of_Terms.aspx.
Croes, G. A. 1958. “A Method for Solving Traveling-Salesman Problems.” Operations Research 6 (6): 791–812.
Dantzig, George, Ray Fulkerson, and Selmer Johnson. 1954. “Solution of a Large-Scale Traveling-Salesman Problem.” Journal of the Operations Research Society of America 2 (4): 393–410.
Daskin, Mark S. 2013. Network and Discrete Location: Models, Algorithms, and Applications. 2nd ed. Wiley.
de Koster, René, Tho Le-Duc, and Kees Jan Roodbergen. 2007. “Design and Control of Warehouse Order Picking: A Literature Review.” European Journal of Operational Research 182 (2): 481–501.
Dedrick, Jason. 2012. Who Profits from Innovation in Global Value Chains? iPhones and Windmills.
Dijkstra, Edsger W. 1959. “A Note on Two Problems in Connexion with Graphs.” Numerische Mathematik 1 (1): 269–71.
Domschke, Wolfgang. 2007. Logistik: Transport. Grundlagen, Lineare Transport- Und Umladeprobleme. 5th ed. Oldenbourg.
Domschke, Wolfgang, and Armin Scholl. 2010. Logistik: Rundreisen Und Touren. 5th ed. Oldenbourg.
Drezner, Zvi, and Horst W. Hamacher, eds. 2002. Facility Location: Applications and Theory. Springer.
Dyckhoff, Harald. 1998. Grundzüge Der Produktionswirtschaft: Einführung in Die Theorie Betrieblicher Wertschöpfung. 2nd ed. Springer.
Dyckhoff, Harald, Richard Lackes, and Joachim Reese, eds. 2008. Nachhaltige Unternehmensführung: Grundlagen Und Konzepte. Springer.
Günther, Edeltraud. 2008. Ökologieorientiertes Management: Um-(weltorientiert) Denken in Der BWL. Lucius & Lucius.
Günther, Hans-Otto, and Horst Tempelmeier. 2012. Produktion Und Logistik. 9th ed. Springer-Lehrbuch. Springer.
Hall, Randolph W. 1993. “Distance Approximations for Routing Manual Pickers in a Warehouse.” IIE Transactions 25 (4): 76–87.
Hauff, Volker, ed. 1987. Unsere Gemeinsame Zukunft: Der Brundtland-Bericht Der Weltkommission für Umwelt Und Entwicklung. Eggenkamp.
Heskett, James L. 1963. “Cube-Per-Order Index – a Key to Warehouse Stock Location.” Transportation and Distribution Management 3: 27–31.
Hitchcock, Frank L. 1941. “The Distribution of a Product from Several Sources to Numerous Localities.” Journal of Mathematics and Physics 20 (1–4): 224–30.
Hugos, Michael H. 2018. Essentials of Supply Chain Management. 4th ed. Wiley.
ISO. 2023. ISO 14083:2023 – Greenhouse Gases – Quantification and Reporting of Greenhouse Gas Emissions Arising from Transport Chain Operations. ISO, Genf.
Kik, D. 2022. Zur Modellbasierten Entscheidungsunterstützung von Unternehmen in Der Regionalen Standortplanung Und -Entwicklung. Springer Fachmedien Wiesbaden GmbH.
Kummer, Sebastian, Oskar Grün, and Werner Jammernegg. 2018. Grundzüge Der Beschaffung, Produktion Und Logistik. 4th ed. Pearson Deutschland GmbH.
Lahner, Jörg. 2020. “Regionalökonomie Und Standortfaktoren in Der Wirtschaftsförderung.” In Handbuch Innovative Wirtschaftsförderung, edited by Jürgen Stember, Matthias Vogelgesang, Philip Pongratz, and Alexander Fink. Springer Gabler. https://doi.org/10.1007/978-3-658-21404-3_31.
Miller, C. E., A. W. Tucker, and R. A. Zemlin. 1960. “Integer Programming Formulation of Traveling Salesman Problems.” Journal of the ACM 7 (4): 326–29.
Murray, Chase C., and Amanda G. Chu. 2015. “The Flying Sidekick Traveling Salesman Problem: Optimization of Drone-Assisted Parcel Delivery.” Transportation Research Part C: Emerging Technologies 54: 86–109.
Petersen, Charles G., and Roger W. Schmenner. 1999. “An Evaluation of Routing and Volume-Based Storage Policies in an Order Picking Operation.” Decision Sciences 30 (2): 481–501.
Pfohl, Hans-Christian. 2018. Logistiksysteme: Betriebswirtschaftliche Grundlagen. 9th ed. Springer Vieweg.
Ratliff, H. Donald, and Arnon S. Rosenthal. 1983. “Order-Picking in a Rectangular Warehouse: A Solvable Case of the Traveling Salesman Problem.” Operations Research 31 (3): 507–21.
Reinfeld, Nyles V., and William R. Vogel. 1958. Mathematical Programming. Prentice-Hall.
Schneider, Michael, Andreas Stenger, and Dominik Goeke. 2014. “The Electric Vehicle-Routing Problem with Time Windows and Recharging Stations.” Transportation Science 48 (4): 500–520.
SIHK zu Hagen. 2026. LKW-Maut in Deutschland: Änderungen Zum 1. Januar 2026. Https://www.ihk.de/hagen/servicemarken/branchen/verkehr/gueterverkehr/aenderungen-der-lkw-maut-in-deutschland-6059030.
Silver, Edward A., David F. Pyke, and Douglas J. Thomas. 2017. Inventory and Production Management in Supply Chains. 4th ed. CRC Press.
Smart Freight Centre. 2023. Global Logistics Emissions Council Framework for Logistics Emissions Accounting and Reporting, Version 3.0. Smart Freight Centre, Amsterdam.
Sople, Vinod V. 2011. Supply Chain Management: Text and Cases. Pearson Education.
Stadtler, Hartmut. 2000. “Supply Chain Management: An Overview.” In Supply Chain Management and Advanced Planning: Concepts, Models, Software, and Case Studies, edited by Hartmut Stadtler and Christoph Kilger. Springer.
Stindt, Dennis. 2017. “A Generic Planning Approach for Sustainable Supply Chain Management-How to Integrate Concepts and Methods to Address the Issues of Sustainability?” Journal of Cleaner Production 153: 146–63.
ten Hompel, Michael, and Thorsten Schmidt. 2010. Warehouse Management: Organisation Und Steuerung von Lager- Und Kommissioniersystemen. 4th ed. Springer.
Thonemann, Ulrich W. 2023. Operations Management. 4th ed. Pearson.
Toll Collect GmbH. 2024. Mautsätze Pro Kilometer Seit 1. Juli 2024. Https://www.toll-collect.de/de/toll_collect/bezahlen/maut_tarife/p1745_mauttarife_07_2024.html.
Toth, Paolo, and Daniele Vigo, eds. 2014. Vehicle Routing: Problems, Methods, and Applications. 2nd ed. SIAM.
Tripp, Christoph. 2024. Distributions- Und Handelslogistik. 3rd ed. Springer Gabler.
Umweltbundesamt. 2024. Emissionsdaten: Vergleich Der Durchschnittlichen Emissionen Einzelner Verkehrsmittel Im Güterverkehr. Https://www.umweltbundesamt.de/themen/verkehr/emissionsdaten.
Umweltbundesamt. 2025. Entwicklung Der Spezifischen Treibhausgas-Emissionen Des Deutschen Strommix in Den Jahren 1990–2024. Climate Change 13/2025. Umweltbundesamt.
Werner, Hartmut. 2020. Supply Chain Management: Grundlagen, Strategien, Instrumente Und Controlling. 7th ed. Springer Gabler. https://doi.org/10.1007/978-3-658-32429-2.
Yao, Yuliang, Yongrui Duan, and Jiazhen Huo. 2020. “On Empirically Estimating Bullwhip Effects: Measurement, Aggregation, and Impact.” Journal of Operations Management 67 (1): 5–30. https://doi.org/10.1002/joom.1090.
Aufbau der Vorlesung
- Grundlagen des Supply Chain Managements
- Aufgaben, Begriffe und Konzepte
- Wertschöpfung, strategische Fertigung & Strategic Fit
- Ziele, Zielkonflikte & Logistikkosten
- Distributionsstrukturen & -kanäle
- Strategische Gestaltung von Supply Chains
- Qualitative & kontinuierliche Standortplanung
- Diskrete Netzwerkplanung
- Transportplanung
- Unsicherheits- und Risikomanagement in Supply Chains
- Kapazitäts- & Lagerbestandspooling
- Newsvendor-Modell
- Bullwhip-Effekt
- Distributionslogistik
- Lagerplanung & Kommissionierung
- Transportmittel & Antriebe
- Operative Distributionsplanung
- Kürzeste Wege
- Tourenplanung
Grundlagen des Supply Chain Managements
Grundlagen des Supply Chain Managements
- Aufgaben, Begriffe und Konzepte
- Ziele & Zielkonflikte
- Kosten & Management
- Distributionsstrukturen
Lernziele
Nach dieser Einheit können Sie …
- zentrale Begriffe, Akteure und Flüsse einer Supply Chain erläutern,
- Supply Chain Management gegenüber Logistik und Beschaffung abgrenzen,
- strategische, taktische und operative Entscheidungen in Supply Chains unterscheiden,
- die Bedeutung von Koordination für Wertschöpfung und Wettbewerbsfähigkeit beurteilen.
Literatur zur Vertiefung
- SCM-Grundlagen und Entscheidungsebenen: Kapitel 1–3 in (Chopra and Meindl 2025).
- Strategien, Instrumente und Controlling im deutschsprachigen Kontext: Kapitel 1–3 in (Werner 2020).
- Fallorientierte Einführung in Supply-Chain-Strukturen: Kapitel 1–3 in (Sople 2011).
Supply chains in History
Cheops and building supply chains
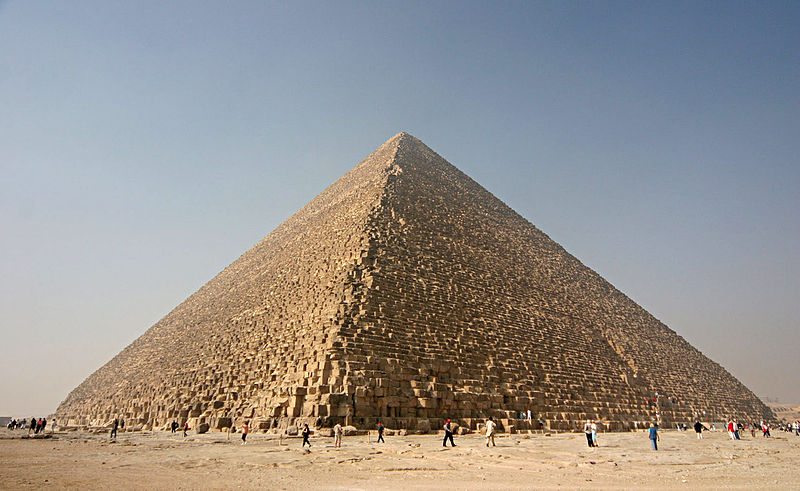
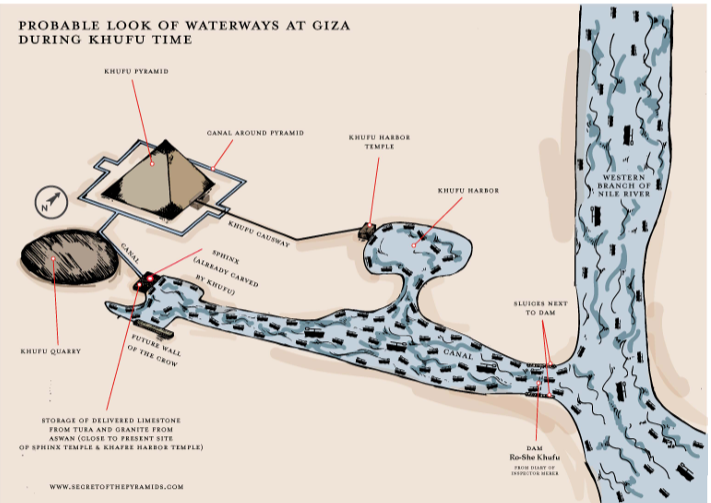
- Cheops pyramide building started about 2620 BC, ancient height : 147 m
- 2.3 million stone blocks, avg. 2.5 t each
- Required coordinated transport, tool inventory, and mass catering about 100,000 workers
Supply chains in History
Hannibals invasion of Italy
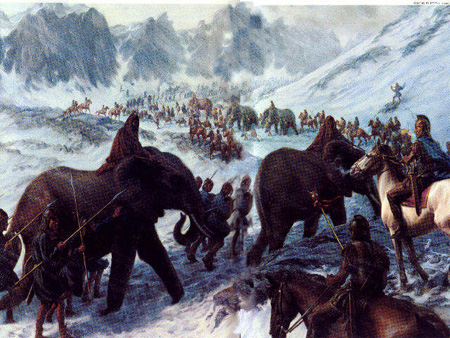
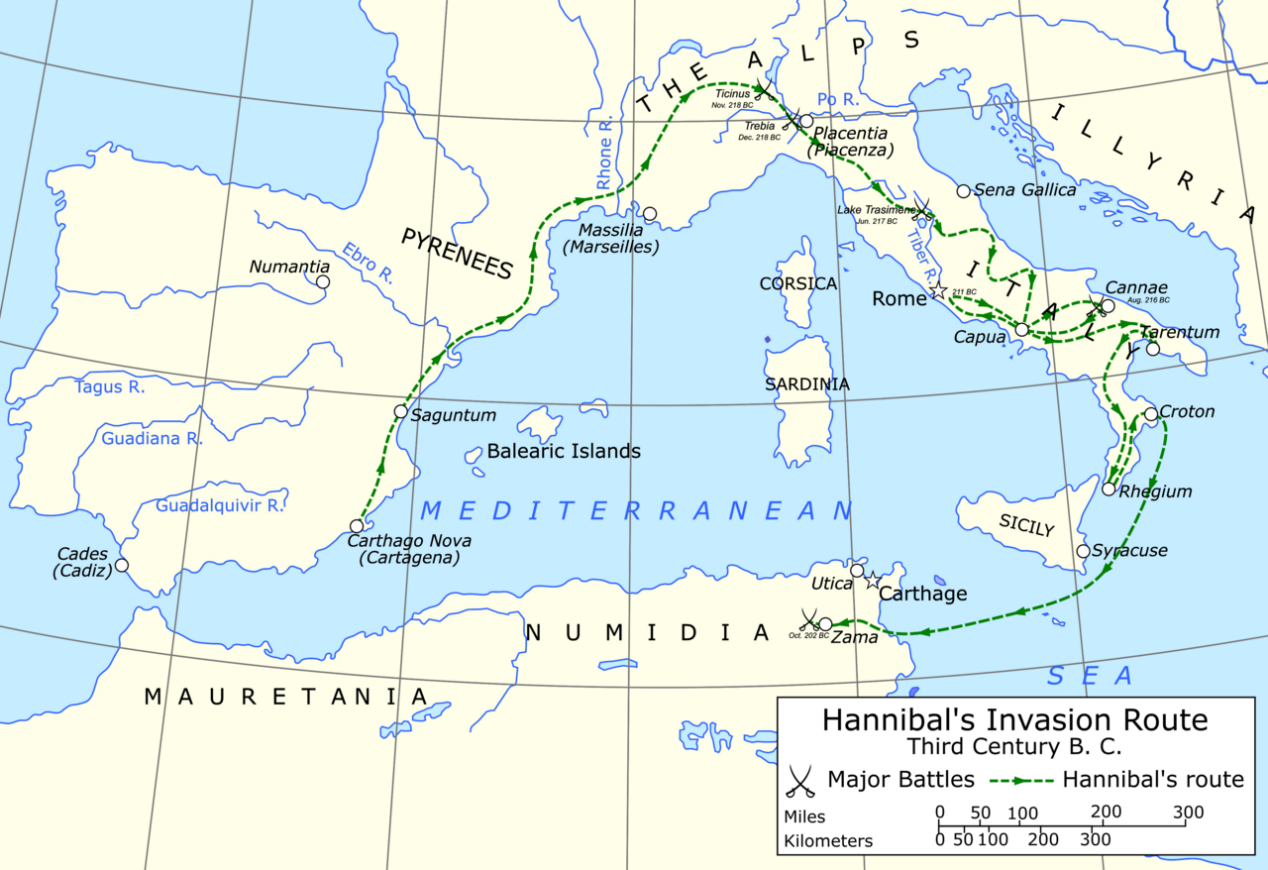
- Invasion from Spain to Italy in 2nd Punic war
- 37 war elephants + 40,000 troops (incl. large cavalry)
- Supply of troops and beasts need to be realized in hostile territory
Supply chains in History
Toga praetexta: Rohstoffe, Purpur und Absatz
Herstellungsprozess

| Produkt | Preis |
|---|---|
| Einfache weiße Toga | 12 Sesterzen |
| Bessere weiße Toga | 60 Sesterzen |
| Toga praetexta | 800 Sesterzen |
\(\rightarrow\) Jahressold einfacher Soldat: 1000 Sesterzen
Rohstoff- und Absatzkarte
Supply chains in History
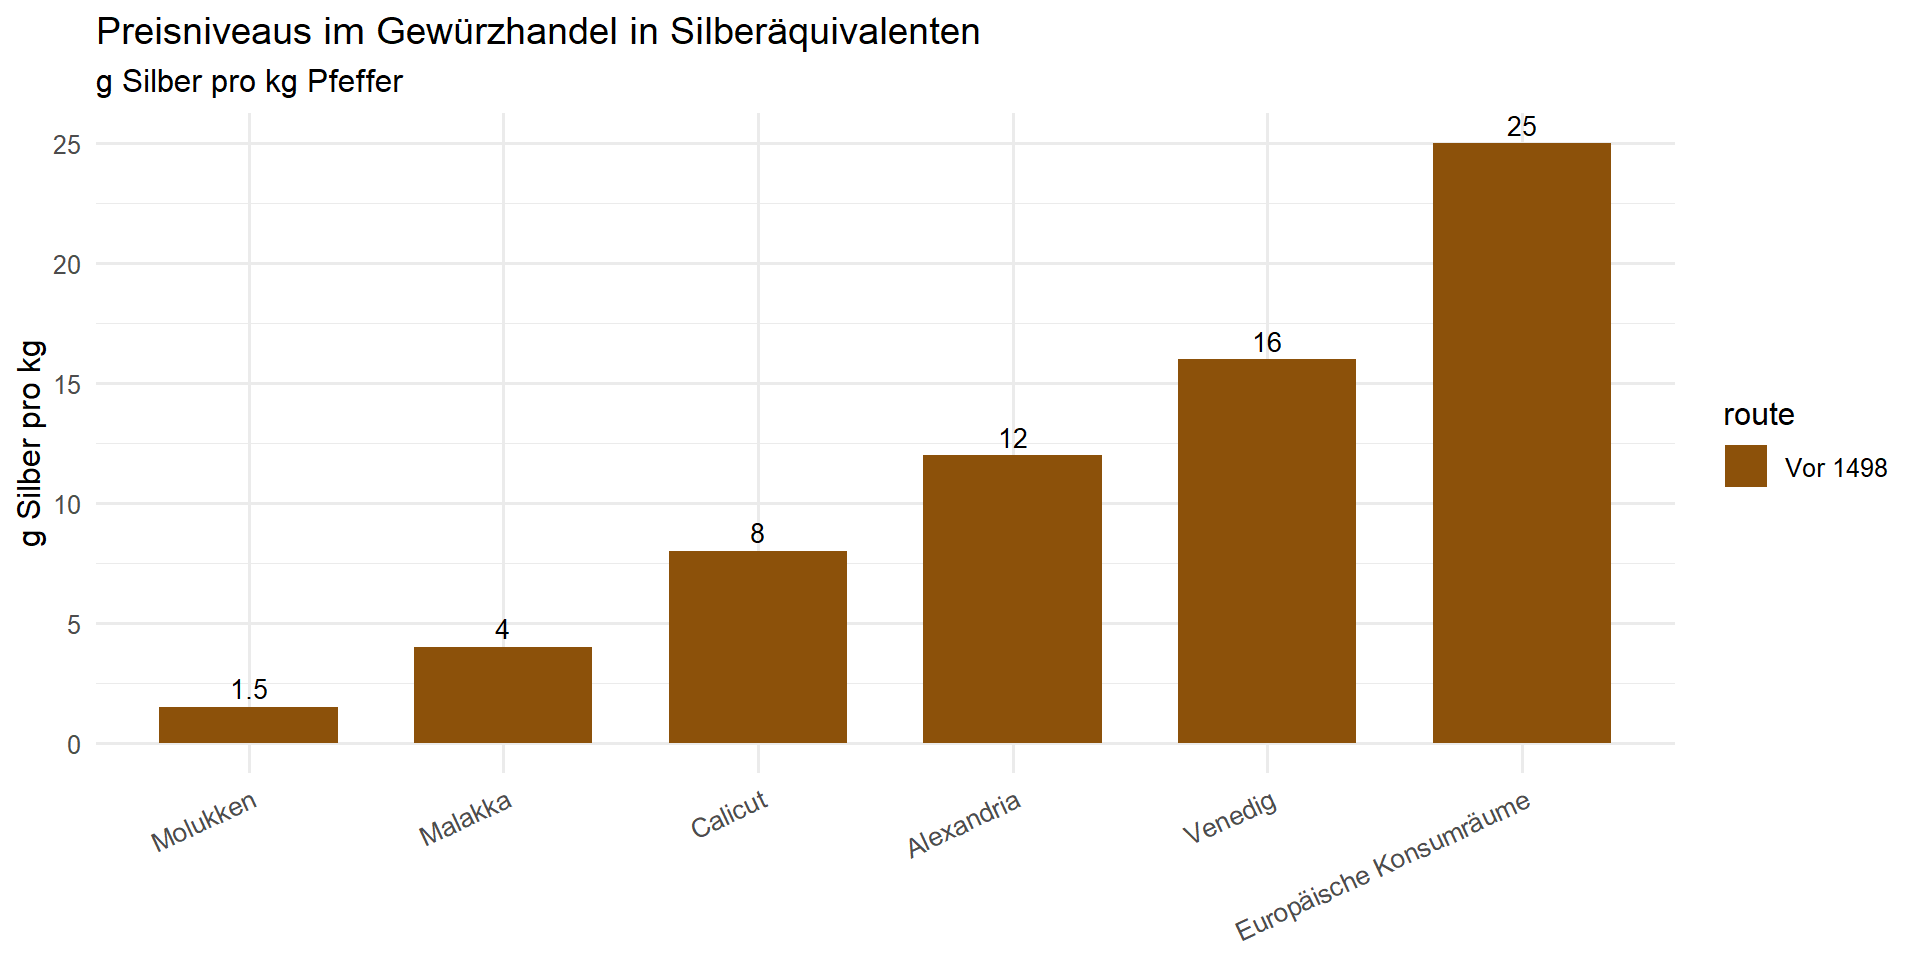
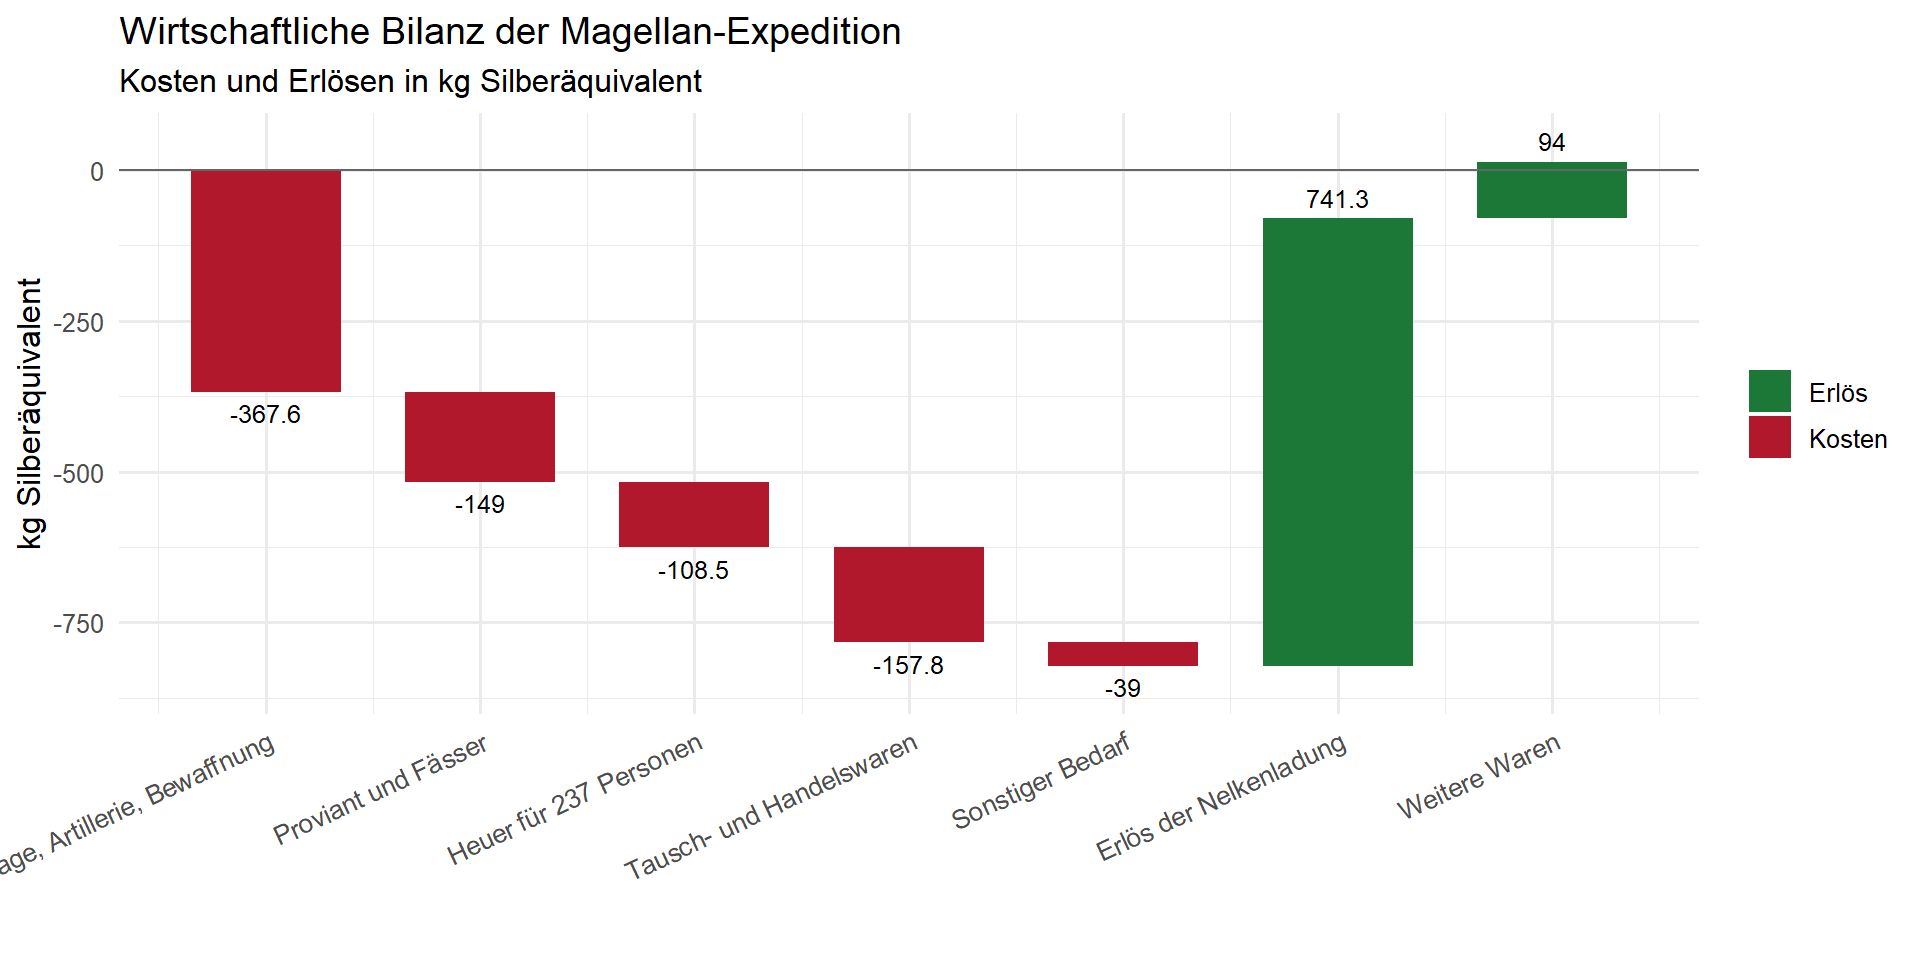
Gewürzhandel im 15. Jahrhundert
- Magellan-Expedition der spanischen Krone von 1519 - 1522
- Ziel: westlicher Seeweg zu Molukken
- Start: 5 Schiffe / 260 Mann Besatzung
- Ende: 1 Schiff / 18 Mann Besatzung
Wozu Supply Chain Management?
Kundennutzen entlang der Supply Chain
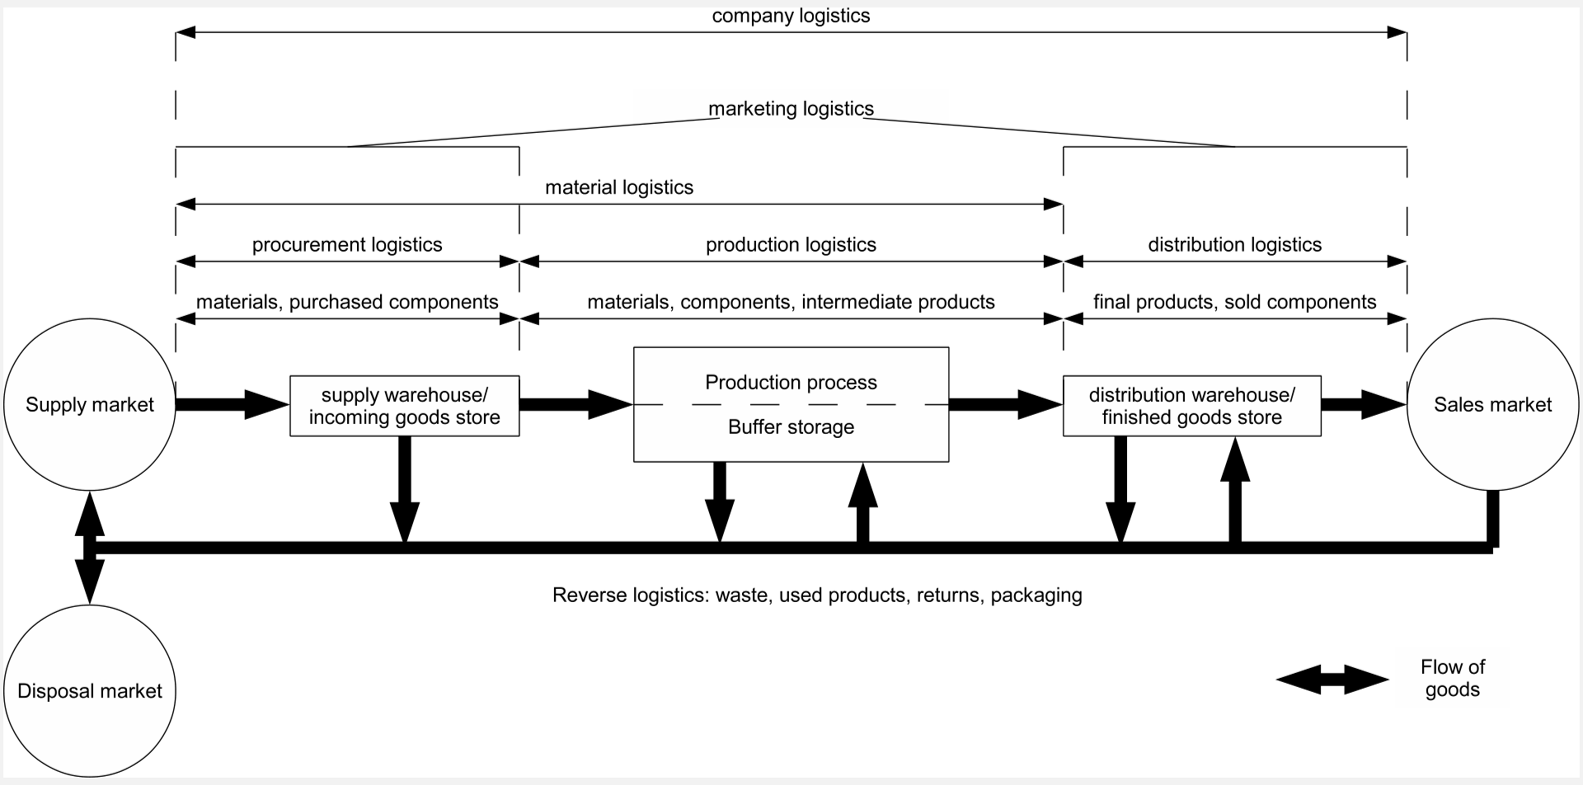
Logistiksysteme im Unternehmen
Supply Chain Strukturen
Netzwerkgedanke & Grundparadigma
SCM-Gewinn = Kundenumsatz – Gesamtkosten aller Prozesse/Partner = Summe der indi. Gewinne
\(\rightarrow\) Optimierung der indiv . Gewinne führt i.d.R. nicht zur Optimierung des SCM-Gewinns !
Transformation
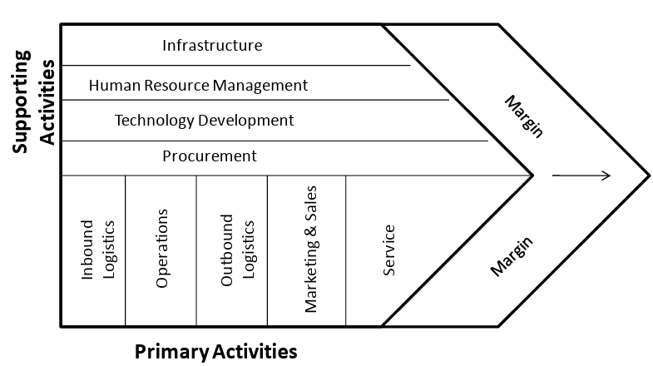
Wertschöpfung in der Supply Chain
Porter’s value chain
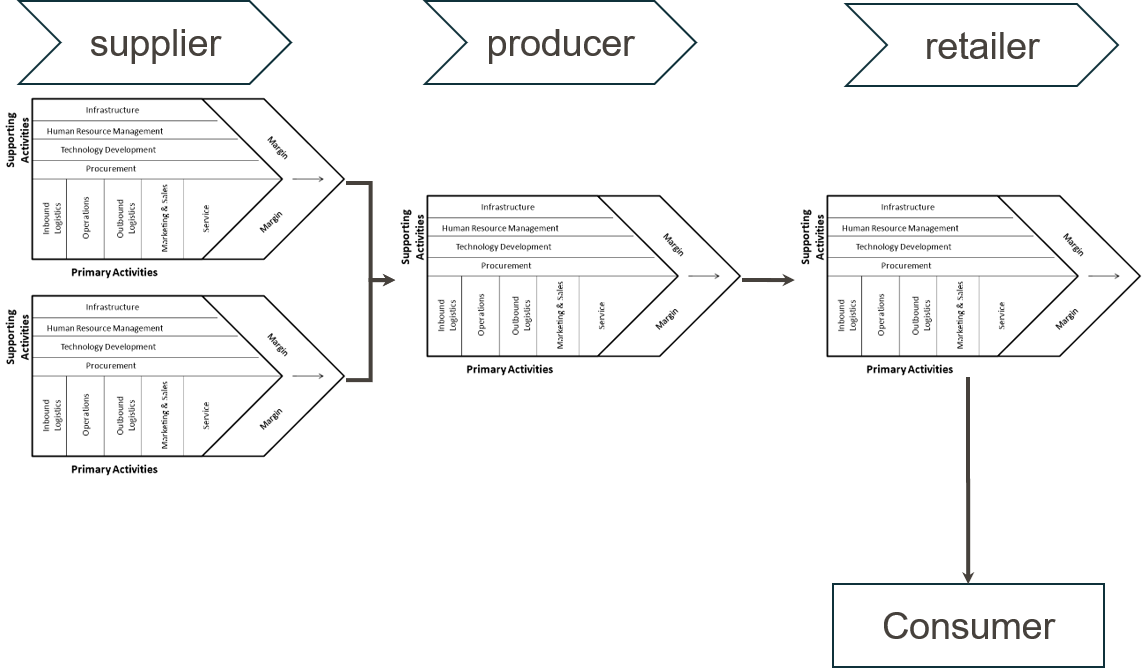
Definitionen des SCM
Vielfalt & gemeinsamer Kern
(Stadtler 2000, S. 9): “Supply Chain Management ist die Aufgabe, Organisationseinheiten entlang der Supply Chain zu integrieren , den Material-, Informations- und Geldfluss zu koordinieren und die Wettbewerbsfähigkeit der gesamten Supply Chain zu verbessern, um Kundenbedarfe zu erfüllen.”
(Hugos 2018): „Supply Chain Management is coordination of production , inventory , location , transportation , and information among the participants in a supply chain to achieve the best mix of responsiveness and efficiency for the market being served .”
(Council of Supply Chain Management Professionals (CSCMP) 2013): „Supply chain management encompasses the planning and management of all activities involved in sourcing and procurement, conversion, and all logistics management activities. Importantly, it also includes coordination and collaboration with channel partners, which can be suppliers, intermediaries, third party service providers, and customers. In essence, supply chain management integrates supply and demand management within and across companies .”
Unternehmen und ihre Umwelt
Offenes Unternehmensmodell
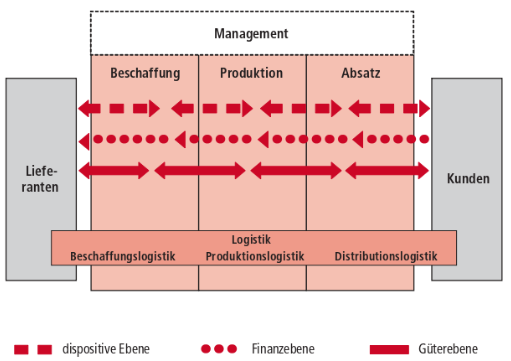
- Dispositive Ebene: behandelt den Informationsfluss im und zwischen Unternehmen, Planungsprozesse, Entscheiden und Kontrollieren (Management i.e.S.)
- Finanzebene: erfasst Geld- und Zahlungsströme innerhalb und außerhalb des Unternehmens
- Güterebene: erfasst die Bewegung und den Bestand physischer Güter (Roh-, Hilfs- und Betriebsstoffe) innerhalb und zwischen Unternehmen
Flüsse in Supply Chains
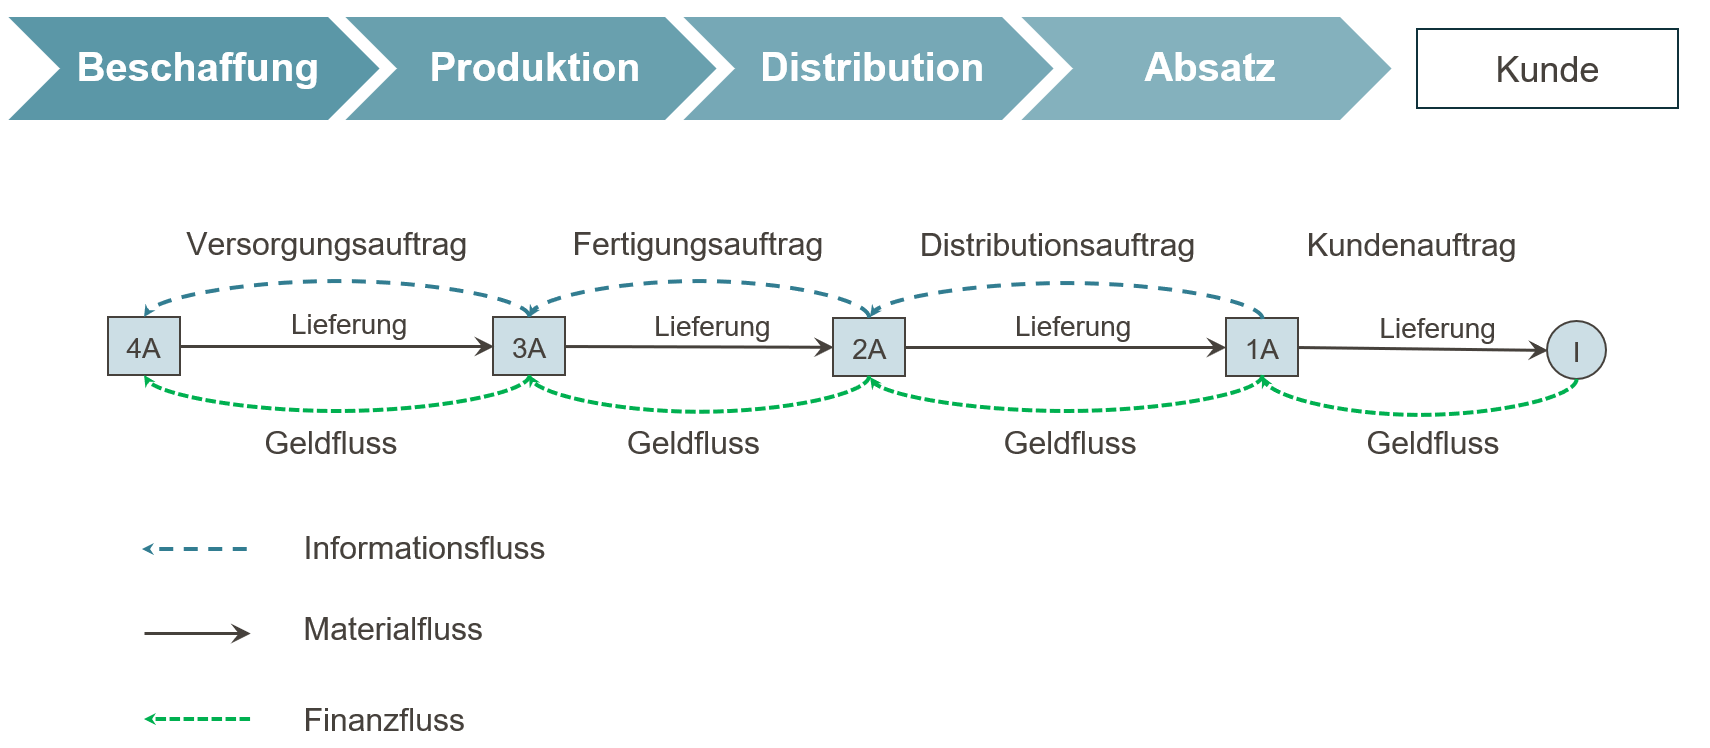
Supply Chain Strukturen
Fokale Supply Chain
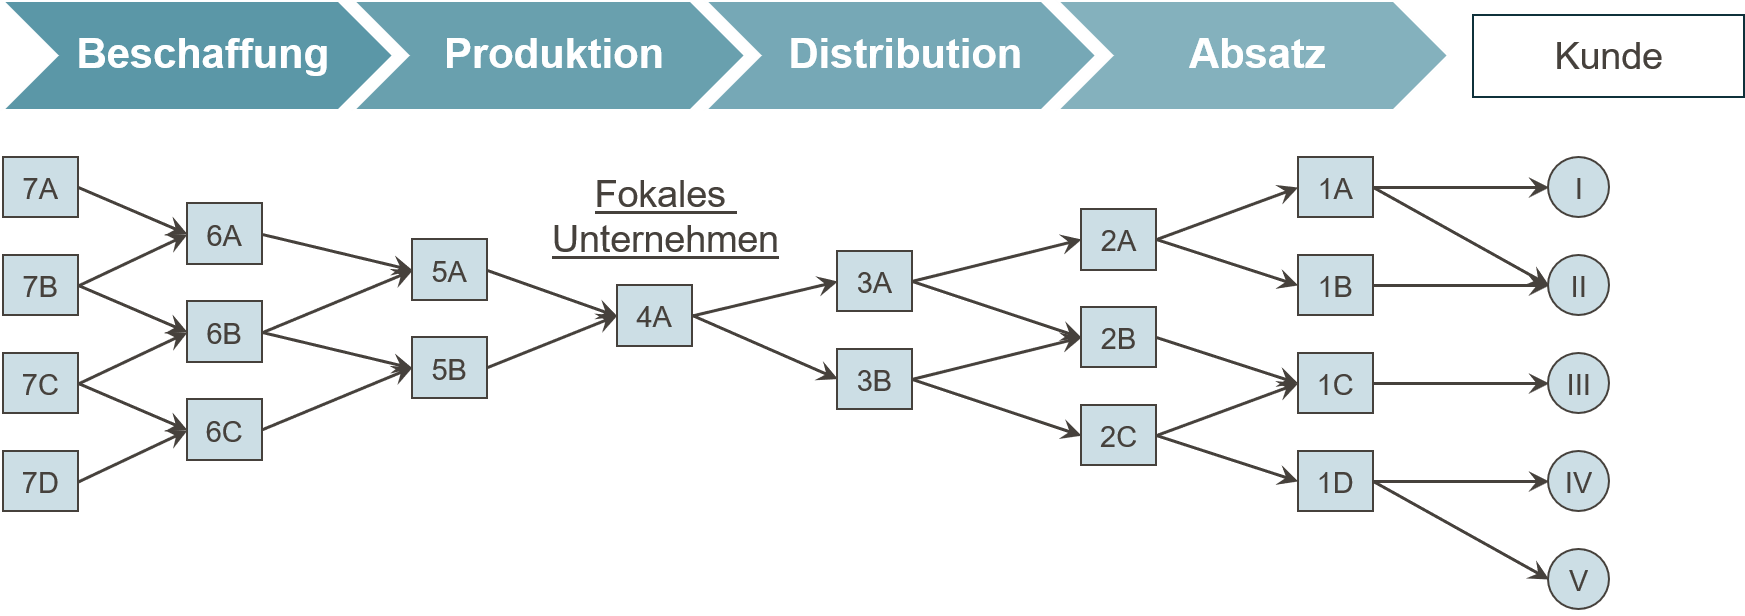
Charakteristiken:
- Fokales Unternehmen an der Engpassposition → „kontrolliert” das Netzwerk (Akteure und Struktur)
- Hohe Marktmacht → kontrolliert den Marktzugang
- Häufig Koordinator → legt Standards und strategische Ziele fest
- Beispiele: Automobilindustrie, Apple, …
Supply Chain Strukturen
Polyzentrische Supply Chains
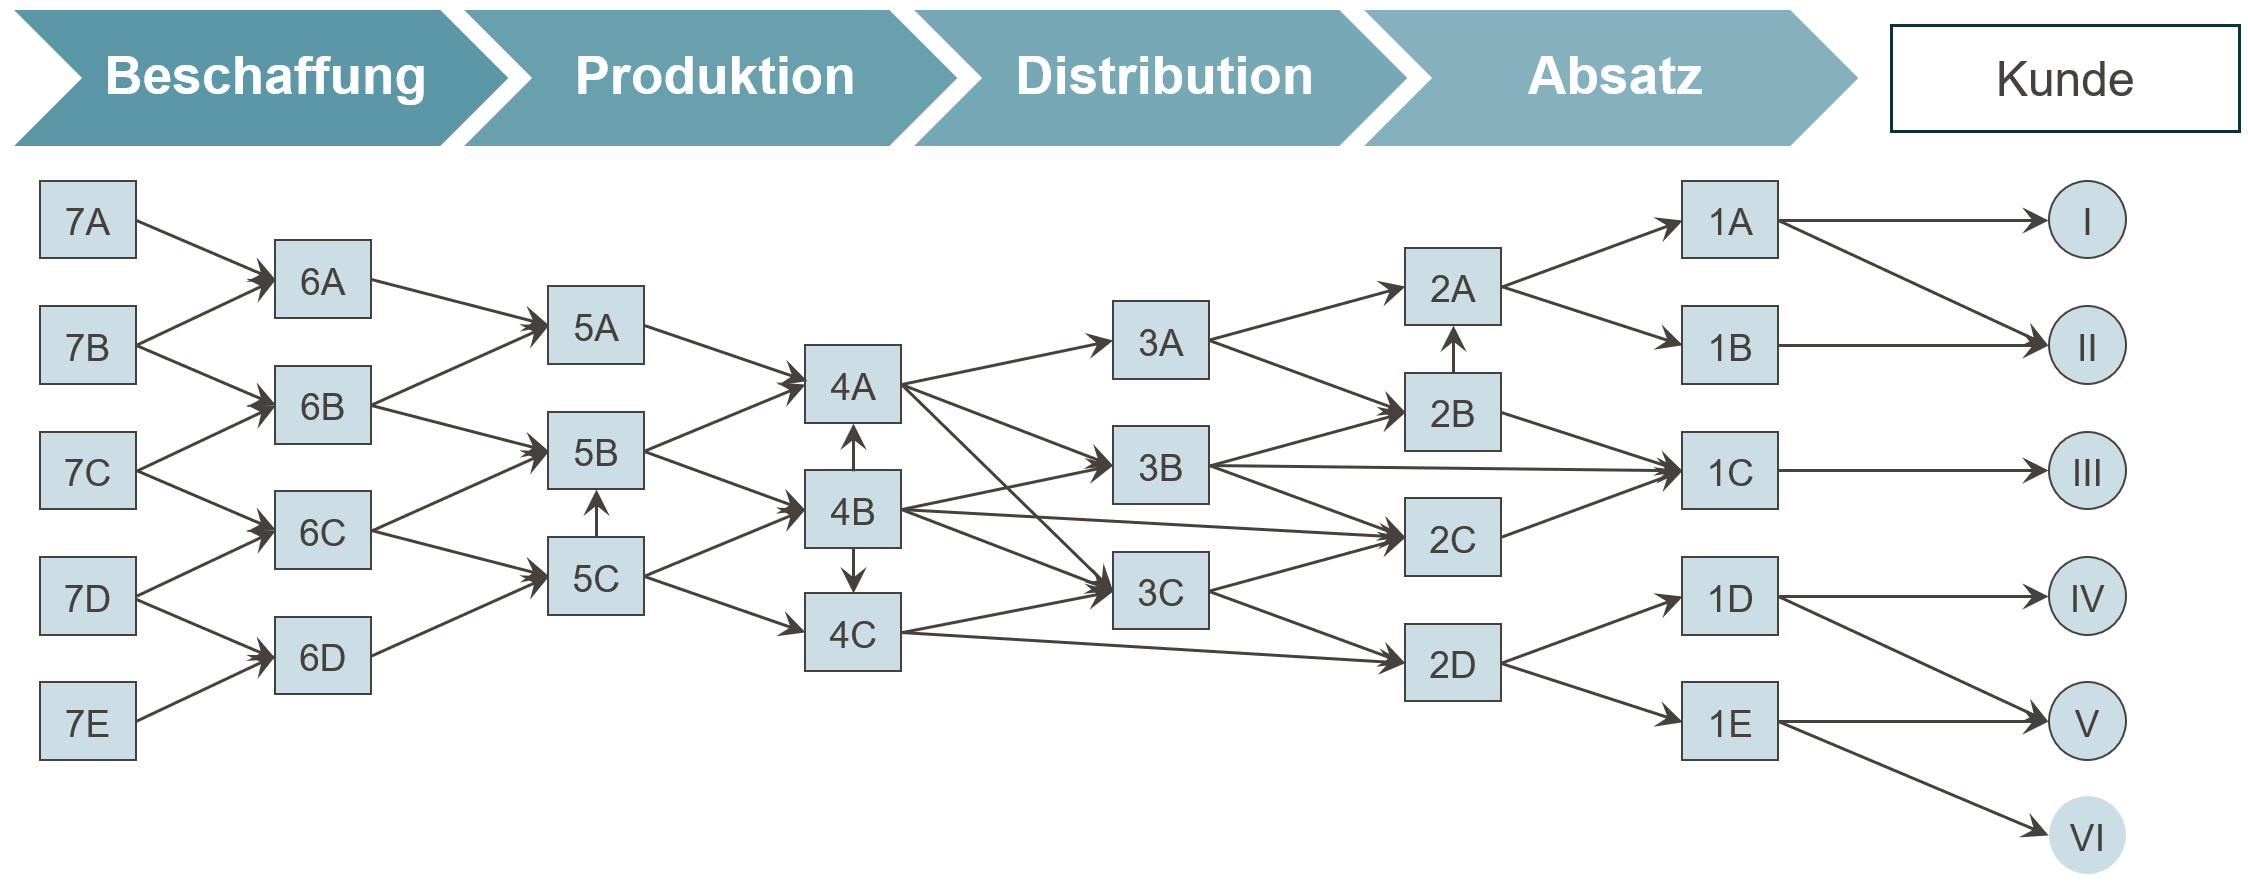
Charakteristiken:
- Verteilte und sich überschneidende Kompetenzen
- Spezialisierung und Kooperation
- Keine klare Standardisierung und eher egalitäre Verteilung der Marktmacht
- Beispiele: IKEA, Neste, Unilever, …
Beispiele Für Supply Chains
Aufgabe
Versuchen Sie die Struktur der Supply Chains insbesondere der Distributionsstruktur der folgenden Produkte zu beschreiben:
- Eine Flasche Coca-Cola (Glas, 0,3 l)
- T-Shirt von Patagonia
- Gravel-Bike Waldwiesel von Urwahn
- Rittersport Haselnuss
Beschreiben Sie die wesentlichen Produktionsschritte durch Angabe der verwendeten Rohstoffe, Materialien und Bauteile sowie den erzeugten (Zwischen-)Produkt(-en). Ergänzen Sie die Darstellung durch Angabe der logistischen Prozesse, die die Fertigungsstufen verbinden.
Ordnen Sie die einzelnen Prozessschritte (Produktion und Logistik) räumlich zu.
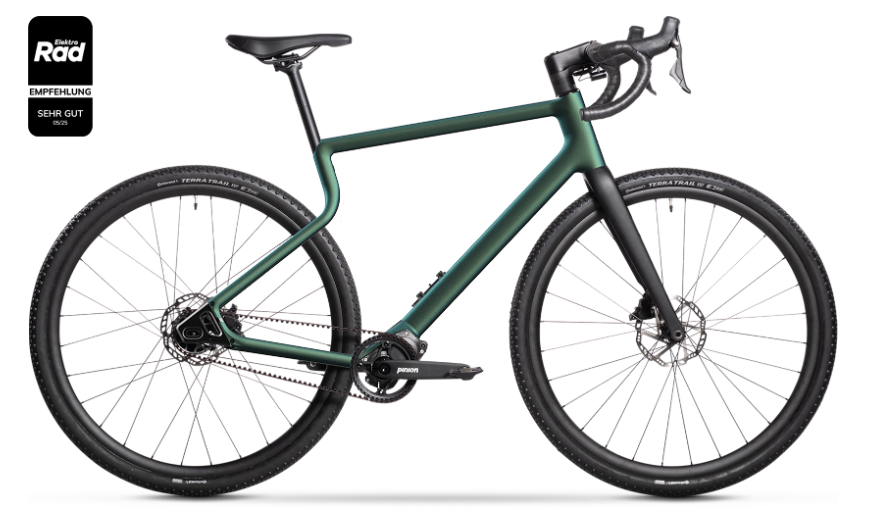
Grundlagen des SCM - Ziele & Zielkonflikte
Grundlagen des Supply Chain Managements
- Aufgaben, Begriffe und Konzepte
- Ziele & Zielkonflikte
- Kosten & Management
Lernziele
Nach dieser Einheit können Sie …
- Wertschöpfungsprozesse und die zentralen Treiber einer Supply Chain strukturieren,
- die Begriffe Reaktionsfähigkeit und Effizienz erläutern,
- die implizierte Unsicherheit eines Marktes und die Reaktionsfähigkeit einer Supply Chain gegenüberstellen,
- den Strategic Fit einer Supply-Chain-Konfiguration beurteilen.
Literatur zur Vertiefung
- Strategic Fit, Supply-Chain-Treiber und implizierte Unsicherheit: (Chopra and Meindl 2025, Kapitel 2–3).
- Abstimmung von Nachfrage und operativer Leistungsfähigkeit: (Cachon and Terwiesch 2024, Kapitel 1–3).
- Supply-Chain-Strategie und wertorientierte Logistik: (Christopher 2023, Kapitel 2–4).
Wertschöpfung als Prozess

Beschaffung ist der Prozess zum Einkauf und Bereit-stellung von Rohstoffen, Komponenten und Dienst-leistungen von externen Partnern, die für die Produktion von Waren und Dienstleistungen erforderlich sind.
Produktion ist ein zielgerichteter Prozess der Kombination von Gütern und Dienstleistungen in höherwertige Produkte.
Distribution umfasst die physische Verteilung von Waren vom Hersteller zum Endkunden und umfasst Lagerhaltung, Transport und Logistik von Fertigprodukten.
Absatz ist der Prozess des Verkaufs der Endprodukte an den Konsumenten oder Handelspartner.
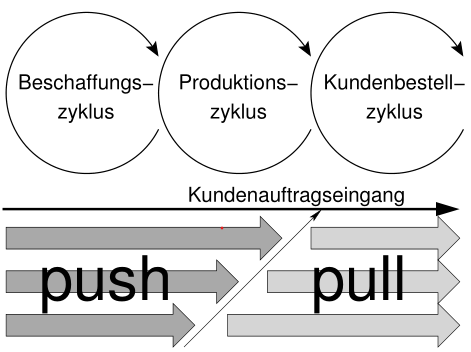 (Chopra and Meindl 2025, Kapitel 1.5)
Strategische Fertigung
Entkopplungspunkt & Fertigungsstrategien
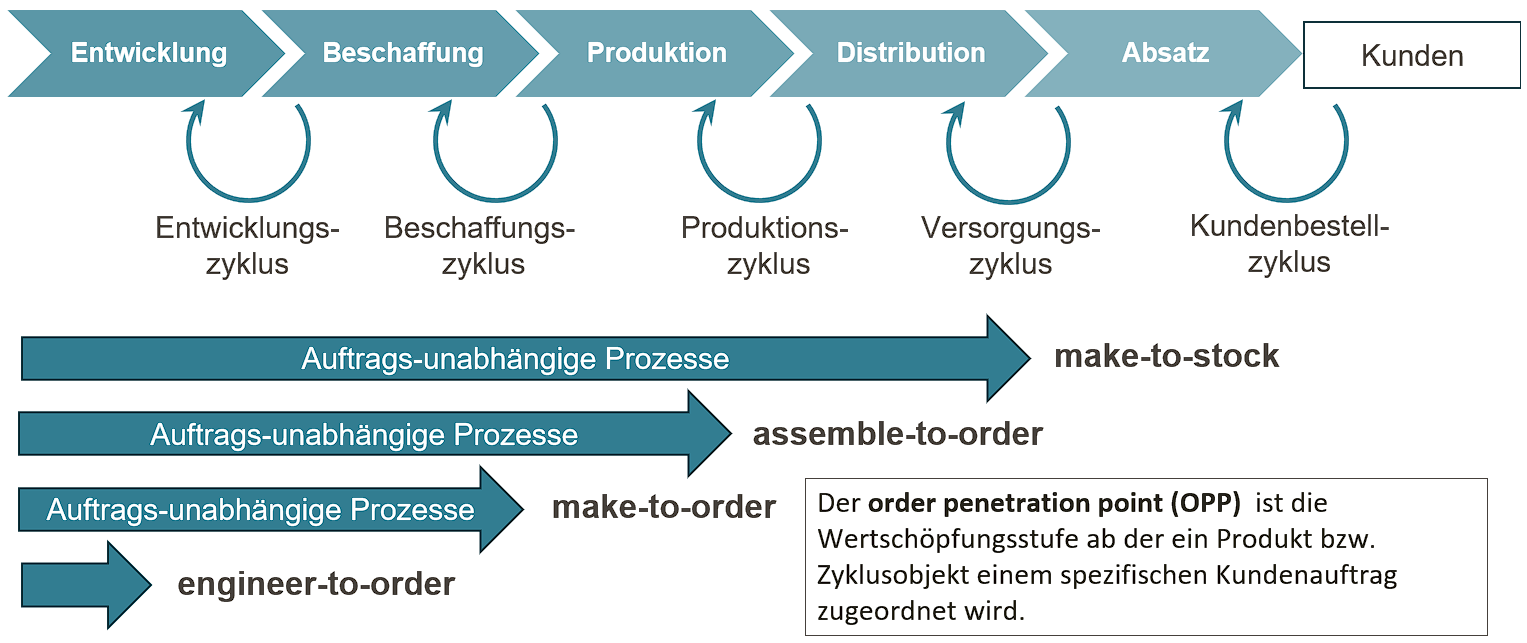
Strategische Fertigung
Denken in Zyklen
Kundenbestellzyklus: Verarbeitung von externen Kundenbedarfen
Distributions-/Versorgungszyklus: Umwandlung von Kundenbedarfen in interne Bedarfe an Fertigprodukten
Produktionszyklus: Umwandlung von internen Bedarfen in Produktions-bedarfe von Zwischenprodukten und Rohstoffen
Beschaffungszyklus: Gestaltung von Bestell-/Versorgungsprozessen für Rohstoffe und Dienstleistungen, die extern bezogen werden müssen
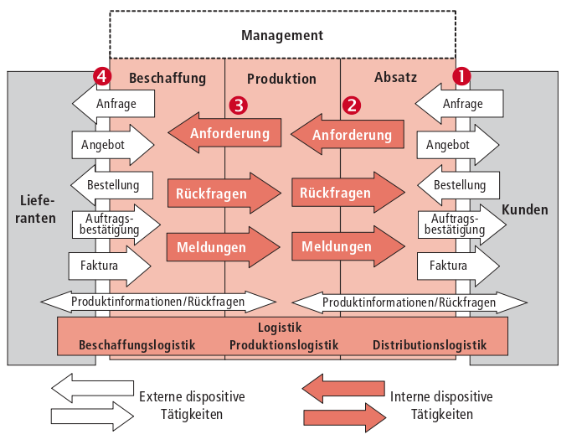
(Kummer et al. 2018, S. 45)
Strategische Fertigung
Entkopplung von Zyklen
Make-to-stock
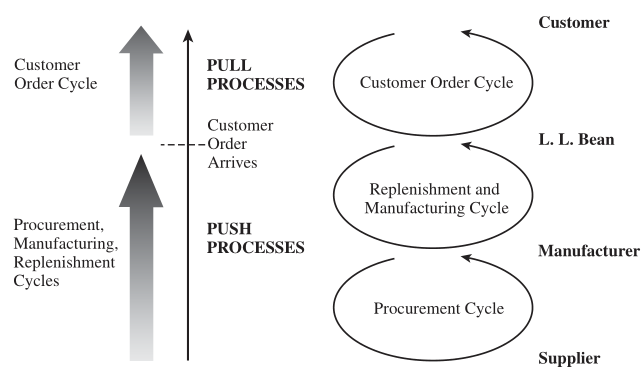
Beispiele: Lebensmitteleinzelhandel, Drogerien, …
Make-to-order
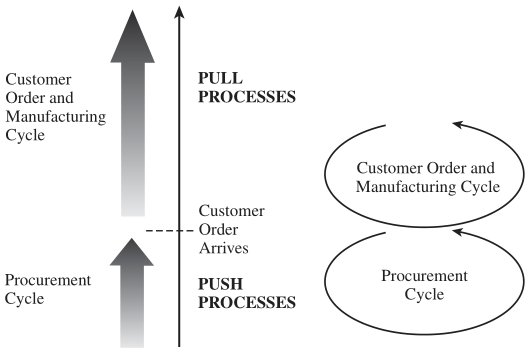
Beispiele: Gebäude, Flugzeuge, Gemälde
Strategische Ziele
Kundenzufriedenheit – Kundenerwartungen erfüllen
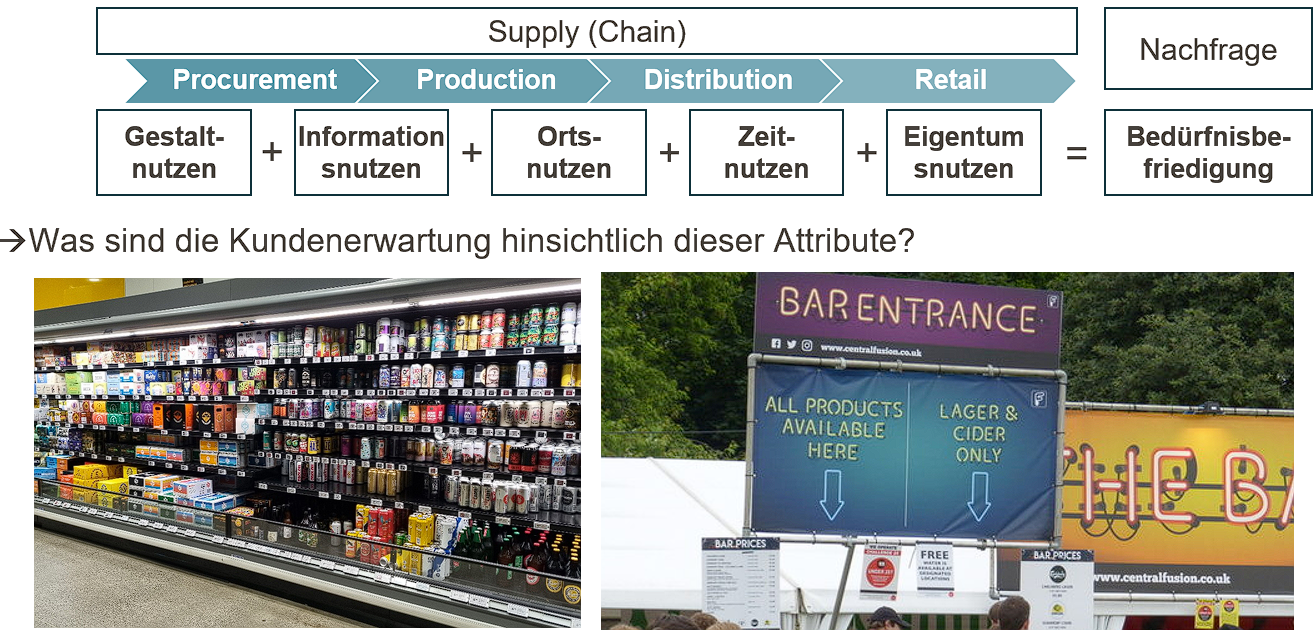
Strategische Ziele
Kundenzufriedenheit & Unsicherheit
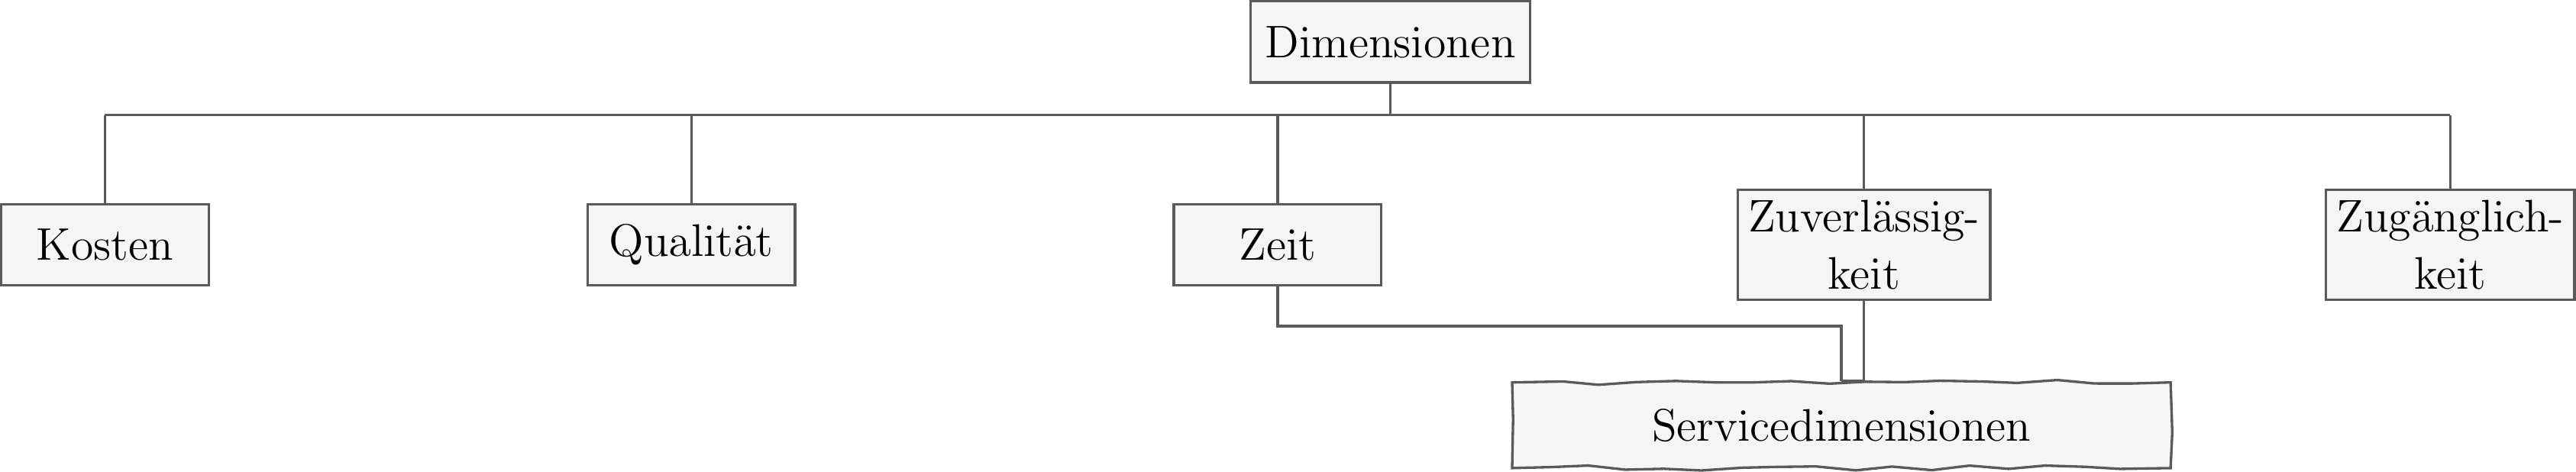
Kunden und Supply-Chain-Unsicherheit
- Nachfragemenge je Kundenauftrag
- Lieferzeit, die von Kunden akzeptiert wird
- Erwartete Produktvielfalt
- Erwartete Lieferbereitschaft
- Preis/Zahlungsbereitschaft
- Innovationsgrad der Produkte
Nachfrageunsicherheit
Unsicherheit der Nachfrage nach einem Produkt
Implizierte Nachfrageunsicherheit
Unsicherheit desjenigen Nachfragesegments, das durch die Supply Chain bedient werden soll basierend auf den definierten Nachfrageattributen
Umgang mit Unsicherheit
Kundenbedürfnisse & implizierte Unsicherheit
| Kundenbedürfnisse | Verursacht implizite Unsicherheit da … |
|---|---|
| (max.) Nachfragemengen steigen | Erhöhte Spannweite des Bedarfs größere Varianz / Schwankung der Nachfragemengen verursacht |
| Lieferzeit sinkt | Weniger Zeit bleibt um auf Nachfrageschwankungen zu reagieren |
| Anzahl angebotener Produkte erhöht | Nachfrage der einzelnen Produkte schwieriger zu prognostizieren |
| Lieferbereitschaftsgrad erhöht sich | Nachfragespitzen müssen nun abgefedert werden |
| Innovationsgrad erhöht sich | Nachfrage neuer Produkte in der Regel unbekannt oder schwer zu prognostizieren |
| Anzahl der Vertriebskanäle steigt | Nachfrage der einzelnen Vertriebskanäle schwieriger zu prognostizieren |
Umgang mit Unsicherheit
Rollen & Risikoallokation in Supply Chain
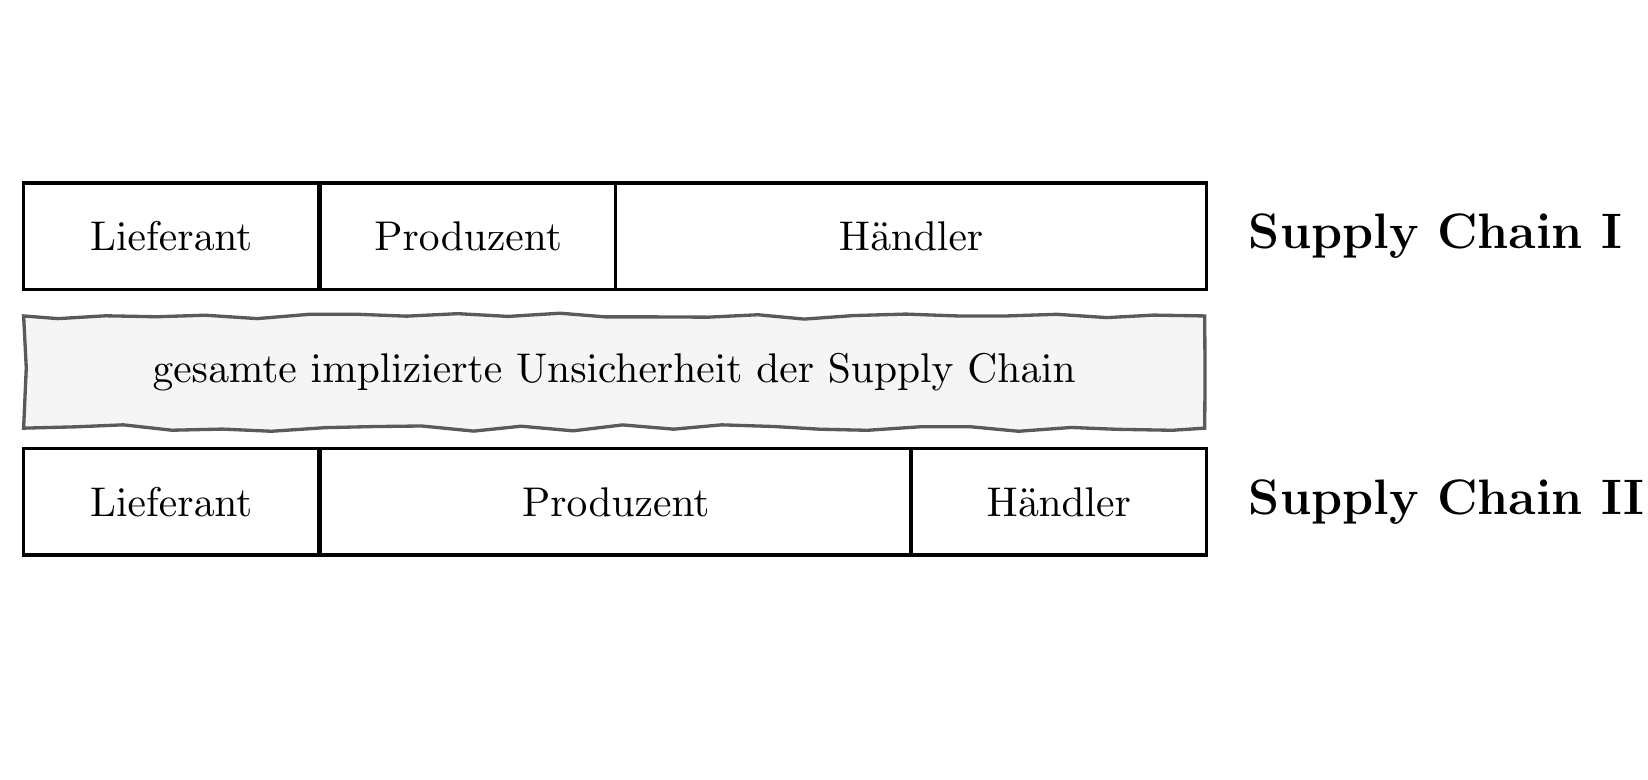
(Chopra and Meindl 2025, S. 57)
Umgang mit Unsicherheit
Reaktionsfähigkeit / responsiveness
Reaktionsfähigkeit
ist die Fähigkeit einer Supply Chain mit Nachfrageunsicherheit umzugehen
Reaktionsfähigkiet kann u.a. erreicht werden durch:
- Hohe Lagerbestände
- Kurze Reaktions -/ Lieferzeiten
- Hohe Produktvielfalt
- Kurze Entwicklungszyklen neuer Produkte
- Hohe Bereitschaftsgrade
- Reduktion von Versorgungsunsicherheiten
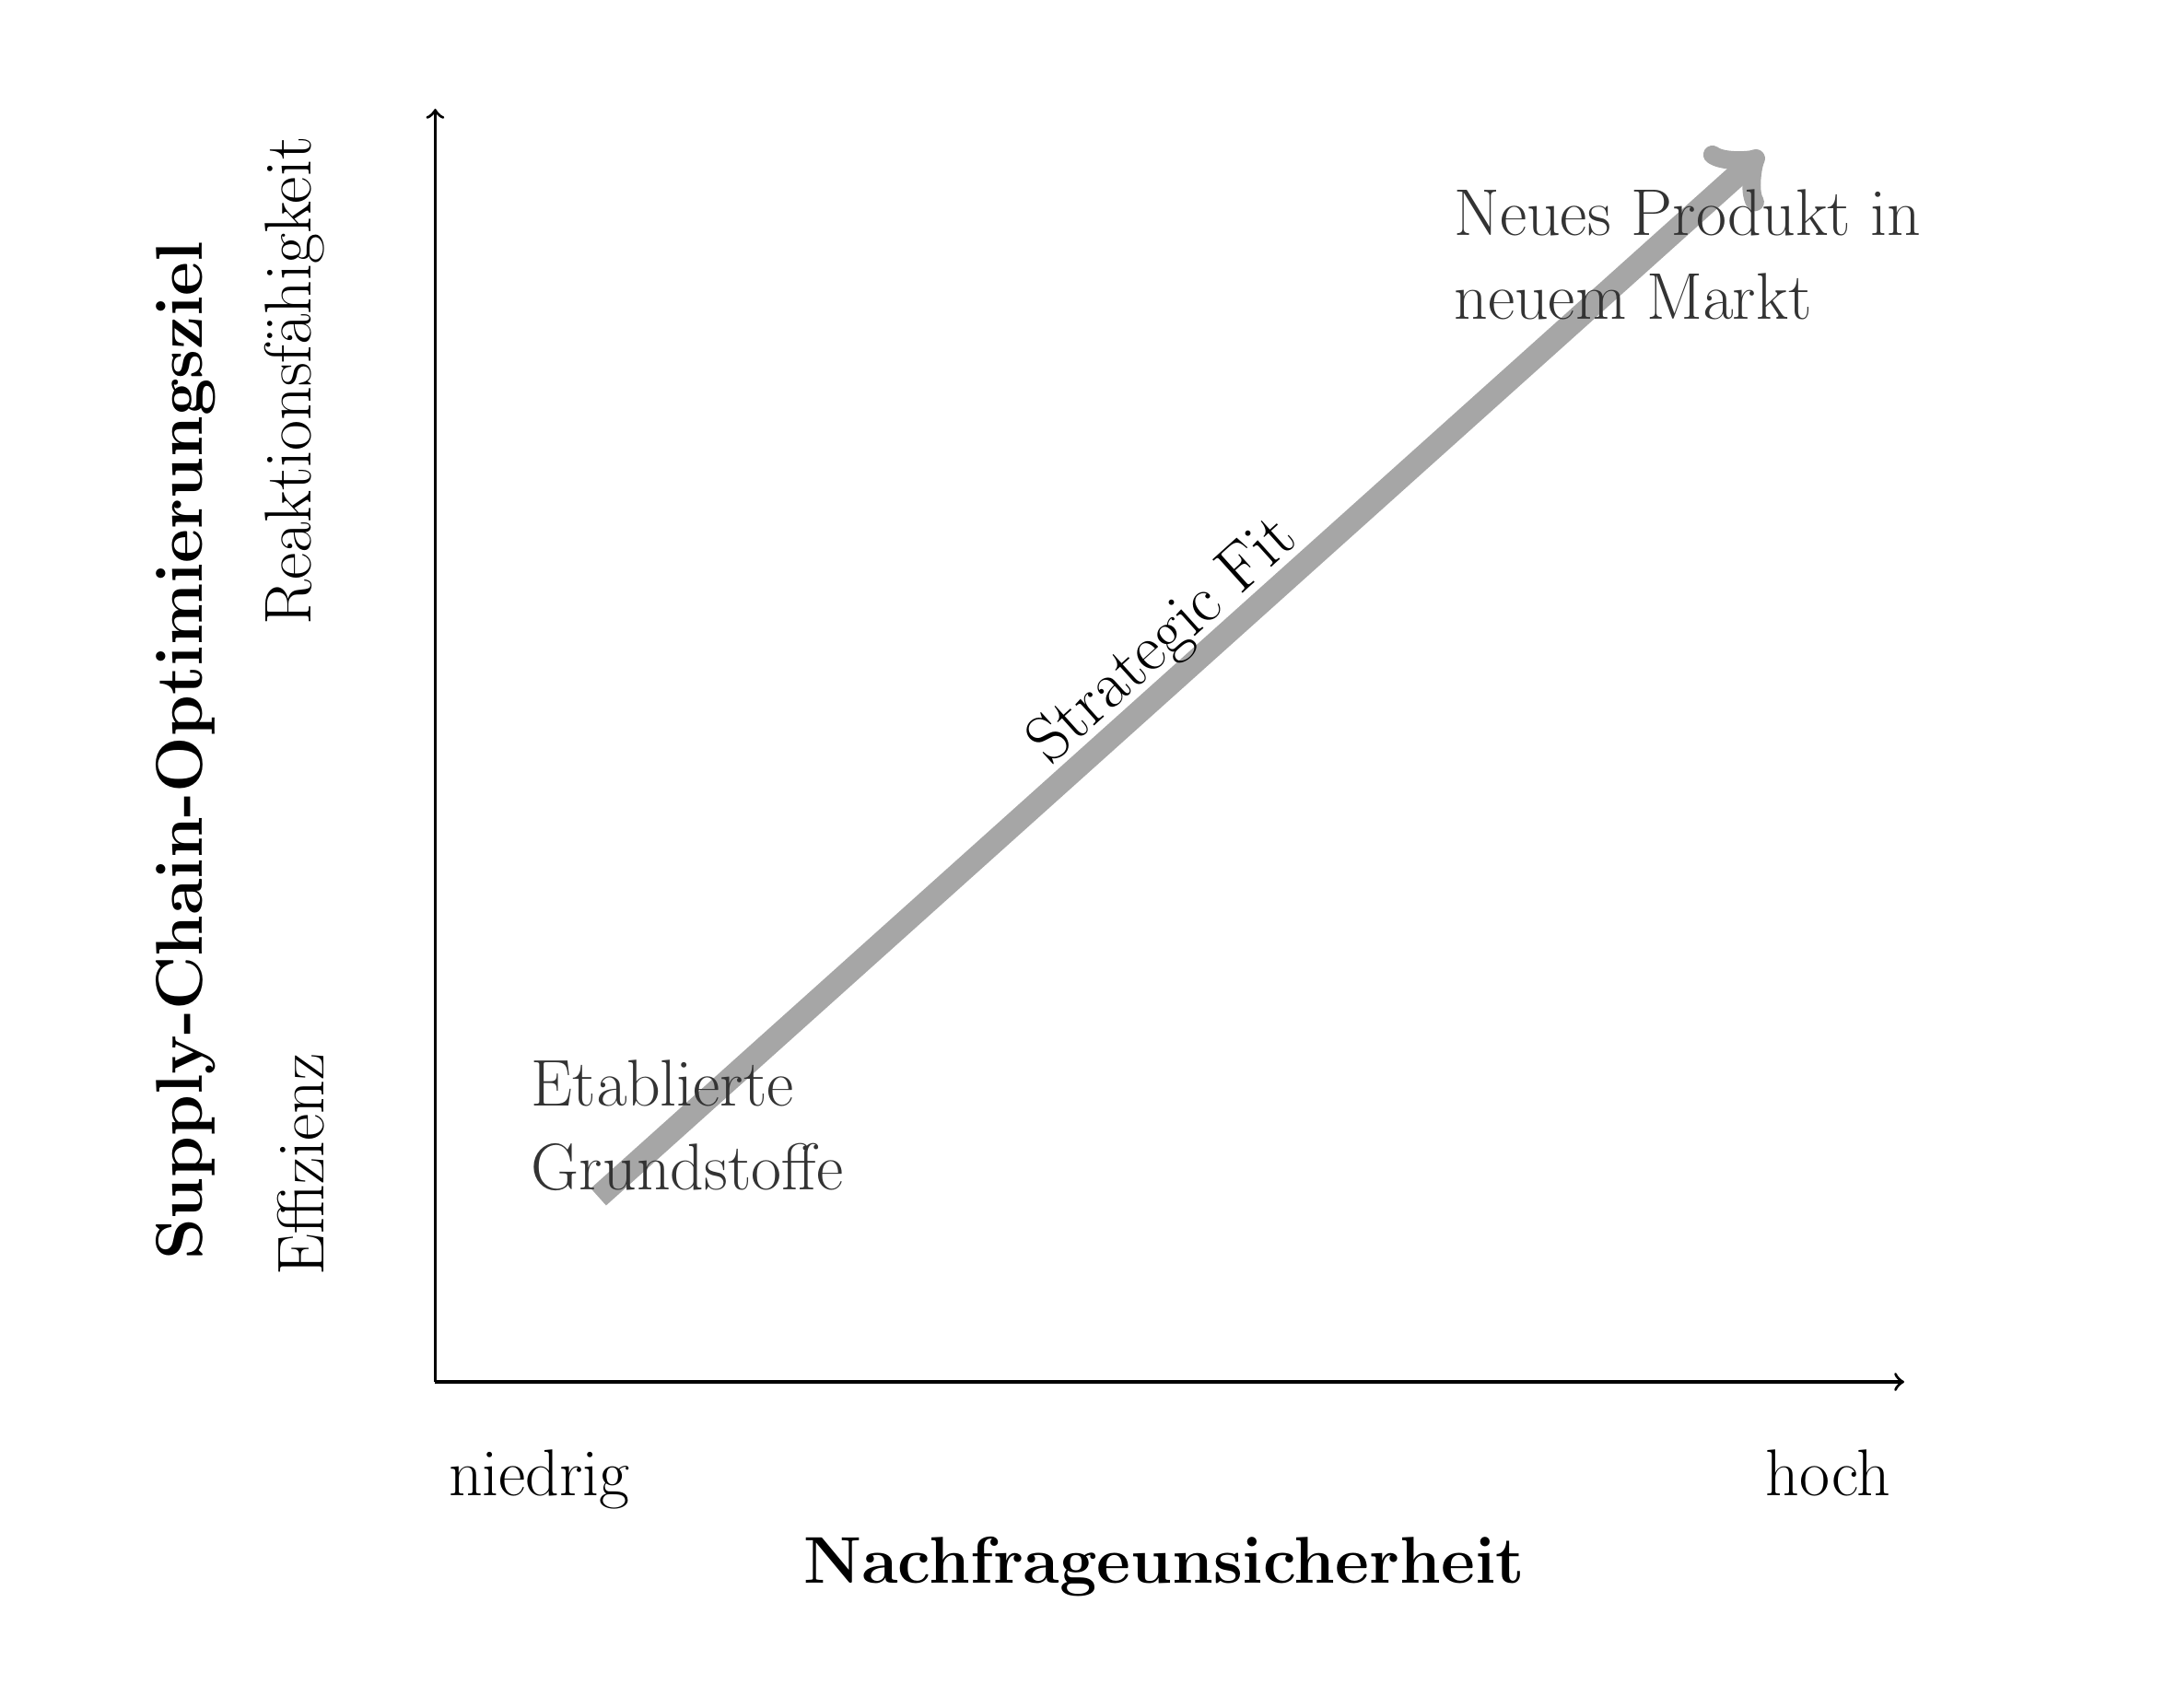
(Chopra and Meindl 2025, S. 56)
Strategische Ziele
Reaktionsfähigkeit vs. Effizienz
Reaktionsfähigkeit
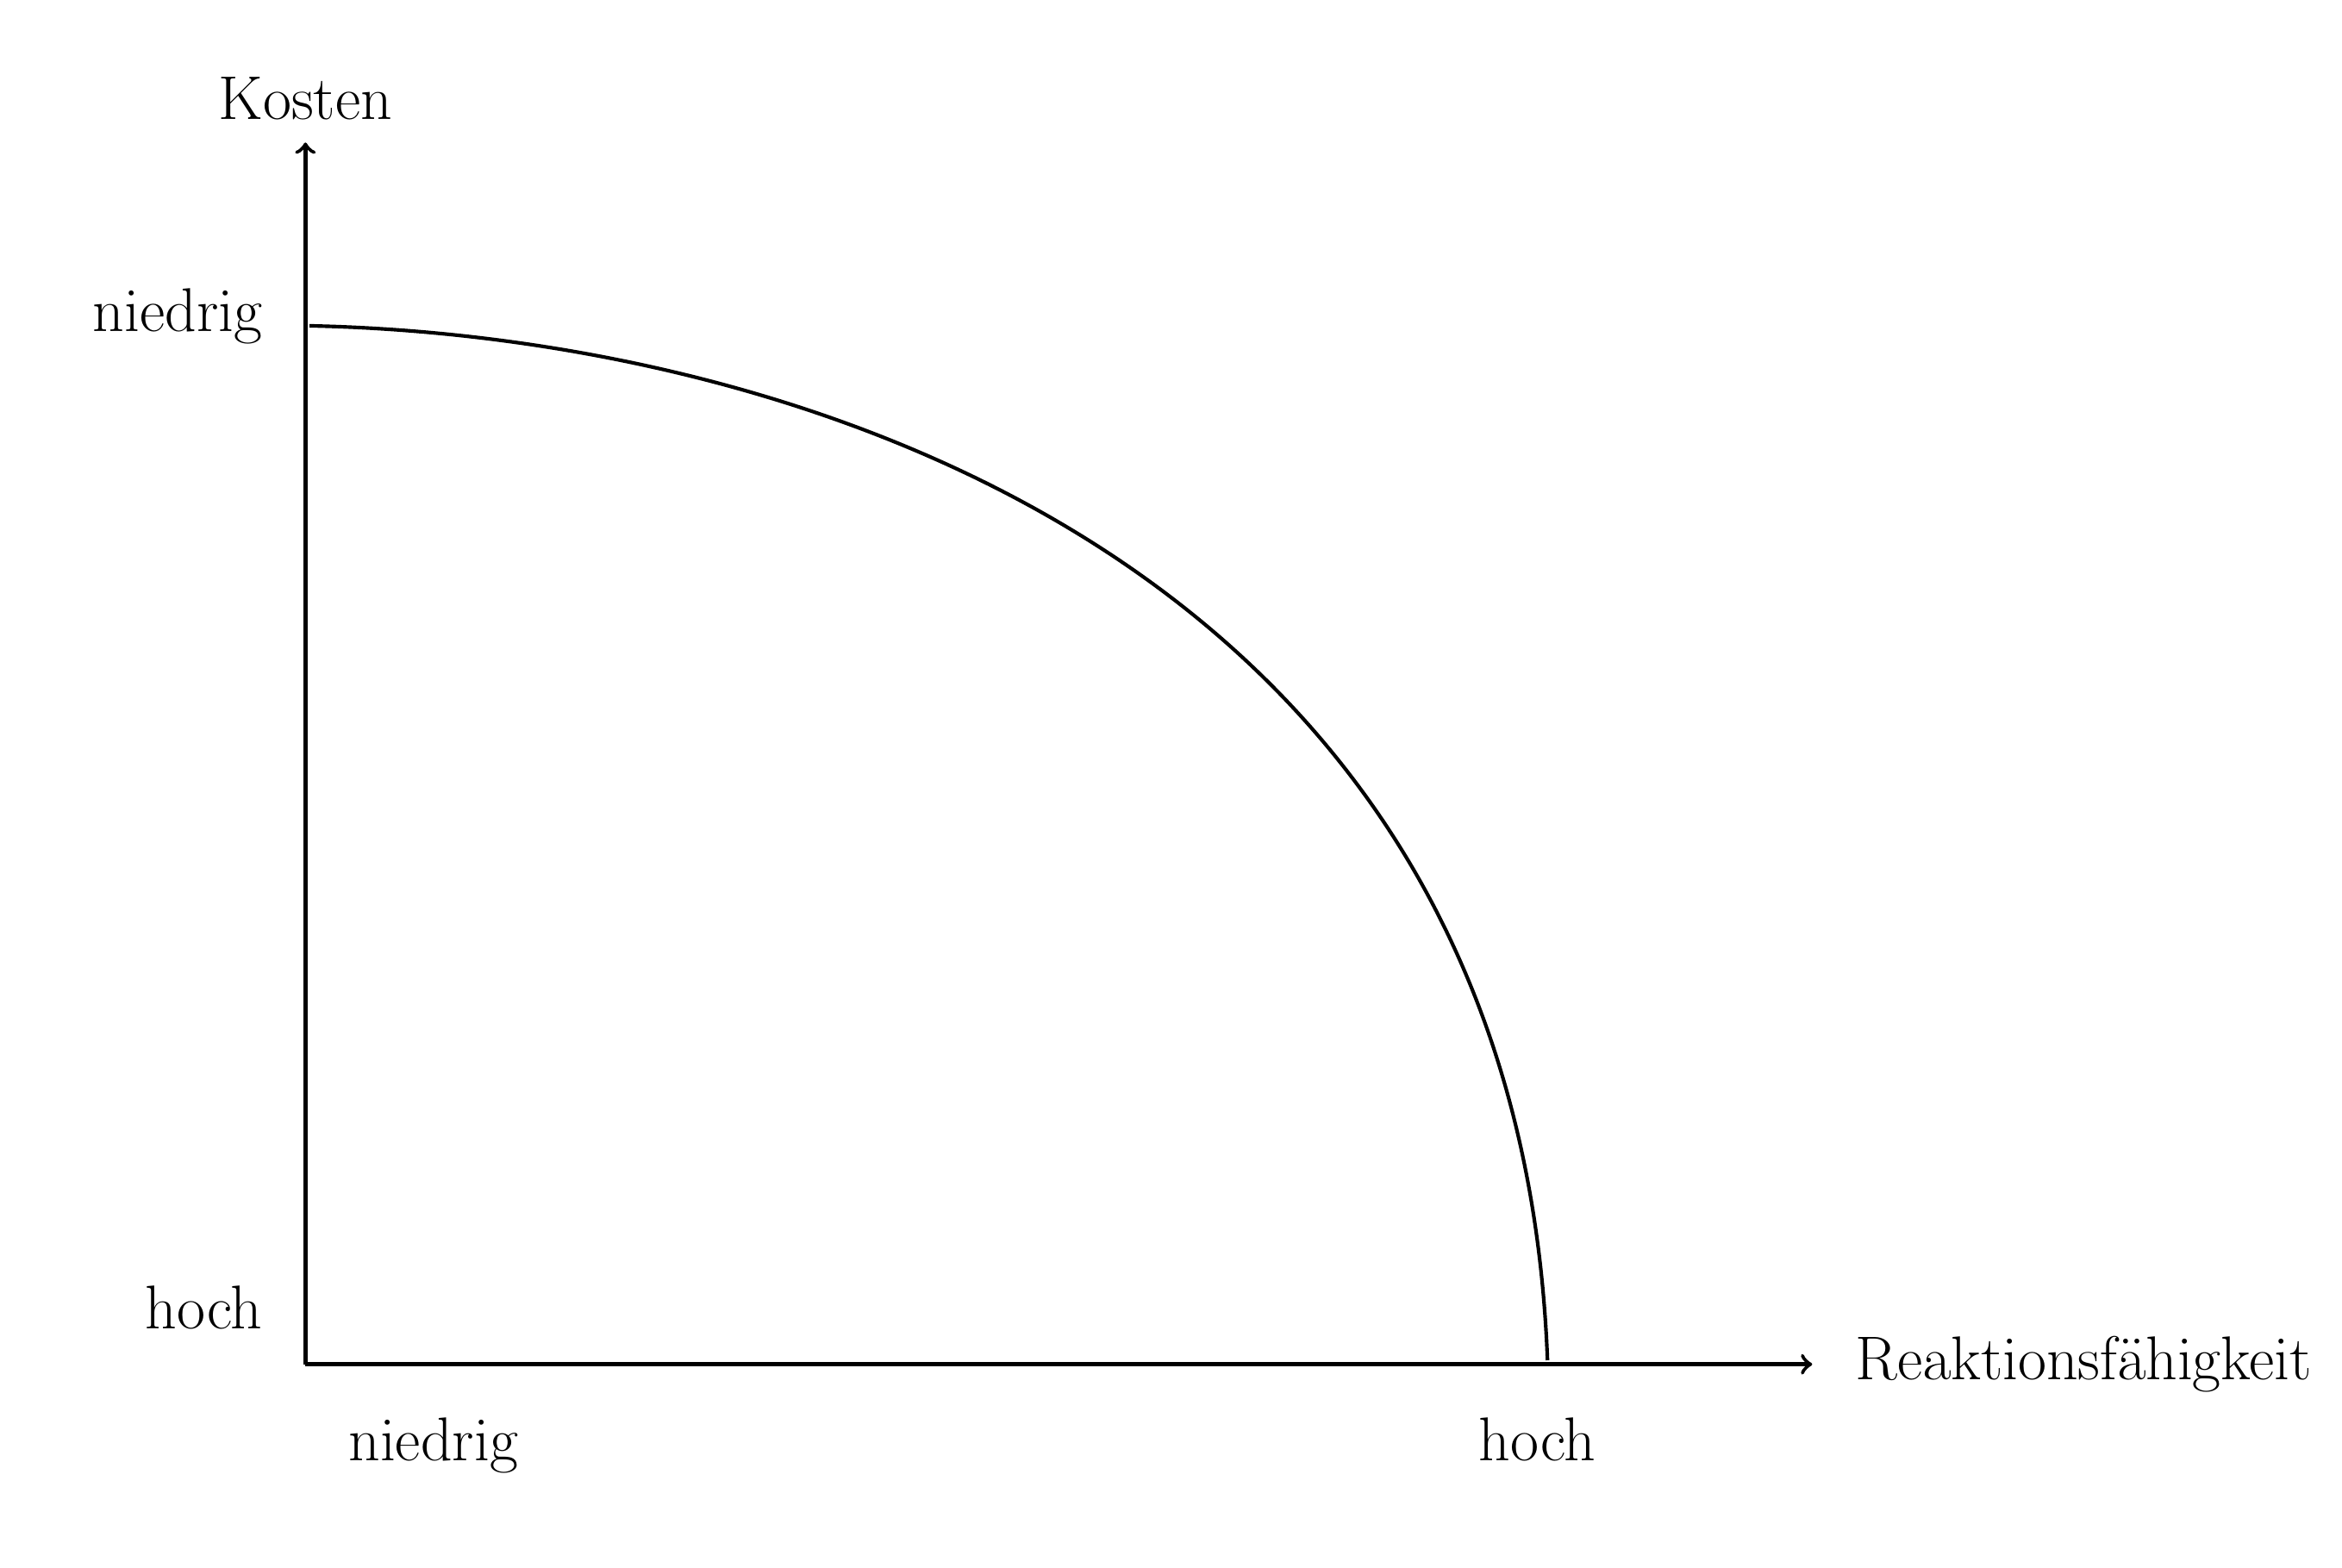
Die Reaktionsfähigkeit einer Supply Chain ist die Fähigkeit einer Supply Chain mit Nachfrageunsicherheit umzugehen
Strategische Treiber

\(\rightarrow\) Reaktionsfähigkeit verursacht Kosten!
Effizienz
Effizienz einer Supply Chain ist das Inverse der Gesamtkosten einer Supply Chain, d.h. aller Kosten eines Produkts von
Strategisches Management
Supply Chain Treiber
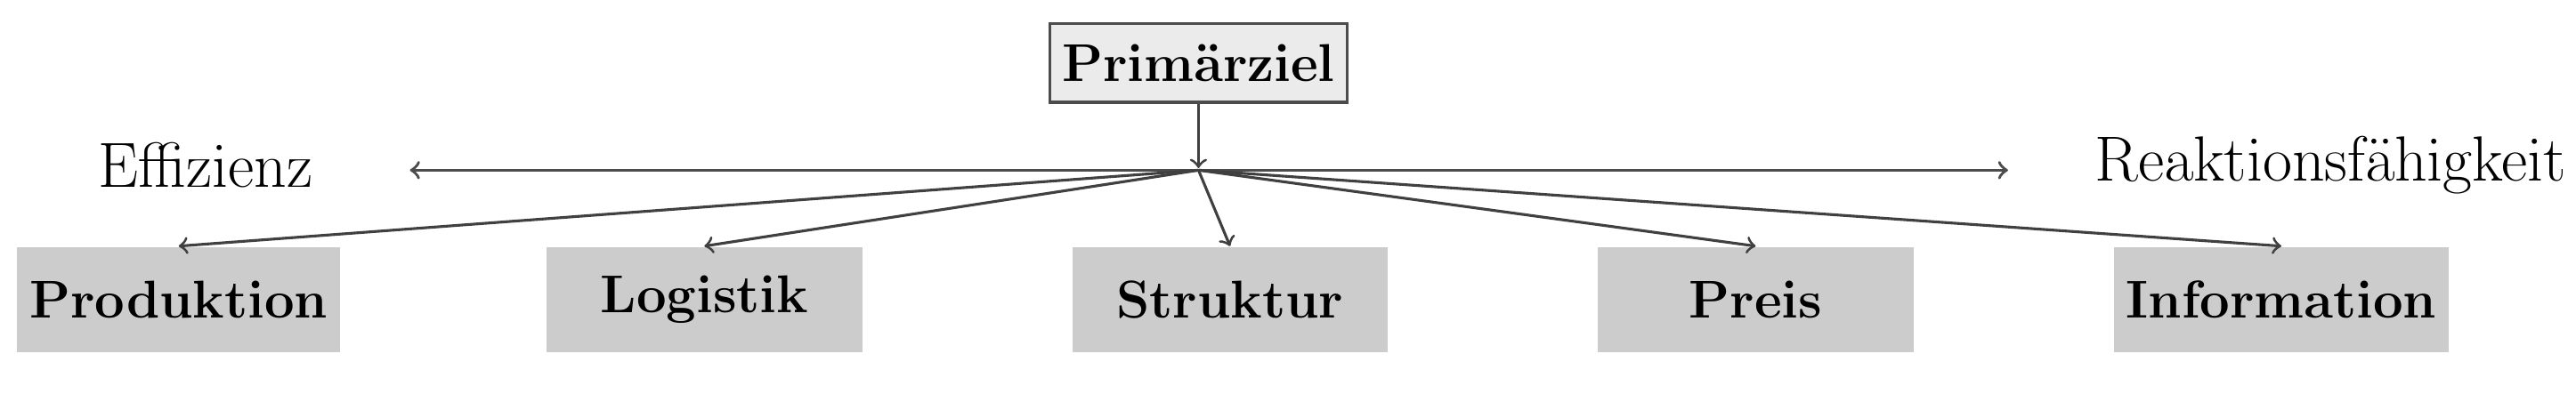
Figure 3
- Produktions- technologie
- Produktportfolio
- Fertigungstiefe
- Transportmodi
- Lagerkapazitäten
- Sicherheits- bestände
- Lieferanten- auswahl
- Standort- kapazitäten
- Stufen & Verbindungen
- Preisgestaltung
- Nachfrage- steuerung
- Rabattierung
- Informations-teilung
- System- integration
- Kollaborative Prognose & Planung
Strategisches Management
Teilstrategien
| Effiziente Supply Chains | Reaktive Supply Chains | |
|---|---|---|
| Primärziel | Nachfragebefriedigung zu niedrigsten Kosten | Schnellstmögliche Nachfragebefriedigung |
| Produkt-Design-Strategie | Geringe Produktvielfalt , Konzentation auf einfaches Design und hohe Durchsätze | Modulare Produktentwicklung und Postponement |
| Preisstrategie | Niedrige Preise und Margen da Kunden preissensitiv | Höhere Preise mit höherer Marge, da Kunden wenig preissensitiv |
| Fertigungsstrategie | Hohe Maschinenauslastung | Freie Kapazitäten um kurzfristig Produktionsmengen ausweiten zu können |
| Lagerstrategie | Minimierung von (Sicherheits-)Beständen | Einrichtung von Sicherheitsbeständen zur Absicherung von Nachfrageschwankungen |
| Versorgungsstrategie | Reduziere Zykluszeiten solange Kosten nicht steigen | Reduziere Zykluszeiten auch wenn Kosten steigen |
| Beschaffungsstrategie | Lieferantenauswahl nach Kosten und Verlässlichkeit | Lieferantenauswahl nach Reaktionsfähigkeit, Geschwindigkeit, Flexibilität und Qualität |
Strategisches Management
Normstrategien & SCM
| Normstrategie | Vorteil | Wettbewerbsbasis | Beitrag des SCM |
|---|---|---|---|
| Kostenführer | Kosteneffiziente Produktion anstoßen | Niedrigste Preise in der Produktkategorie | Effiziente kostengünstige Infrastruktur |
| Innovationsführer | Marktstärke nutzen und singuläre Technologie einsetzen | Begehrte und innovative Produkte generieren | Kurze Time- to -Market sichern, Volumen steigern |
| Serviceführer | Service auf Kunden konsequent zuschneiden | Erwartungen kundenspezifisch erfüllen | Kundenorientierte Entwicklung ermöglichen |
| Qualitätsführer | Sichere und zuverlässige Produkte herstellen | Singuläre Produkteigenschaften | Verlässliche SC, Quality Assurance |
| Nachhaltigkeitsführer | Nachhaltige Produkte und Prozesse | Nachhaltigkeitserwartungen der Kunden erfüllen | CO2-Neutralität, Energie- und Ressourcen-Schonung |
Grundlagen des SCM - Kosten & Management
Grundlagen des Supply Chain Managements
- Aufgaben, Begriffe und Konzepte
- Ziele & Zielkonflikte
- Kosten & Management
Lernziele
Nach dieser Einheit können Sie …
- zentrale ökonomische, ökologische und soziale Ziele des Supply Chain Managements benennen,
- Zielkonflikte zwischen Service, Beständen, Transport, Kosten und Nachhaltigkeit analysieren,
- wesentliche Komponenten von Logistikkosten erläutern und quantifizieren,
- geeignete Kennzahlen zur Bewertung logistischer Entscheidungen auswählen und interpretieren.
Literatur zur Vertiefung
- Zielsysteme und Kostenmodelle: (Günther and Tempelmeier 2012, Kapitel 1–3).
- Leistungs- und Kostenperspektive der Distributionslogistik: (Tripp 2024, Kapitel 1–4).
- Nachhaltigkeit als Unternehmensziel: (Dyckhoff et al. 2008, Kapitel 1–3).
Arten von Zielen im Unternehmen
Ebenen im Managementsystem
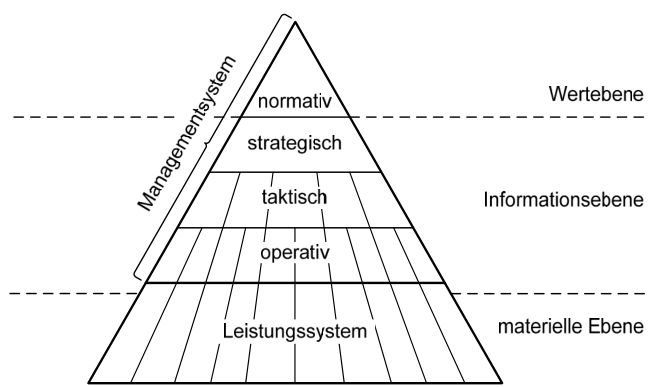
Ziele im Managementsystem
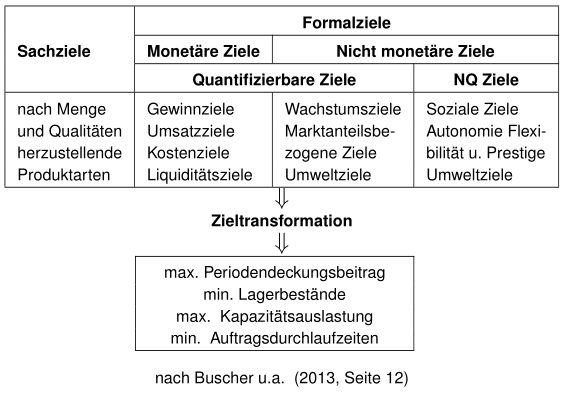
Ziele in Logistik und SCM
Traditionelle Zielmetriken
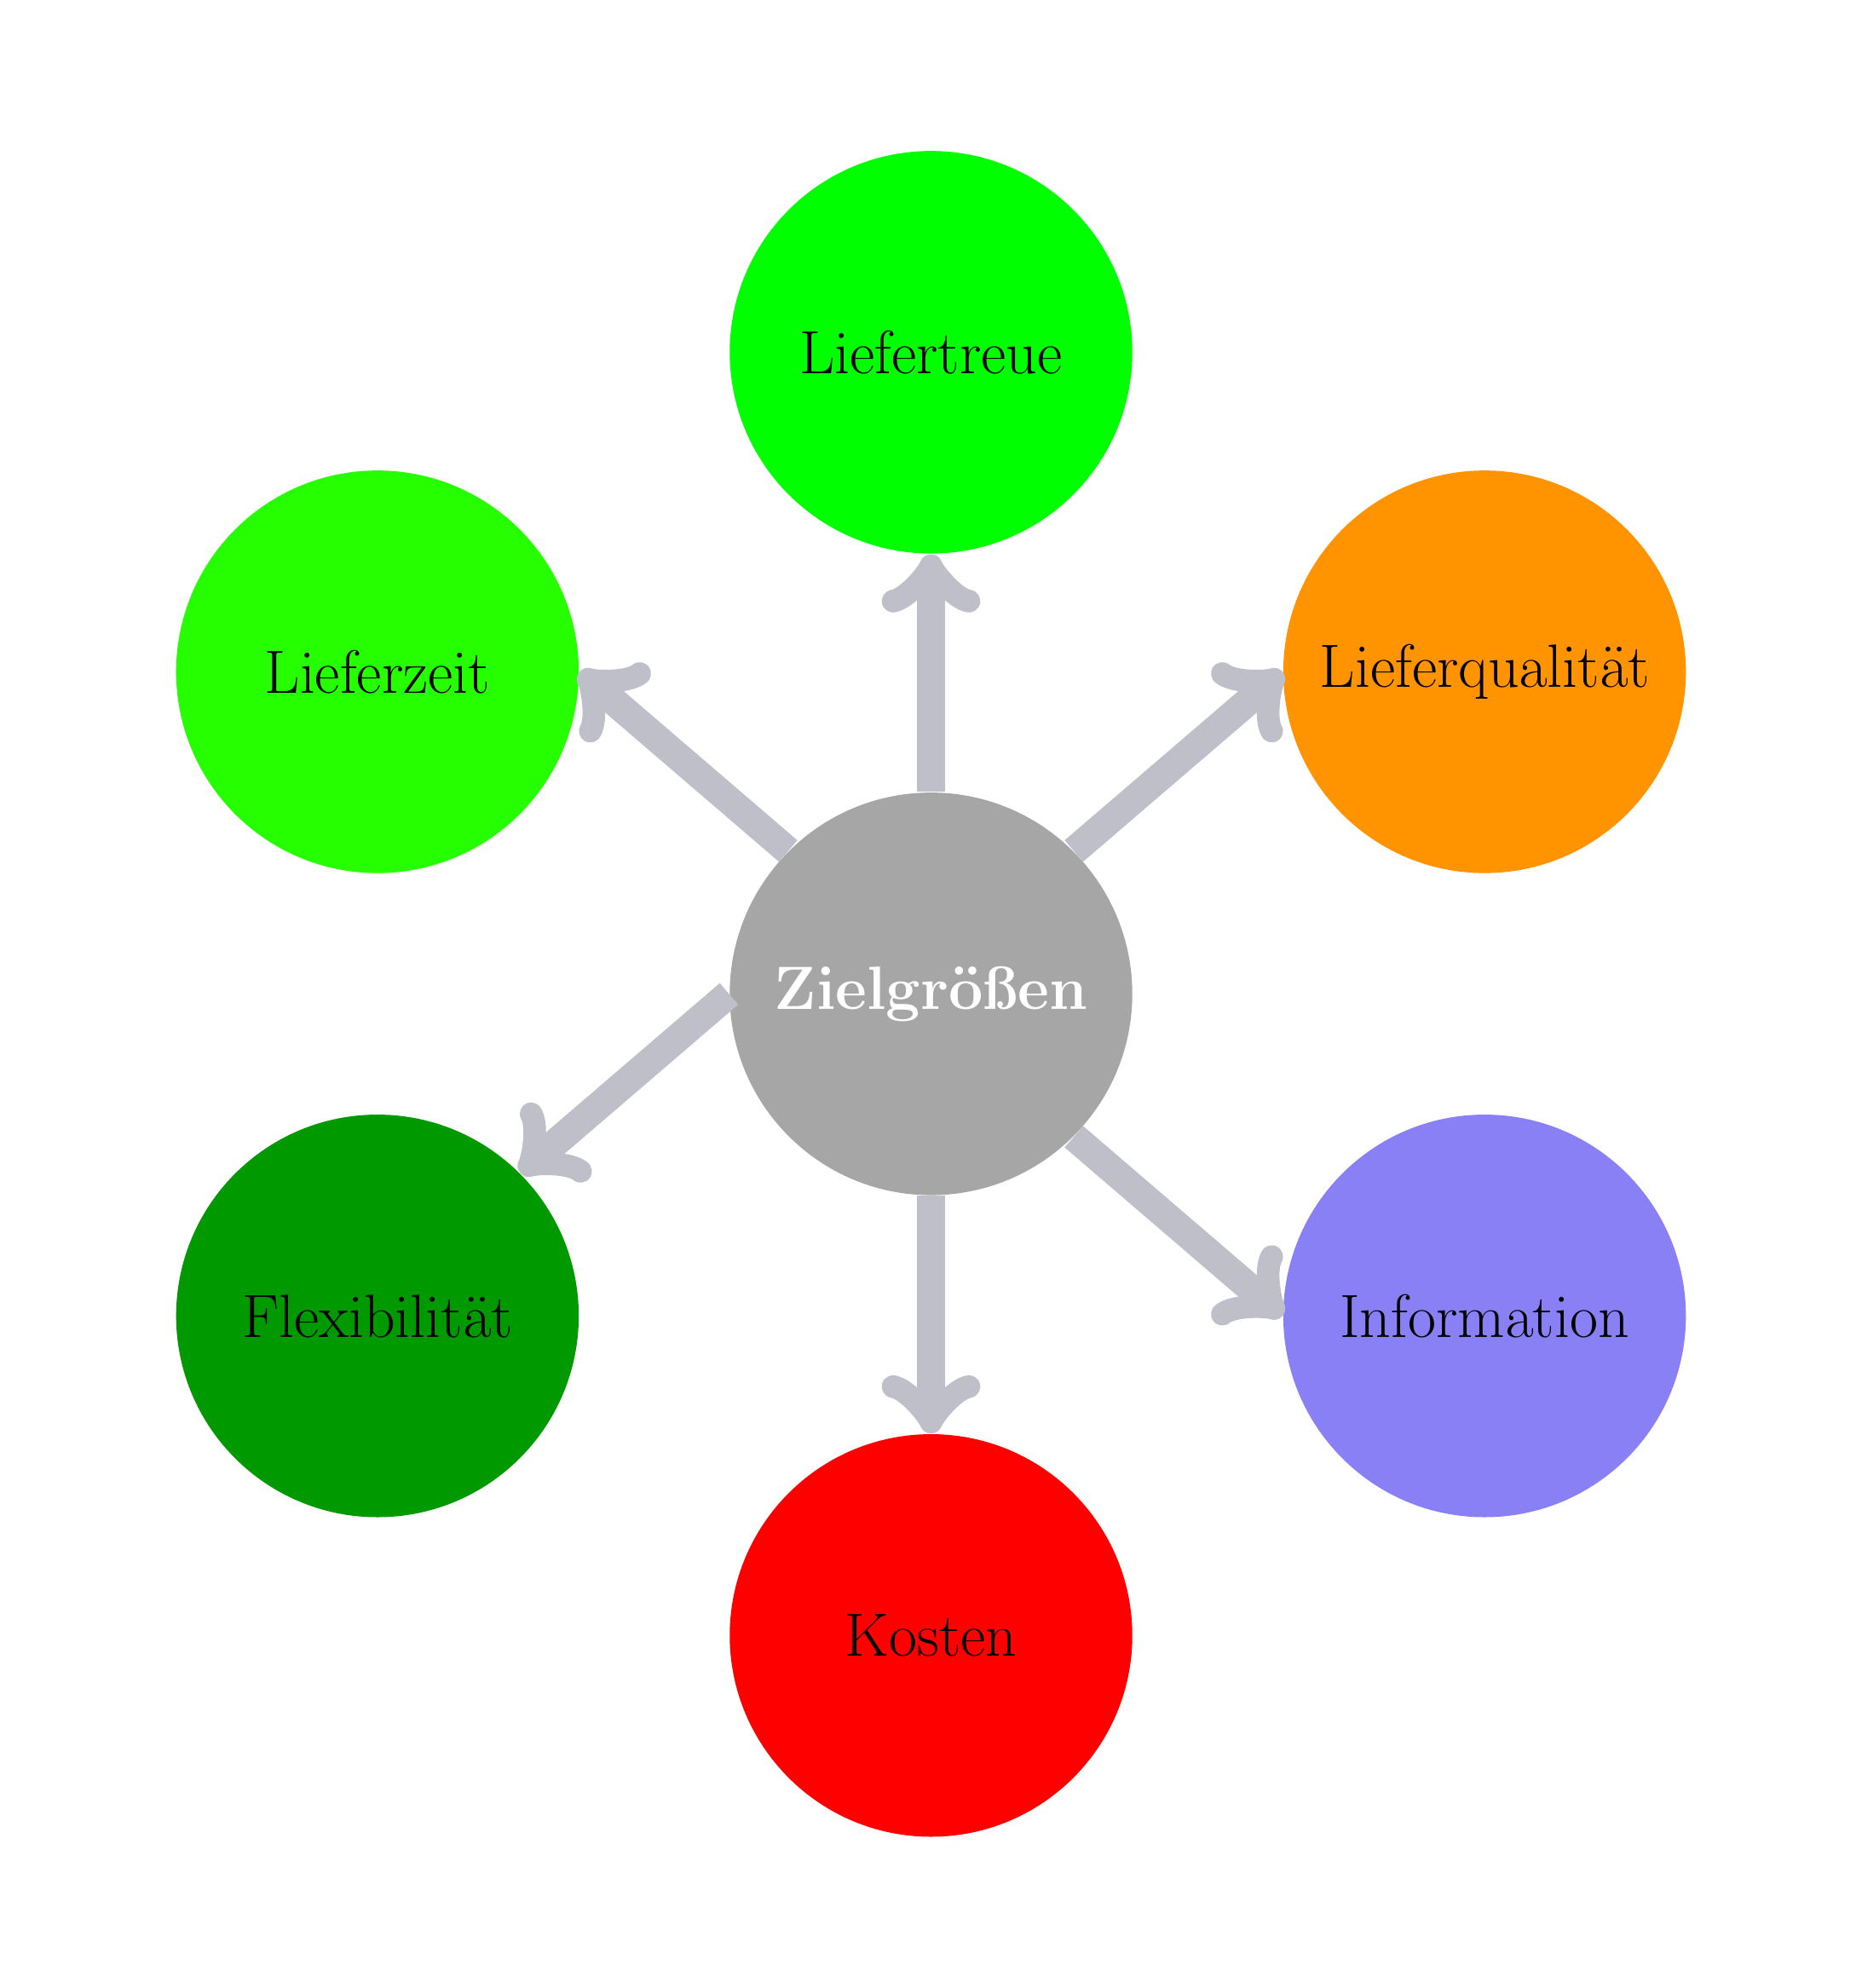
- Lieferzeit: Zeitspanne zwischen Auftragserteilung und Auftragserfüllung
- Liefertreue: Verhältnis zwischen zugesagtem und tatsächlichem Liefertermin
- Lieferqualität: Anteil qualitativ und quantitativ korrekt ausgeführter Aufträge
- Flexibilität/Resilienz: Realisierbarkeit kurzfristiger Mengen-, Termin- und Spezifikationsänderungen
- Information: Qualität und Transparenz der Information in allen Phasen der Auftragsabwicklung
- Kosten: Effizienz aller Logistikaktivitäten, Gesamtkosten der logistischen Aktivitäten
Zieldimensionen
Konflikte & Profile
Zieldimensionen
Zielprofile
Logistikkosten
Abwägungsentscheidungen in Logistik und SCM
- In vielen Teilbereichen der Logistik widerstreitende Kostenkomponenten \(\rightarrow\) Kostenoptimum existiert (zumindest theoretisch)
- Logistikmanagement heißt u.a. Entscheidungen über Logistiksysteme treffen
- Transparenz der Kostenfunktionen z.T. stark eingeschränkt
- Datenverfügbarkeit
- Intertemporale Zurechenbarkeit
- Kostenträgerschaft
- Stochastizität
Logistikkosten
Beispiele
Logistikkosten
bewerteter Verzehr von Sachgütern und Dienstleistungen zum Zweck der Erbringung logistischer Dienstleistungen.
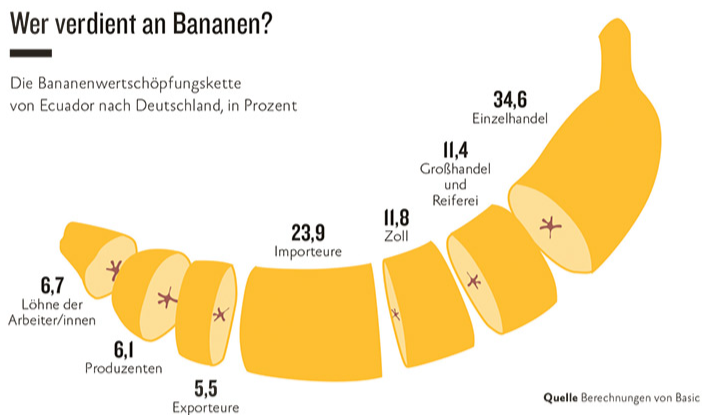
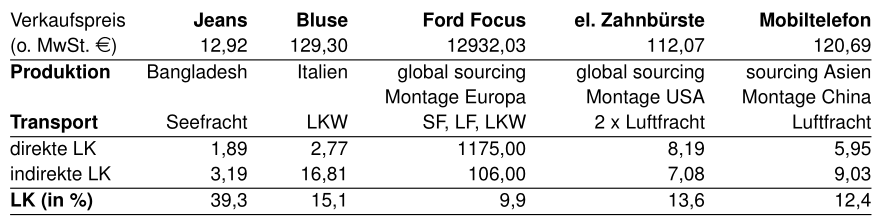
Supply Chain Costing
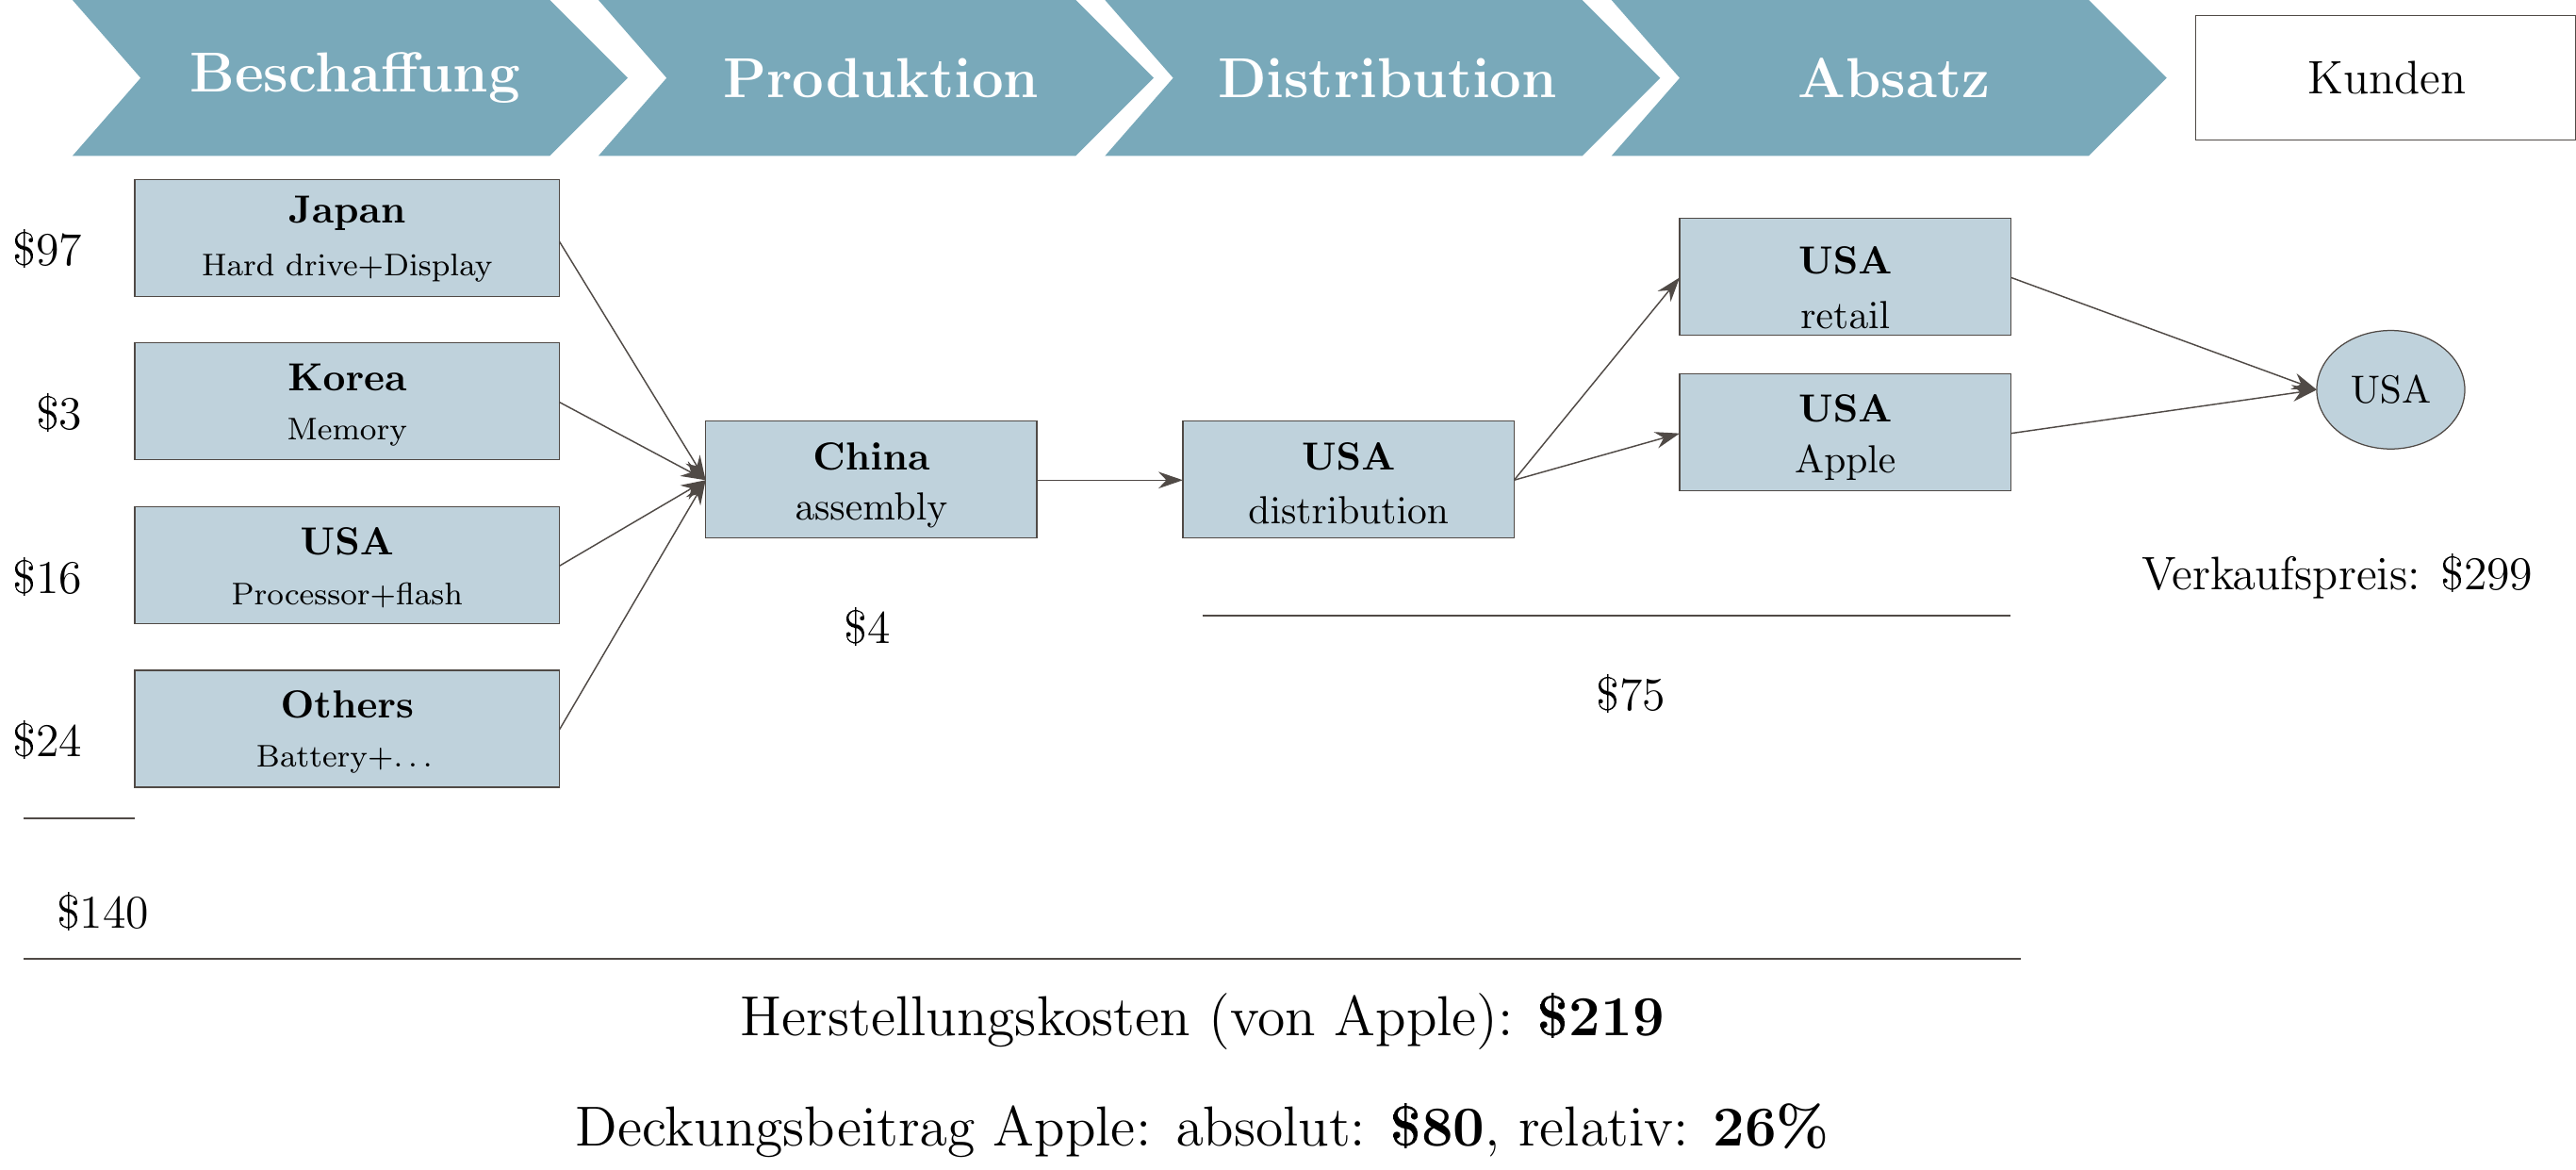
Beispiel – Apple Video IPod 30 GB
Sustainable Supply Chain management
Nachhaltigkeit als Zieldimension
Definition Nachhaltigkiet (Versuch)
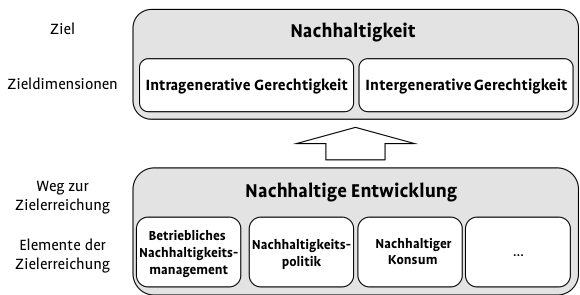
Ein Gesellschaftssystem wird als nachhaltig bezeichnet, wenn es intra- als intergenerativ gerecht angesehen werden kann. Gerecht heisst „die Bedürfnisse der Gegenwart befriedigt, ohne zu riskieren, dass künftige Generationen ihre eigenen Bedürfnisse nicht befriedigen können” (Hauff 1987)
Nachhaltigkeit & nachhaltige Entwicklung
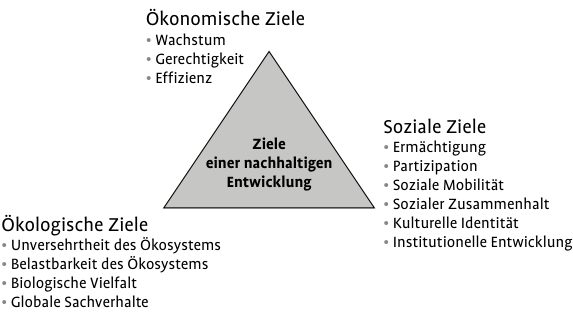
Mögliche Zieldimensionen
Ökologischer strategic fit
Ökologieorientierung und Betroffenheit (Günther 2008)
Ökologieresistenz
Hohe Betroffenheit, aber geringe Ökologieorientierung. Typisch sind verzögernde oder minimalistische Reaktionsmuster.
-
SKW Piesteritz (Chemie)
nur regulatorische Mindestanpassung; ökologische Investitionen werden verschoben, Lobbyismus
Dimensionen ökologischer SCM-Strategien
Nachhaltigkeit
Allgemeine Konzepte (Ellen MacArthur Foundation)
Nachhlatigkeitspyramide
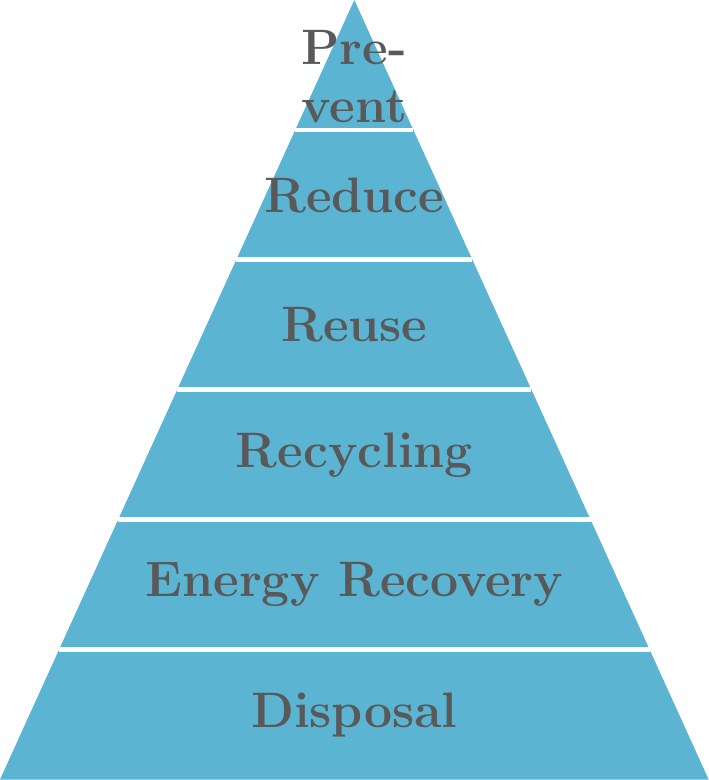
Kreislaufwirtschaft 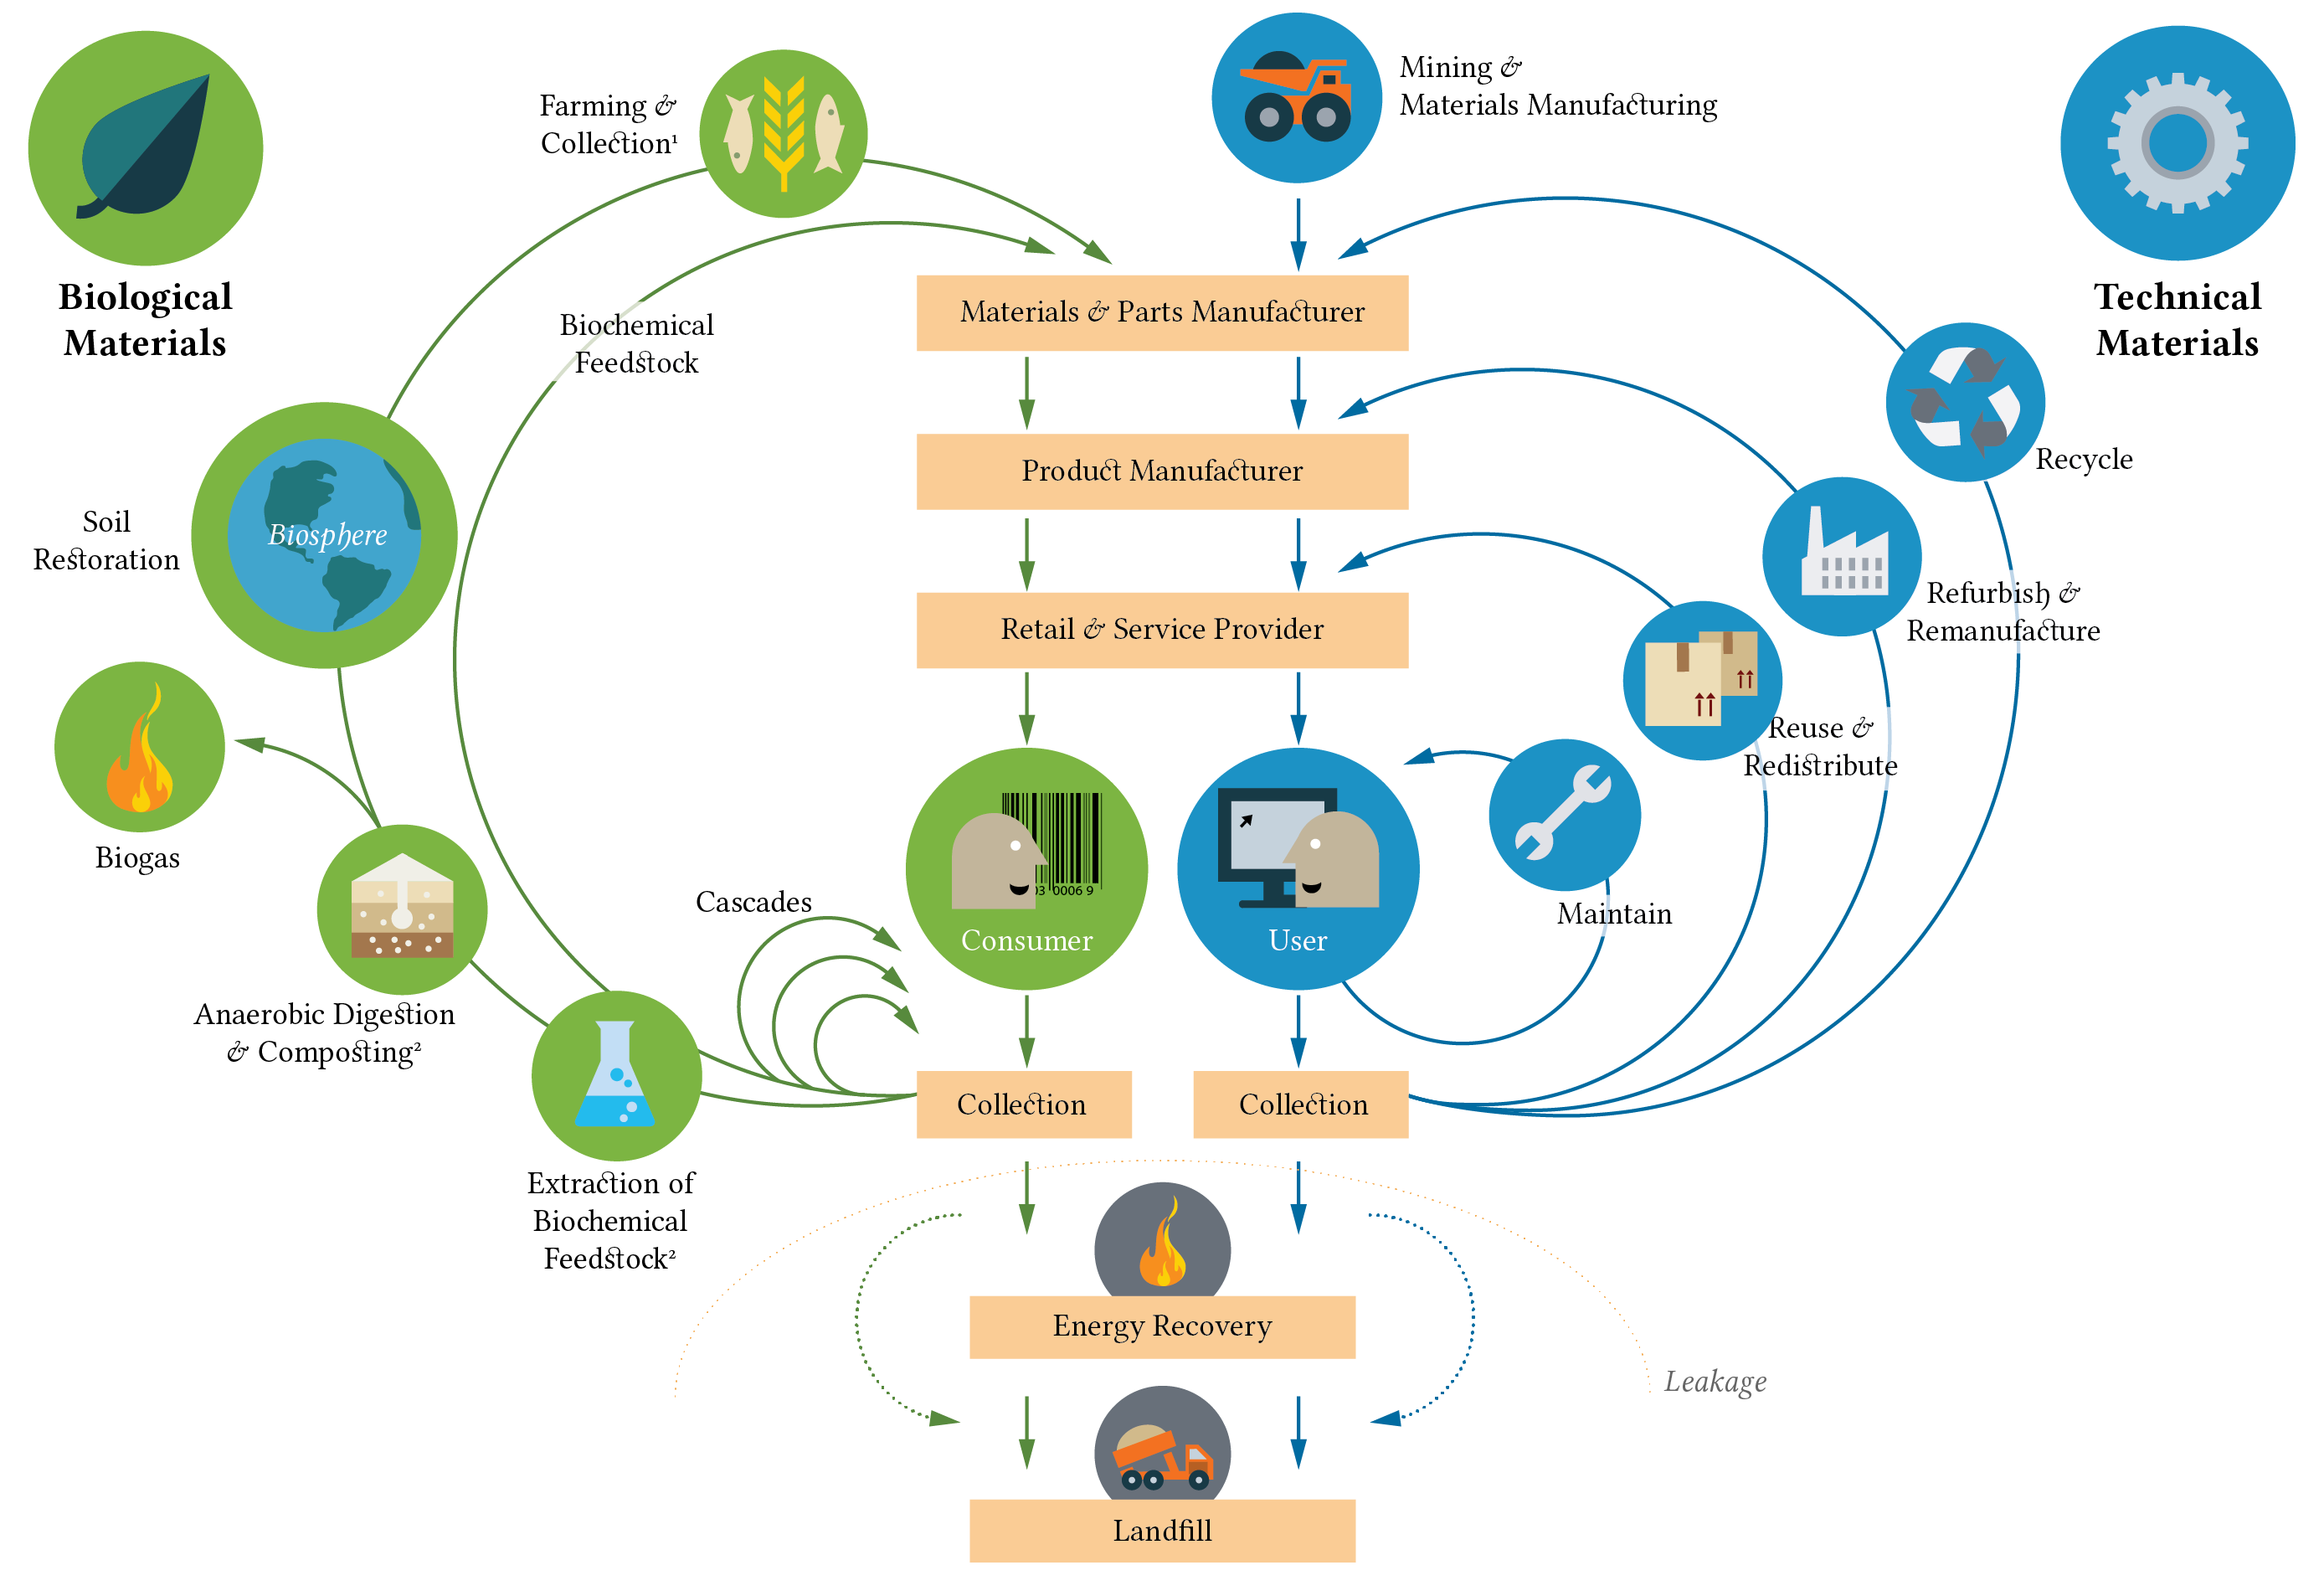
Circular Supply Chain
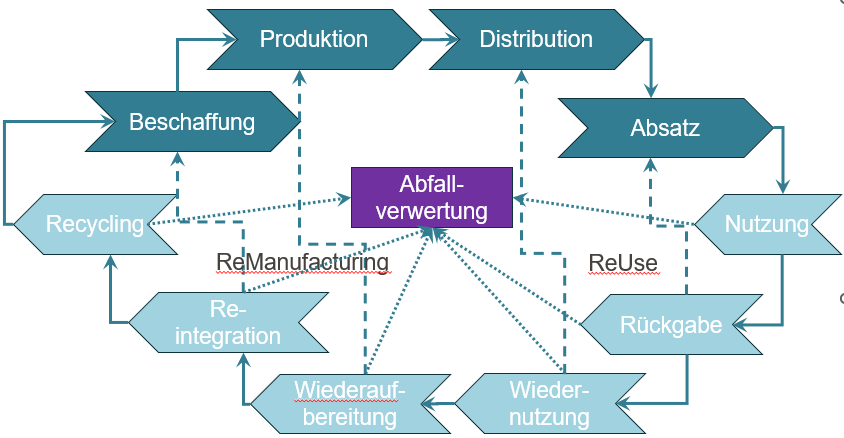
Zusammenhang von linearer, reverser und zirkulärer Supply Chain
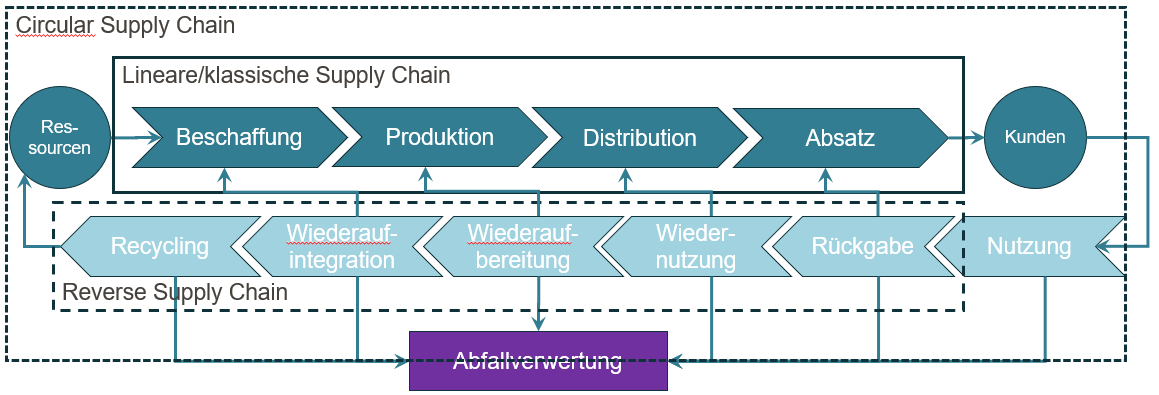
Sustainable SCM
bezeichnet die Planung, Ausführung und Kontrolle von Geschäftsprozessen unter Berücksichtigung ökonomischer, ökologischer und sozialer Ziele um die langfristige Wettbewerbsfähigkeit der Supply Chain sicherzustellen.
Sustainable Supply Chain Management
- Circular Product Design
- Recyclingfähigkeit
- Wiederverwendung
- Recycled content
- Sustainable logistics
- Gewichtsreduktion
- Distanzreduktion
- Transportvermeidung
- Circular production
- Erneuerbare Energie
- Verwendung von Produktionsabfällen
- Kreislaufführung von Betriebs- und Hilfsstoffen
Sustainable SCM
Planungsaufgaben
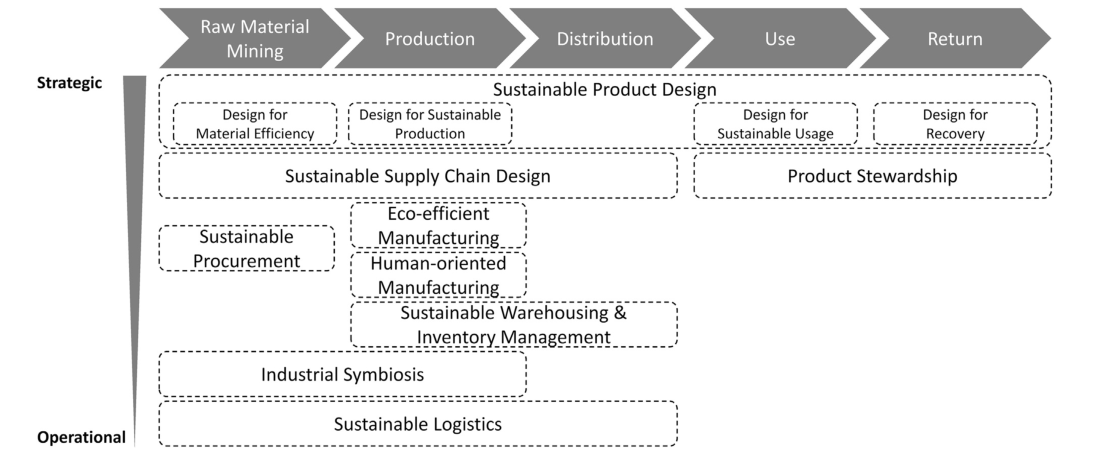
Circular Supply Chain Management
Normstrategien
Circular Supply Chain Management
Normstrategien
Circular Supply Chain Management
Normstrategien
Circular Supply Chain Management
Normstrategien
Fallbeispiel SushiFresh GmbH
Die Geschäftsidee
SushiFresh GmbH ist ein Start-up, das täglich frisch hergestellte Sushi-Boxen in einer deutschen Metropolregion anbietet.
- Versprechen: „Heute gefertigt, heute verkauft” – Sushi in Restaurantqualität, aber ohne Wartezeit
- Produktion: eine zentrale Küche, Fertigung in den frühen Morgenstunden
- Absatzkanal: Supermärkte (Regalverkauf)
- Sortiment: ca. 12 Boxen (klassisch, vegetarisch, vegan)
Eckdaten
- Haltbarkeit: max. 24–36 Stunden
- Kühlkette: durchgehend 0–4 °C
- Zutaten: Reis, Nori, Gemüse (regional), Lachs und Thunfisch (Import)
- Nachfrage: stark schwankend (Wochentag, Wetter, Events)
- Verkaufsstart: Wachstum von 3 auf 30 Verkaufsstellen geplant
Fallbeispiel SushiFresh GmbH
Diskussion
Leitfragen: Strategische Position
- Welche Kundengruppen und Bedürfnisse steuern die Positionierung – Preis, Frische, Bequemlichkeit oder Nachhaltigkeit?
- Wie unterscheidet sich SushiFresh von Wettbewerbern (Restaurants, Lieferdienste, Supermarkt-Sushi)?
- Welche Zielkonflikte entstehen (Frische vs. Kosten vs. Ausschuss vs. Umwelt)?
- Wo liegt das Unternehmen zwischen Effizienz und Reaktionsfähigkeit? Welche Zielgrößen sind strategisch wichtig?
Leitfragen: Supply-Chain-Struktur
- Wie geht die Supply Chain mit schwankender Nachfrage und schnell verderblicher Ware um?
- Wie lassen sich Kühlkette und Frische über die gesamte Kette sichern?
- Welche Stufen und Partner gehören zur Supply Chain (Lieferanten, Küche, Logistik, Handel)?
- Wie sollte die Supply Chain strukturiert werden Zentralität vs. Dezentralität?
- Welche Wertschöpfungstiefe könnte SushiFresh anstreben? (z.B. eigene Logistik?)
Ziel: Erstellen Sie eine strategische Analyse des Geschäftsmodells von SushiFresh. Leiten Sie eine geeignete Struktur der Supply Chain ab.
Grundlagen des SCM - Distributionsstrukturen und -kanäle
Distributionsstrukturen und -kanäle
- Distributionssystem und Lieferservice
- Absatzkanäle (vertikale Struktur)
- Lagerstufen und Anzahl der Lager (horizontale Struktur)
- Gestaltungsoptionen und Cross-Docking
Lernziele
Nach dieser Einheit können Sie …
- Absatzkanal und Logistikkanal eines Distributionssystems unterscheiden,
- die Komponenten des Lieferservice benennen und mit Kennzahlen messen,
- ein- und mehrstufige Distributionsstrukturen sowie Cross-Docking beschreiben und bewerten,
- den Zusammenhang zwischen Anzahl der Lager, Kosten und Lieferzeit erklären.
Literatur zur Vertiefung
- Distributionsnetzwerke: (Chopra and Meindl 2025); (Günther and Tempelmeier 2012).
- Distributionslogistik und Lieferservice: (Pfohl 2018).
Fallstudie – SushiFresh GmbH
Wohin soll die Distribution wachsen?
Heute
SushiFresh produziert in einer Küche und beliefert sechs eigene Filialen im Rhein-Main-Gebiet täglich direkt. Absatzkanal und Logistikkanal sind einfach: Hersteller → eigene Filiale → Kunde.
Wachstumsideen der Geschäftsführung
- Handel: Eine Supermarktkette (RheinMarkt) möchte die Boxen in ihren Märkten listen.
- Lieferdienst: Frische Boxen direkt zum Endkunden in Frankfurt.
- Onlineshop: Haltbare Sushi-Kits und Zubehör bundesweit (Sushi@Home).
Fragen dieser Einheit
- Welche Absatzkanäle entstehen dadurch, und wer übernimmt welche Funktion?
- Welche Distributionsstruktur (Lagerstufen, Umschlagpunkte) passt zu frischer bzw. haltbarer Ware?
- Welchen Lieferservice erwarten die neuen Kunden?
Fahrplan des Semesters
Diese Einheit spannt den Rahmen für das Semester auf. Wo produziert und gelagert wird, klären anschließend die Einheiten zur Standort- und Transportplanung. Wie viel Bestand trotz unsicherer Nachfrage nötig ist, behandelt der Block Unsicherheits- und Risikomanagement. Wie die Ware kommissioniert und zum Kunden gebracht wird, zeigen die Blöcke Distributionslogistik und operative Distributionsplanung.
Distributionssystem
Absatzkanal und Logistikkanal
Akquisitorische Distribution (Absatzkanal)
Wer ist am Weg zum Kunden beteiligt? Verkauf, Preis, Eigentum, Kundenbeziehung.
→ vertikale Struktur: Hersteller, Großhandel, Einzelhandel, Endkunde
Physische Distribution (Logistikkanal)
Wie fließt die Ware? Lagerstufen, Standorte, Transportwege, Umschlagpunkte.
→ horizontale Struktur: Anzahl der Stufen und der Lager je Stufe
Absatzkanal und Logistikkanal müssen nicht identisch sein. Beim Streckengeschäft verkauft der Händler, aber der Hersteller liefert direkt an den Endkunden. Bei RheinMarkt ist der Absatzkanal festgelegt (Handel), der Logistikkanal ist die offene Frage.
Ziel des Distributionssystems: einen angestrebten Lieferservice zu möglichst geringen Kosten erreichen. Die Planungsaufgaben reichen von strategisch (Struktur, Standorte, Einheiten zur Standortplanung) bis operativ (Touren, Kommissionierung, Einheiten der Distributionslogistik).
Lieferservice
Was der Kunde von der Distribution erwartet
| Komponente | Leitfrage | Kennzahl | RheinMarkt erwartet |
|---|---|---|---|
| Lieferzeit | Wie lange vom Auftrag bis zur Ankunft? | Ø Lieferzeit, Anteil Same-Day | Ware morgens im Regal |
| Lieferzuverlässigkeit | Wird der zugesagte Termin eingehalten? | Termintreue, OTIF | vor Ladenöffnung (8 Uhr) |
| Lieferfähigkeit | Ist die bestellte Ware vorrätig? | α-/β-Servicegrad (vertieft in Pooling und Newsvendor) | keine leeren Regale |
| Lieferbeschaffenheit | Kommt die richtige Ware in richtiger Menge und unbeschädigt an? | Fehlerquote, Reklamationen | Kühlkette, Haltbarkeit |
| Lieferflexibilität | Kann auf Sonderwünsche reagiert werden (Zeitfenster, Mengen)? | Anteil erfüllter Sonderwünsche | Nachlieferung mittags |
| Information | Weiß der Kunde, wo seine Sendung ist? | Tracking, Avis | Lieferavis an Marktleiter |
OTIF (on time, in full) fasst Zuverlässigkeit und Vollständigkeit zusammen: Anteil der Lieferungen, die pünktlich und vollständig ankommen. Handelsketten vereinbaren OTIF-Ziele häufig vertraglich, oft mit Vertragsstrafen.
Absatzkanäle
Direkter und indirekter Vertrieb
| Kanal | Kette | Beispiel |
|---|---|---|
| Direkt (Nullstufe) | Hersteller → Endkunde | SushiFresh-Filialen, Lieferdienst |
| Einstufig indirekt | Hersteller → Einzelhandel → Endkunde | SushiFresh → RheinMarkt |
| Zweistufig indirekt | Hersteller → Großhandel → Einzelhandel → Endkunde | Getränke über Getränkefachgroßhandel |
Funktionen von Zwischenstufen
Sortimentsbildung, Mengenausgleich (große Lieferungen → kleine Abnahmen), Lagerhaltung, Finanzierung, Marktkenntnis, Kundenkontakt.
Abwägung für den Hersteller
- direkt: volle Kontrolle über Preis, Marke, Kundendaten und Marge, aber eigene Logistik und Kundenakquise
- indirekt: Reichweite und Logistik des Handels, aber Margenabgabe, Abhängigkeit und Listungsgebühren
Kanalkonflikte
Wenn SushiFresh dieselben Boxen in eigenen Filialen und bei RheinMarkt anbietet, konkurrieren die Kanäle um dieselben Kunden. Mögliche Antwort: unterschiedliche Sortimente oder Preise je Kanal.
Physische Distributionsstrukturen
Lagerstufen
| Struktur | Vorteil | Nachteil | typisch für |
|---|---|---|---|
| Direkt ab Werk | keine Lagerkosten, keine Umschlagstufe | viele kleine Sendungen, lange Wege | Großkunden, volle Ladungen |
| Zentrallager | Bestand gebündelt (Pooling), einfache Steuerung | lange Auslieferstrecken | mittelgroße Länder, Spezialsortimente |
| Zentral- + Regionallager | kurze Lieferzeiten, gebündelte Hauptläufe | mehr Bestand und Umschlag, komplexere Steuerung | Lebensmittelhandel, Ersatzteile |
| Cross-Docking | Bündelung ohne Lagerbestand, schneller Durchlauf | hohe Synchronisationsanforderung | Frische, Handelslogistik, KEP |
Wie viele Lager?
Kosten und Lieferzeit in Abhängigkeit von der Lageranzahl
Gegenläufige Effekte
- Lager- und Bestandskosten steigen mit der Zahl der Lager (Bestand nach dem Wurzelgesetz, Herleitung in der Einheit Pooling).
- Auslieferkosten sinken, weil die Kunden näher am Lager liegen.
- Die Lieferzeit sinkt mit jedem zusätzlichen Lager.
Im Beispiel liegt das Kostenminimum bei 4 Lagern. Eine kürzere Lieferzeit erfordert mehr Lager, das ist ein Zielkonflikt zwischen Kosten und Service (Einheit Ziele und Logistikkosten). Wo die Lager stehen sollen, beantwortet später das Warehouse Location Problem in der Standortplanung.
Distributionsnetzwerke im Handel
Gestaltungsoptionen nach Chopra and Meindl (2025)
| Option | Beschreibung | Lieferzeit | Bestand | Transportkosten | Geeignet für |
|---|---|---|---|---|---|
| Herstellerlager, Direktversand | Händler verkauft, Hersteller verschickt direkt | lang | niedrig (gebündelt) | hoch je Sendung | breites Sortiment, wenig Nachfrage je Artikel |
| Streckengeschäft mit Zusammenführung | Teile mehrerer Hersteller werden unterwegs zu einer Sendung vereint | lang | niedrig | mittel | Konfiguration, Elektronik |
| Händlerlager, Paketversand | Händler lagert und verschickt per KEP-Dienst | mittel | mittel | mittel | Standard-Onlinehandel |
| Händlerlager, eigene Zustellung | Händler stellt mit eigener Flotte zu (letzte Meile) | kurz | hoch | sehr hoch | Lebensmittel, sperrige Güter |
| Lager mit Abholung durch Kunden | Ware wird an Abholpunkte gebracht (Paketstation, Pick-up-Point) | mittel | mittel | niedrig bis mittel | preissensible Kunden, Städte |
| Filiale mit Abholung (Click & Collect) | Bestand im Laden, online reserviert oder bestellt | sehr kurz | hoch | niedrig | Mode, Elektronik, Frische |
Es gibt keine allgemein beste Struktur. Die Wahl folgt dem Produkt (Wert, Haltbarkeit, Nachfragevolumen) und dem geforderten Lieferservice, also wieder dem Strategic Fit.
Cross-Docking
Umschlag ohne Lagerung
Cross-Docking: Eingehende Sendungen mehrerer Lieferanten werden am Umschlagpunkt ohne Einlagerung (in der Regel < 24 h) nach Empfängern umsortiert und in gebündelten Touren ausgeliefert.
Varianten
- einstufig (pre-distribution): Lieferant kommissioniert bereits je Filiale, das Cross-Dock schlägt nur um
- zweistufig (post-distribution): Lieferant liefert sortenrein, das Cross-Dock kommissioniert auf Filialen
Voraussetzungen
- hohe, stabile Volumina je Relation
- zeitliche Synchronisation von Anlieferung und Auslieferung (Zeitfenster-Management)
- verlässliche Lieferanten (Menge, Qualität, Pünktlichkeit)
- Informationsaustausch vor Ankunft (Lieferavis, EDI)
Risiko
Verspätet sich ein Lieferant, verzögern sich alle abgehenden Touren oder die Filiale bekommt ihre Ware nicht. Fehlender Bestand als Puffer ist Vorteil und Risiko zugleich.
Kernaussagen
Das Wichtigste in Kürze
- Ein Distributionssystem hat eine vertikale Struktur (Absatzkanäle: wer verkauft?) und eine horizontale Struktur (Logistikkanal: Lagerstufen, Umschlagpunkte). Beide müssen nicht übereinstimmen.
- Ziel ist ein angestrebter Lieferservice (Lieferzeit, Zuverlässigkeit, Lieferfähigkeit, Beschaffenheit, Flexibilität, Information) zu minimalen Kosten.
- Mehr Lager bedeuten kürzere Lieferzeiten und Auslieferwege, aber mehr Fix- und Bestandskosten (Wurzelgesetz, siehe Einheit Pooling). Wo die Lager stehen, klärt die anschließende Standortplanung.
- Cross-Docking bündelt Warenströme ohne Lagerbestand, verlangt aber eine enge Synchronisation.
- Die passende Struktur folgt dem Produkt und dem geforderten Service (Strategic Fit).
Übung
Übungsaufgaben zu dieser Einheit
Aufgaben zur Klausurvorbereitung (Teil 1) und eine vertiefende Fallstudie (Teil 2) finden Sie in Fallstudie 1: Grundlagen des Supply Chain Managements.
Strategische Gestaltung von Supply Chains
Strategische Gestaltung von Supply Chains
- Multikriterielle Standortplanung
- Kontinuierliche Standortplanung
- Diskrete Standortplanung
- Transportplanung
Lernziele
Nach dieser Einheit können Sie …
- Standortentscheidungen im strategischen Supply-Chain-Design einordnen,
- qualitative Standortfaktoren systematisch erfassen und bewerten,
- das AHP-Verfahren und Nutzwertverfahren erläutern und anwenden,
- die Eigenschaften unterschiedlicher Distanzmetriken erläutern und diese berechnen,
- kontinuierliche Standortverfahren auf einfache Entscheidungsprobleme anwenden und interpretieren.
Literatur zur Vertiefung
- Modellgestützte regionale Standortplanung und -entwicklung: (Kik 2022).
- Standortplanung und kontinuierliche Entscheidungsmodelle: (Thonemann 2023, Kapitel 3).
- Kontinuierliche Standortmodelle und lokale Gleichgewichte: (Cooper 1968).
Planung im Supply Chain Management
Supply Chain Planning Matrix
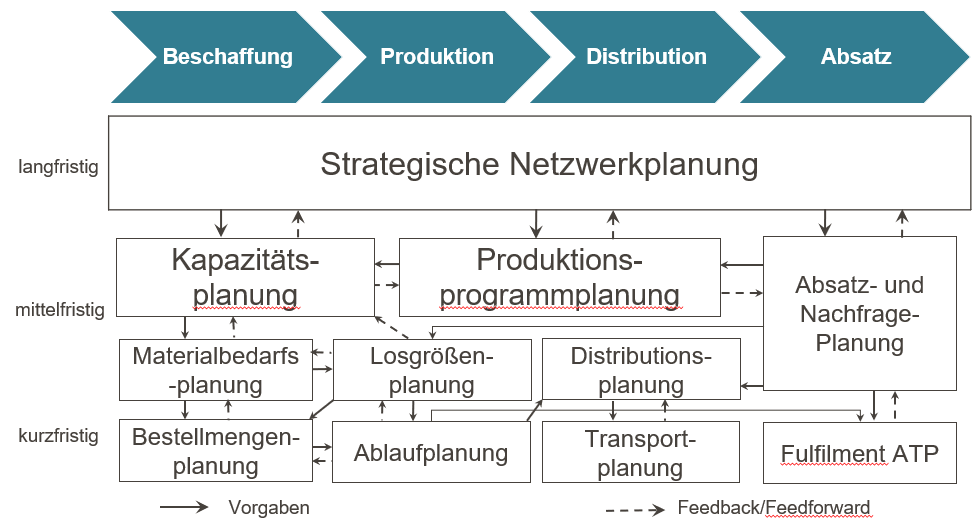
Strategische Netzwerkplanung
Zielstellung der Standortplanung
Entscheidung über Standort von:
- Auslieferungslägern
- Fabriken
- Verkaufsstandorten
- Versorgungslägern
- …
Strategische Netzwerkplanung
Phasen der Standortwahl
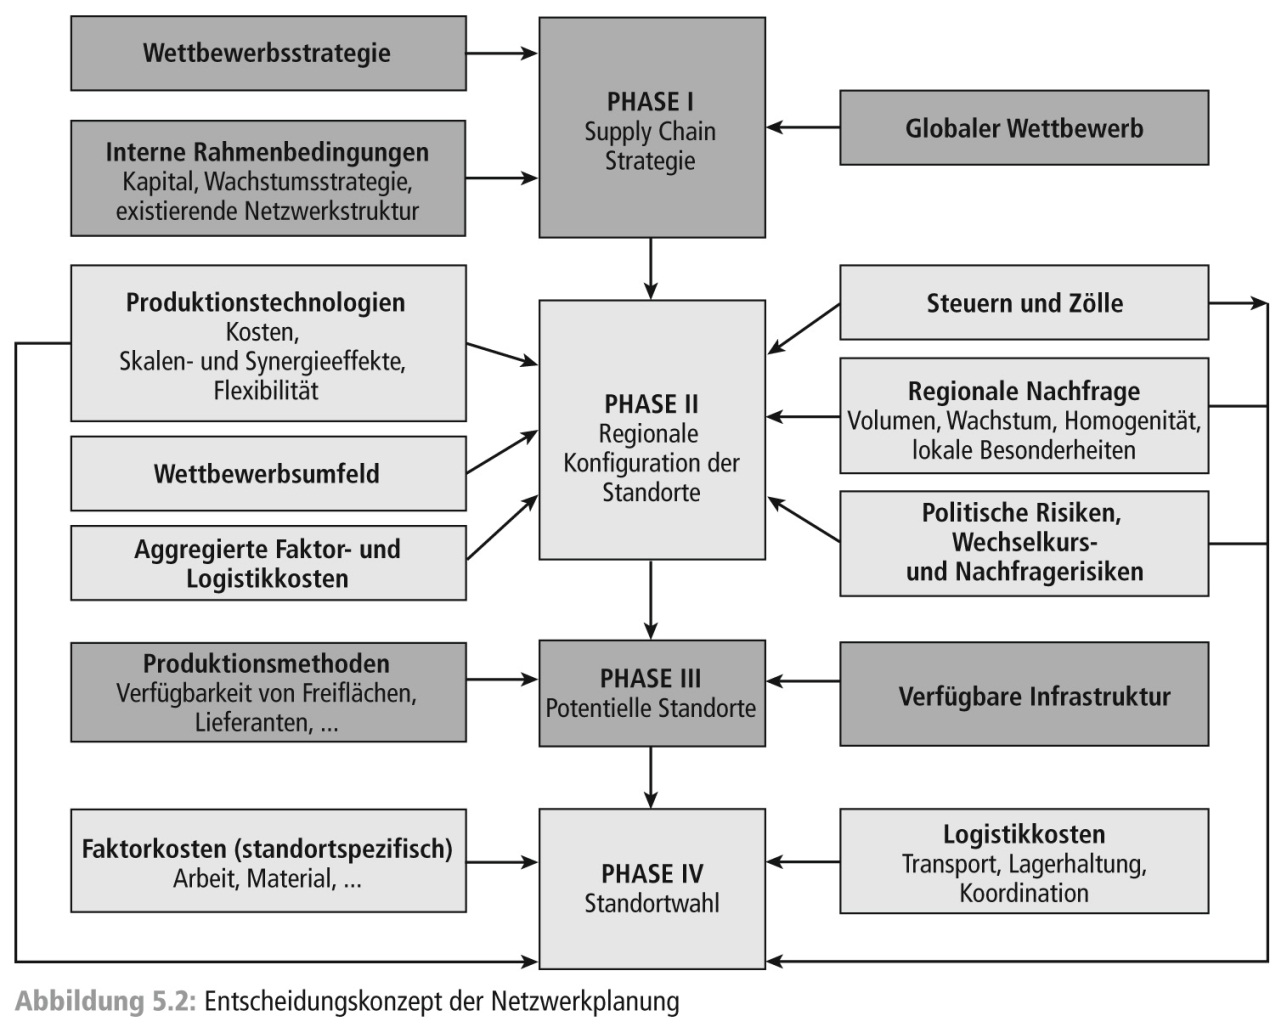
Strategische Netzwerkplanung
Standortplanungsprozess
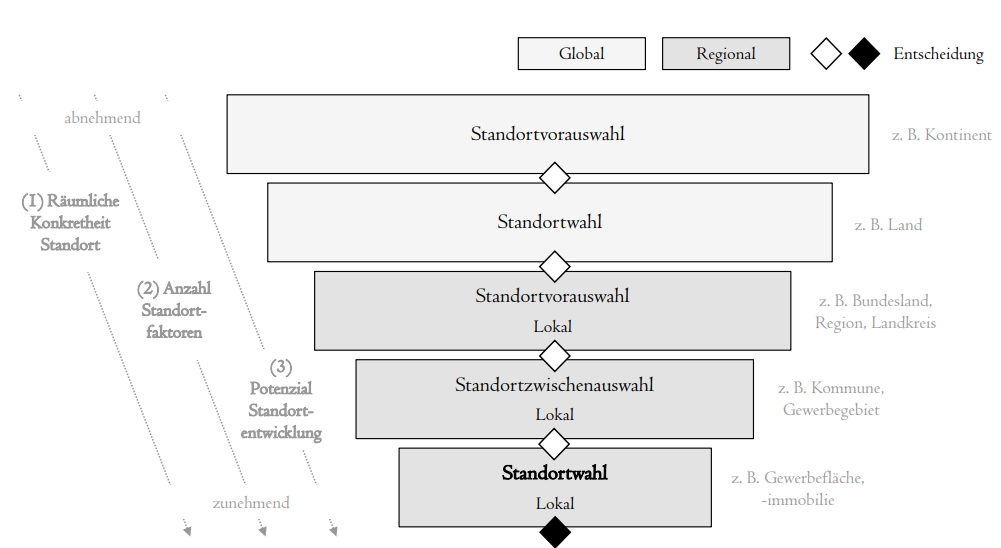
(Kik 2022)
- Auf globaler Ebene Optionen meist überschaubar (Kontinent/Land) \(\rightarrow\) Faktoren stark vereinfacht und aggregiert \(\rightarrow\) unspezifisch, Ziel ist strategische Passfähigkeit
- Auf regionaler Ebene Ziel optimalen Standort identifizieren \(\rightarrow\) präzisere Anforderungen
Strategische Netzwerkplanung
Standortfaktoren
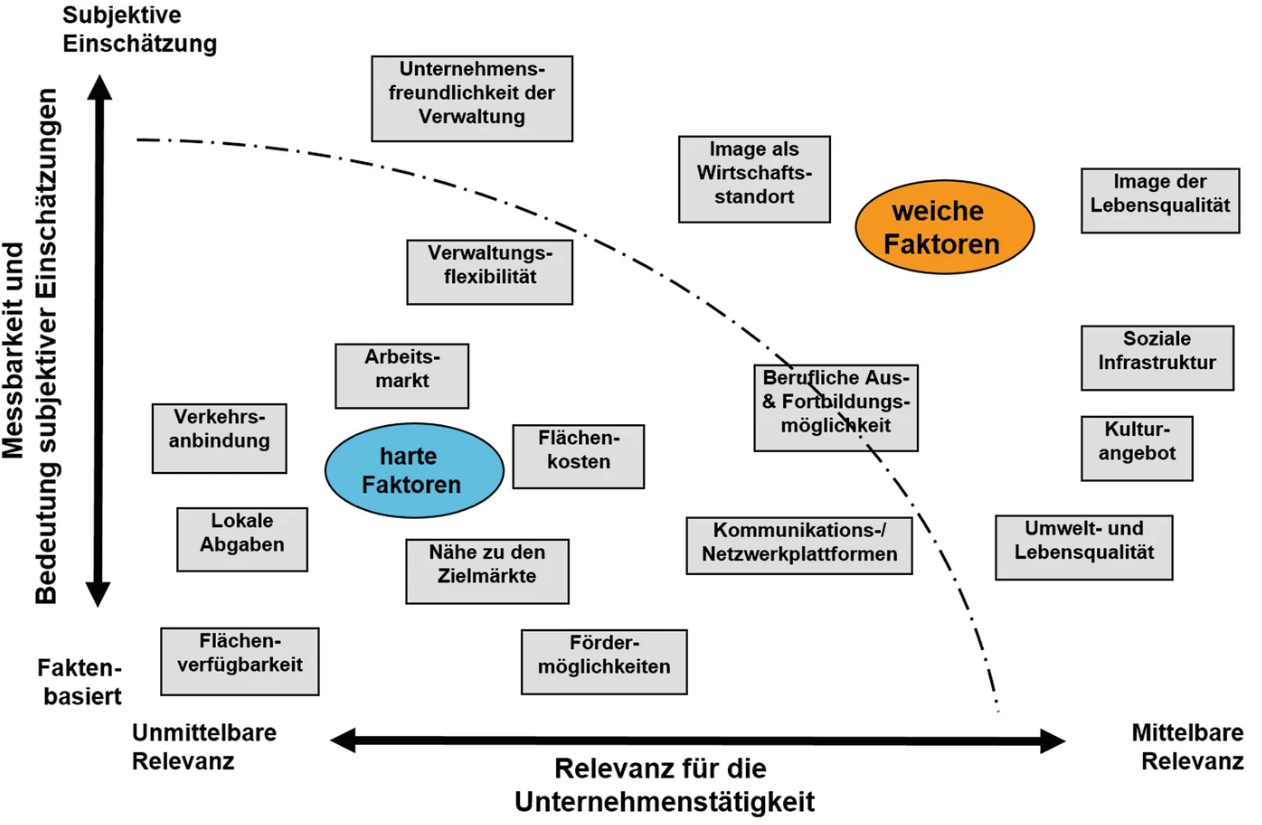
- Bewertung von Standorten für Ansiedlungen oft schwierig
- kurzfristig irreversible \(\rightarrow\) Pfadabhängigkeiten
- Mehrdimensional \(\rightarrow\) Auswirkungen auf Zielsystem schwer zu überblicken
- Subjektiv \(\rightarrow\) Einschätzung zu weichen Faktoren oft schwankend & Bedeutung wird unterschiedlich gewichtet
Strategische Netzwerkplanung
Methoden der Standortplanung
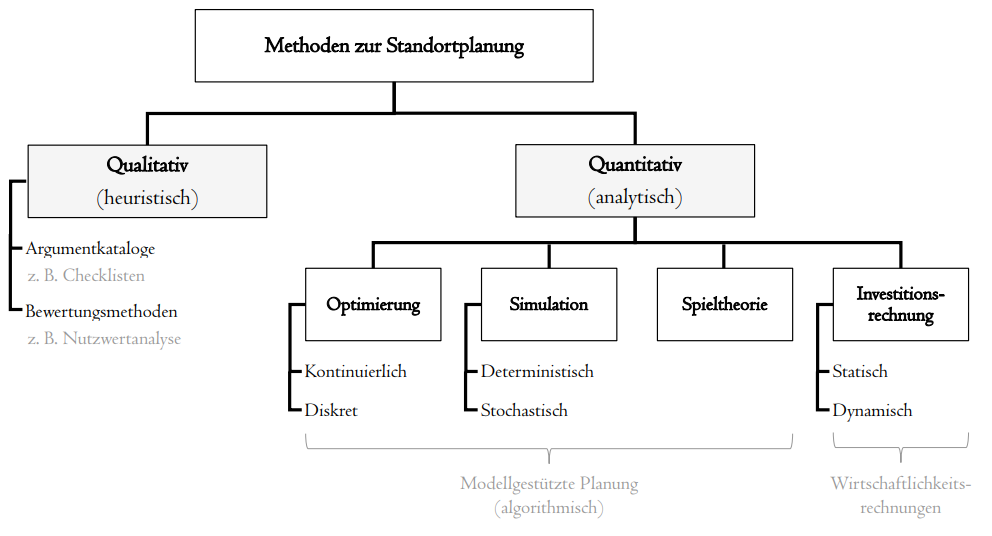
Merkmale von Optimierungsmodellen (Kik 2022) 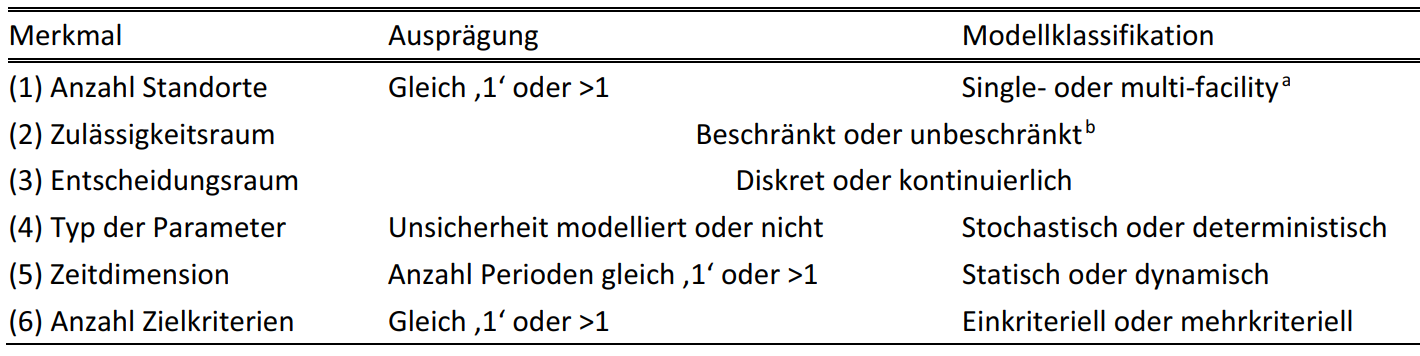
- Qualitative Verfahren \(\rightarrow\) heuristische, meist umfragebasierte Verfahren \(\rightarrow\) Stimmungsbild und Sammlung individueller Einschätzungen
- Quantitative Verfahren
- Optimierung: Entscheidungsraum (Optionen) und eindimensionales Zielsystem nötig
- Simulation: komplex, schwer übertragbar,mehrdimensional
- Spielthorie: Antizipation des Konkurrentenverhalten \(\rightarrow\) Absatzmaximierung
- Investitionsrechnung: ausschließlich monetäre Größen (Optimierung)
Strategische Netzwerkplanung
Fallstudie: SushiFresh GmbH
SushiFresh GmbH ist ein fiktiver regionaler Hersteller frischer Sushi-Boxen im Rhein-Main-Gebiet, der täglich sechs Supermarkt-Filialen beliefert. Diese Fallstudie begleitet uns durch dieses und die folgenden Kapitel.
SushiFresh prüft, ob sich zusätzlich zur Auslieferung eine eigene Produktionsstätte lohnt, und hat drei Kandidatengrundstücke identifiziert.
# Sechs Filialen: Koordinaten, Tagesnachfrage mu und Standardabweichung sigma
filialen <- tibble(
  Filiale = c("Wiesbaden", "Mainz", "Frankfurt", "Ruesselsheim", "Darmstadt", "Offenbach"),
  lat   = c(50.0782, 50.0000, 50.1109, 49.9904, 49.8728, 50.0956),
  lon   = c(8.2398,  8.2711,  8.6821,  8.4116,  8.6512,  8.7761),
  mu    = c(120, 150, 280, 90, 110, 95),
  sigma = c(25, 30, 55, 20, 24, 22)
)

# Drei Kandidatenstandorte fuer die Produktionsstaette
standorte <- tibble(
  Standort = c("Wiesbaden-Erbenheim", "Mainz-Hechtsheim", "Raunheim"),
  lat = c(50.0632, 49.9698, 50.0000),
  lon = c(8.2999,  8.2831,  8.4650),
  Fixkosten = c(180000, 210000, 260000)
)

sum(filialen$mu)  # Gesamtnachfrage: 845 Boxen/Tag
[1] 845Qualitative Standortplanung
Nutzwertanalyse
Vorgehen
- Relevante Bewertungskriterien festlegen
- Kriteriengewichte bestimmen
- Alternativen je Kriterium bewerten
- Gewichtete Teilnutzwerte zum Gesamtnutzwert aggregieren
- Alternativen nach Gesamtnutzwert rangordnen
Kritische Punkte
- Additives Modell nur eingeschränkt interpretierbar
- Schlechte Ausprägungen können durch gute kompensiert werden
- Nutzenunabhängigkeit der Kriterien oft fraglich
- Ergebnisse reagieren empfindlich auf die Gewichtung
- Gefahr der Zielaufspaltung
Fallbeispiel
SushiFresh bewertet die drei Kandidatenstandorte Wiesbaden-Erbenheim, Mainz-Hechtsheim und Raunheim für die neue Produktionsstätte anhand der Kriterien Transportnähe, Mietkosten und Fachkräfteverfügbarkeit, die hier aus Vereinfachungsgründen gleich gewichtet werden.
Die Konstellation ist bewusst so gewählt, dass sich sehr unterschiedliche Standortprofile ergeben: Wiesbaden-Erbenheim ist stark bei den Mietkosten, Raunheim bei der Transportnähe, während Mainz-Hechtsheim bei den Fachkräften vorn liegt.
Gerade dieses Beispiel zeigt die Schwäche der additiven Nutzwertanalyse: Trotz klar unterschiedlicher Stärken- und Schwächenprofile können alle Alternativen denselben Gesamtnutzwert erreichen.
Qualitative Standortplanung
Nutzwertanalyse in R: Code und Ergebnistabelle
library(dplyr)
library(knitr)

# Tabelle mit Rohdaten der Fallstudie (drei Kriterien, gleich gewichtet)
nwa <- tibble(
  Kriterium = c(
    "Transportnaehe",
    "Mietkosten",
    "Fachkraefteverfuegbarkeit"
  ),
  Gewicht = c(1/3, 1/3, 1/3),
  `WI-Erb`  = c(5, 8, 2),
  `MZ-Hech` = c(2, 5, 8),
  Raunheim  = c(8, 2, 5)
)

# Berechne Nutzwerte der Standorte
nutzwert <- c(
    `WI-Erb`  = sum(nwa$Gewicht * nwa$`WI-Erb`),
    `MZ-Hech` = sum(nwa$Gewicht * nwa$`MZ-Hech`),
    Raunheim  = sum(nwa$Gewicht * nwa$Raunheim)
  )

# Verbinde Rohdaten und Nutzwerte in einer Tabelle
nwa <- bind_rows(nwa, nutzwert)

# Setze Namen Nutzwert in Zeile 4 und Spalte Kriterium
nwa$Kriterium[4] <- "Nutzwert"

# Gib Tabelle aus
nwa |>
  mutate(
    Gewicht = ifelse(is.na(Gewicht), "", sprintf("%.2f", Gewicht)), # Stelle 2 Nachkommastellen dar
    `WI-Erb` = sprintf("%.1f", `WI-Erb`),
    `MZ-Hech` = sprintf("%.1f", `MZ-Hech`),
    Raunheim = sprintf("%.1f", Raunheim)
  ) |>
  kable(
    col.names = c("Kriterium", "Gewichtung", "WI-Erb", "MZ-Hech", "Raunheim"),
    format = "html",
    align = c("l", "c", "c", "c", "c")
)| Kriterium | Gewichtung | WI-Erb | MZ-Hech | Raunheim |
|---|---|---|---|---|
| Transportnaehe | 0.33 | 5.0 | 2.0 | 8.0 |
| Mietkosten | 0.33 | 8.0 | 5.0 | 2.0 |
| Fachkraefteverfuegbarkeit | 0.33 | 2.0 | 8.0 | 5.0 |
| Nutzwert | 5.0 | 5.0 | 5.0 |
Qualitative Standortplanung
Analytical Hierarchy Process (AHP Methode)
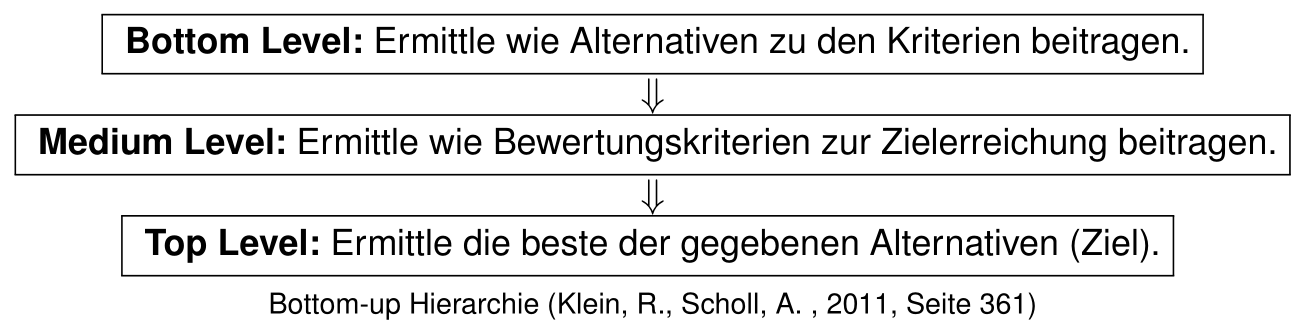
Ablauf
- Bilde paarweise Vergleiche zwischen allen Alternativen im Hinblick auf die Bewertungskriterien.
- Bilde für jedes Bewertungskriterium ein Alternativenranking (Synthese).
- Bilde paarweise Vergleiche zwischen allen Bewertungskriterien.
- Bilde ein Ranking der Bewertungskriterien (Synthese).
- Berechne den Scoring-Wert für die Alternativen.
Qualitative Standortplanung
Analytical Hierarchy Process (AHP Methode) - Beispiel
Fallbeispiel
SushiFresh vergleicht die drei Kandidatenstandorte Wiesbaden-Erbenheim (W-E), Mainz-Hechtsheim (M-H) und Raunheim (R) nun paarweise statt über direkt geschätzte Punktwerte. Folgende Bewertungskriterien werden herangezogen.
- Transportnähe: Distanz zu den sechs Filialen
- Mietkosten: jährliche Fixkosten des Grundstücks
- Fachkräfteverfügbarkeit: Zugang zu Gastronomie-/Lebensmittelfachkräften
Bewertungsskala
| Präferenz | Wert |
|---|---|
| Gleich | 1 |
| Gleich bis leicht bevorzugt | 2 |
| leicht bevorzugt | 3 |
| leicht bis deutlich bevorzugt | 4 |
| deutlich bevorzugt | 5 |
| deutlich bis stark bevorzugt | 6 |
| stark bevorzugt | 7 |
| Stark bis extrem bevorzugt | 8 |
| Extremely preferred | 9 |
Qualitative Standortplanung
Analytical Hierarchy Process (AHP Methode) - Beispiel
Ablauf
- Bilde paarweise Vergleiche zwischen allen Alternativen im Hinblick auf die Bewertungskriterien.
- Bilde für jedes Bewertungskriterium ein Alternativenranking (Synthese).
- Bilde paarweise Vergleiche zwischen allen Bewertungskriterien.
- Bilde ein Ranking der Bewertungskriterien (Synthese).
- Berechne den Scoring-Wert für die Alternativen.
Transportnähe
| site | W-E | M-H | R |
|---|---|---|---|
| W-E | 1 | 2 | 1/2 |
| M-H | 1/2 | 1 | 1/3 |
| R | 2 | 3 | 1 |
Mietkosten
| site | W-E | M-H | R |
|---|---|---|---|
| W-E | 1 | 2 | 4 |
| M-H | 1/2 | 1 | 2 |
| R | 1/4 | 1/2 | 1 |
Fachkräfte
| site | W-E | M-H | R |
|---|---|---|---|
| W-E | 1 | 1/7 | 2 |
| M-H | 7 | 1 | 5 |
| R | 1/2 | 1/5 | 1 |
Qualitative Standortplanung
Analytical Hierarchy Process (AHP Methode) - Beispiel
Ablauf
- Bilde paarweise Vergleiche zwischen allen Alternativen im Hinblick auf die Bewertungskriterien.
- Bilde für jedes Bewertungskriterium ein Alternativenranking (Synthese).
- Bilde paarweise Vergleiche zwischen allen Bewertungskriterien.
- Bilde ein Ranking der Bewertungskriterien (Synthese).
- Berechne den Scoring-Wert für die Alternativen.
Transportnähe — Synthese (Berechnung des größten Eigenvektors)
Spaltensummen
| site | W-E | M-H | R |
|---|---|---|---|
| W-E | 1 | 2 | 1/2 |
| M-H | 1/2 | 1 | 1/3 |
| R | 2 | 3 | 1 |
| \(\sum\) | 7/2 | 6 | 11/6 |
Normierung
| site | W-E | M-H | R |
|---|---|---|---|
| W-E | 2/7 | 1/3 | 3/11 |
| M-H | 1/7 | 1/6 | 2/11 |
| R | 4/7 | 1/2 | 6/11 |
| \(\sum\) | 1 | 1 | 1 |
Konsolidierung
| site | W-E | M-H | R | \(\varnothing\) |
|---|---|---|---|---|
| W-E | 0.29 | 0.33 | 0.27 | 0.297 |
| M-H | 0.14 | 0.17 | 0.18 | 0.163 |
| R | 0.57 | 0.50 | 0.55 | 0.540 |
| \(\sum\) | 1 | 1 | 1 | 1 |
Qualitative Standortplanung
Analytical Hierarchy Process (AHP Methode) - Beispiel
Ablauf
- Bilde paarweise Vergleiche zwischen allen Alternativen im Hinblick auf die Bewertungskriterien.
- Bilde für jedes Bewertungskriterium ein Alternativenranking (Synthese).
- Bilde paarweise Vergleiche zwischen allen Bewertungskriterien.
- Bilde ein Ranking der Bewertungskriterien (Synthese).
- Berechne den Scoring-Wert für die Alternativen.
Präferenzvektoren aller Standorte für alle Kriterien
| site | Transportnähe | Mietkosten | Fachkräfte |
|---|---|---|---|
| WI-Erb | 0.297 | 0.571 | 0.160 |
| MZ-Hech | 0.163 | 0.286 | 0.730 |
| Raunheim | 0.540 | 0.143 | 0.110 |
Qualitative Standortplanung
Analytical Hierarchy Process (AHP Methode) - Beispiel
Ablauf
- Bilde paarweise Vergleiche zwischen allen Alternativen im Hinblick auf die Bewertungskriterien.
- Bilde für jedes Bewertungskriterium ein Alternativenranking (Synthese).
- Bilde paarweise Vergleiche zwischen allen Bewertungskriterien.
- Bilde ein Ranking der Bewertungskriterien (Synthese).
- Berechne den Scoring-Wert für die Alternativen.
| Kriterium | Transportnähe | Mietkosten | Fachkräfte |
|---|---|---|---|
| Transportnähe | 1 | 3 | 2 |
| Mietkosten | 1/3 | 1 | 1/5 |
| Fachkräfte | 1/2 | 5 | 1 |
| \(\sum\) | 11/6 | 9 | 16/5 |
Qualitative Standortplanung
Analytical Hierarchy Process (AHP Methode) - Beispiel
Ablauf
- Bilde paarweise Vergleiche zwischen allen Alternativen im Hinblick auf die Bewertungskriterien.
- Bilde für jedes Bewertungskriterium ein Alternativenranking (Synthese).
- Bilde paarweise Vergleiche zwischen allen Bewertungskriterien.
- Bilde ein Ranking der Bewertungskriterien (Synthese).
- Berechne den Scoring-Wert für die Alternativen.
Nach demselben Verfahren (geometrisches Mittel der Zeilen, dann normieren) wie auf der vorherigen Folie für die Standorte ergibt sich für die drei Kriterien:
| Kriterium | Transportnähe | Mietkosten | Fachkräfte | \(\varnothing\) |
|---|---|---|---|---|
| Transportnähe | 6/11 | 1/3 | 10/16 | 0.501 |
| Mietkosten | 2/11 | 1/9 | 1/16 | 0.118 |
| Fachkräfte | 3/11 | 5/9 | 5/16 | 0.380 |
| \(\sum\) | 1 | 1 | 1 | 1 |
Qualitative Standortplanung
Analytical Hierarchy Process (AHP Methode) - Beispiel
Ablauf
- Bilde paarweise Vergleiche zwischen allen Alternativen im Hinblick auf die Bewertungskriterien.
- Bilde für jedes Bewertungskriterium ein Alternativenranking (Synthese).
- Bilde paarweise Vergleiche zwischen allen Bewertungskriterien.
- Bilde ein Ranking der Bewertungskriterien (Synthese).
- Berechne den Scoring-Wert für die Alternativen.
\(\left( \begin{array}{ccc} 0.297 & 0.571 & 0.160 \\ 0.163 & 0.286 & 0.730 \\ 0.540 & 0.143 & 0.110 \end{array} \right) \times \left( \begin{array}{c} 0.501\\ 0.118\\ 0.380 \end{array} \right) = \left( \begin{array}{c} 0.280\\ 0.390\\ 0.330 \end{array} \right) \begin{array}{c} \text{= Score WI-Erb}\\ \text{= Score MZ-Hech}\\ \text{= Score Raunheim} \end{array}\)
Ergebnis: Beste Alternative ist Mainz-Hechtsheim — allerdings nur knapp vor Raunheim!
Vorteile AHP
- Paarweises Vergleichen erhöht die Transparenz und vereinfacht die Rangbildung zwischen Alternativen.
- AHP bietet der “Voreingenommenheit” von Entscheidern weniger Angriffsfläche als die Nutzwertanalyse.
- Irrationale Beurteilungen der Entscheider können durch einen Konsistenzindex erfasst werden
Qualitative Standortplanung
Analytical Hierarchy Process (AHP Methode) - Konsistenzindex
- Produkt aus nicht-normalisierter Präferenzmatrix und Präferenzvektor (Kriterienvergleich): \[\left(\begin{array}{ccc} 1 & 3 & 2 \\ 1\!/\!3 & 1 & 1\!/\!5 \\ 1\!/\!2 & 5 & 1 \\ \end{array} \right)\times\left(\begin{array}{c} 0.501\\ 0.118\\ 0.380\\ \end{array}\right)=\left(\begin{array}{c} 1.615 \\ 0.361\\ 1.221\\ \end{array}\right)\]
- Dividiere den Vektor komponentenweise durch die Präferenzwerte: \[\begin{align*} 1.615 / 0.501 &= 3.224\\ 0.361 / 0.118 &= 3.059\\ 1.221 / 0.380 &= 3.212\\ \text{average }\bar{P} &= 3.165 \end{align*}\]
- Berechne den Konsistenzindex mit \(n=3\) durch \[ KI =\frac{\bar{P}- n}{n-1} = \frac{3.165-3}{2} = 0.082. \]
- Berechne die Konsistenzrate mit dem Random Index \(RI\) (für \(n=3\): \(RI = 0.58\)): \[ CR = \frac{KI}{RI} = \frac{0.082}{0.58} = 0.14. \]
Interpretation
\(\bar{P}\) ist der größte Eigenwert der Präferenzmatrix. Bei \(KI=0\) ist sie perfekt konsistent. Geprüft wird aber die Konsistenzrate: Faustregel \(CR < 0{,}1\). Mit \(CR \approx 0{,}14\) ist die Kriterienmatrix nicht hinreichend konsistent – die Paarvergleiche sollten überprüft werden.
\(RI\) nach Saaty: \(n=3\): 0,58; \(n=4\): 0,90; \(n=5\): 1,12
Strategische Gestaltung von Supply Chains
- Multikriterielle Standortplanung
- Kontinuierliche Standortplanung
- Diskrete Standortplanung
Kontinuierliche Standortplanung
Neoklassische Standorttheorie – Steiner-Weber-Modell
Annahmen
- Eine homogene Ebene (Absatzgebiet), in der sich eine endliche Anzahl von Kundenstandorten befindet.
- Nachfragemengen sind für jeden der Kundenstandorte gegeben und muss vollständig bedient werden.
- Eine Transportkostenfunktion, die von der Transportentfernung und der Transportmenge abhängt.
- Zeit wird nicht betrachtet
Ziel
Gesucht ist der transportkostenminimale Standort für eine Produktions-, Lager- oder Umschlagsstelle im Absatzgebiet — bei SushiFresh: der ideale Punkt im Rhein-Main-Gebiet für die neue Produktionsstätte, unabhängig von den drei konkret verfügbaren Grundstücken.
Kontinuierliche Standortplanung
Neoklassische Standorttheorie – Steiner-Weber-Modell
Modellformulierung
Bestimme Koordinaten \((x,y)\) im Absatzgebiet, die die gewichtete gesamte Transportdistanz zu den Kundenstandorten minimieren.
\[ \min\; Z(x,y) = \sum_{i=1}^{n} a_i \cdot d\big((x,y),(u_i,v_i)\big) \]
Entscheidungsvariable
- \((x,y)\): Koordinaten des zu bestimmenden Standorts.
Parameter
- \((u_i,v_i)\): Koordinaten von Kundenstandort \(i\).
- \(a_i\): Nachfrage von Kundenstandort \(i\), bei SushiFresh: Boxen pro Tag.
- \(d(\cdot)\): verwendetes Distanzmaß.
Distanzmaße
- Euklidische Distanz: \(d = \sqrt{(x-u_i)^2 + (y-v_i)^2}\)
- Manhattan-Distanz: \(d = |x-u_i| + |y-v_i|\)
- Straßendistanzen: kürzeste Wege in einem Verkehrsnetz.
Kontinuierliche Standortplanung
Steiner-Weber-Modell bei euklidischer Distanz
Iterativer Lösungsansatz
Für gegebene Kundenstandorte \((u_i,v_i)\) und Gewichte \(a_i\) gilt mit
\[ g_i(x,y)=\frac{a_i}{\sqrt{(x-u_i)^2+(y-v_i)^2}} \]
die Update-Regel
\[ x_{t+1}=\frac{\sum_{i=1}^n u_i\, g_i(x_t,y_t)}{\sum_{i=1}^n g_i(x_t,y_t)}, \qquad y_{t+1}=\frac{\sum_{i=1}^n v_i\, g_i(x_t,y_t)}{\sum_{i=1}^n g_i(x_t,y_t)}. \]
Weiszfeld-Algorithmus (vereinfacht)
- Wähle eine Startlösung \((x_0,y_0)\), z. B. den gewichteten Schwerpunkt.
- Berechne mit der Update-Regel einen neuen Standort.
- Wiederhole den Schritt bis die Änderung kleiner als eine Toleranz ist.
Umsetzung in R
steiner_weber_euclid <- function(data, x0 = NULL, y0 = NULL,
                                 tol = 1e-6, max_iter = 1000) {
  # data muss die Spalten u, v und a enthalten:
  # u = x-Koordinate der Kunden
  # v = y-Koordinate der Kunden
  # a = Nachfragegewicht

  stopifnot(all(c("u", "v", "a") %in% names(data)))

  # Startwert: gewichteter Schwerpunkt, falls nichts vorgegeben ist
  if (is.null(x0)) x0 <- sum(data$a * data$u) / sum(data$a)
  if (is.null(y0)) y0 <- sum(data$a * data$v) / sum(data$a)

  x <- x0
  y <- y0

  history <- data.frame(
    iter = 0,
    x = x,
    y = y,
    delta = NA_real_
  )

  for (t in 1:max_iter) {
    # Abstand des aktuellen Standorts zu jedem Kunden
    d <- sqrt((x - data$u)^2 + (y - data$v)^2)

    # Iterationsgewichte gemäß Weiszfeld-Algorithmus
    g <- data$a / d

    # Aktualisierung der Koordinaten
    x_new <- sum(data$u * g) / sum(g)
    y_new <- sum(data$v * g) / sum(g)

    # Änderung zwischen zwei Iterationen
    delta <- sqrt((x_new - x)^2 + (y_new - y)^2)

    history <- rbind(
      history,
      data.frame(iter = t, x = x_new, y = y_new, delta = delta)
    )

    # Abbruch bei hinreichend kleiner Änderung
    if (delta < tol) {
      return(list(
        x = x_new,
        y = y_new,
        iter = t,
        converged = TRUE,
        history = history
      ))
    }

    x <- x_new
    y <- y_new
  }

  list(
    x = x,
    y = y,
    iter = max_iter,
    converged = FALSE,
    history = history
  )
}
Hinweise
- Nahe Kunden mit hoher Nachfrage erhalten im Iterationsschritt ein hohes Gewicht \(\rightarrow\) Standort verschiebt sich in diese Richtung
- Startwert zweckmäßig: gewichteter Schwerpunkt.
- Abbruch: kleine Positionsänderung oder maximale Iterationszahl.
Kontinuierliche Standortplanung
Steiner-Weber-Modell bei euklidischer Distanz - Beispiel
Animation des Iterationsverlaufs
Eingabedaten
| Filiale | Standort (u_i,v_i) | Nachfrage a_i |
|---|---|---|
| Wiesbaden | (8.2398; 50.0782) | 120 |
| Mainz | (8.2711; 50.0000) | 150 |
| Frankfurt | (8.6821; 50.1109) | 280 |
| Ruesselsheim | (8.4116; 49.9904) | 90 |
| Darmstadt | (8.6512; 49.8728) | 110 |
| Offenbach | (8.7761; 50.0956) | 95 |
Iterationen
| Iteration t | Standort (x,y) | Abweichung |
|---|---|---|
| 0 | (8.7500; 49.8500) | --- |
| 1 | (8.5959; 50.0087) | 0.2212 |
| 2 | (8.5851; 50.0443) | 0.0372 |
| 3 | (8.5868; 50.0536) | 0.0095 |
| 4 | (8.5904; 50.0565) | 0.0046 |
| 5 | (8.5937; 50.0581) | 0.0037 |
Kontinuierliche Standortplanung
euklidisches Steiner-Weber-Modell — Short cut
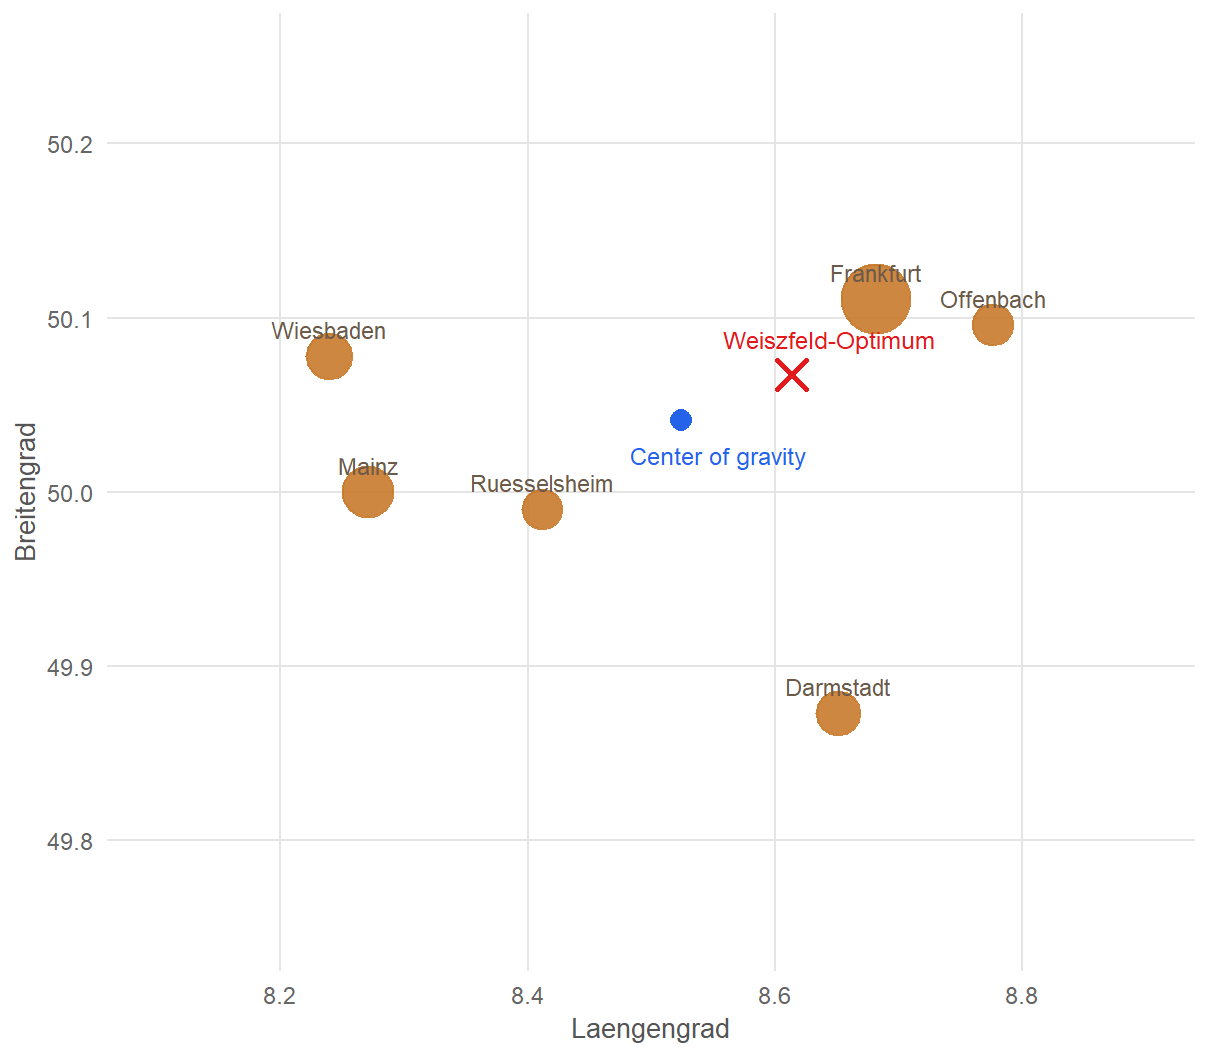
Center of gravity
Das Center of Gravity ist eine Schwerpunkt-Approximation des euklidischen Steiner-Weber-Problems (hier: Laengen-/Breitengrad naeherungsweise als planare Koordinaten behandelt):
\[ x^{CoG} = \frac{\sum_{i=1}^{n} a_i u_i}{\sum_{i=1}^{n} a_i}, \qquad y^{CoG} = \frac{\sum_{i=1}^{n} a_i v_i}{\sum_{i=1}^{n} a_i}. \] Für das SushiFresh-Beispiel gilt:
\[ (x^{CoG}, y^{CoG}) = (8.5241; 50.0410). \]
Das Center of Gravity ist schnell berechenbar, aber nur eine Approximation: Der iterative Steiner-Weber-Standort weist im Beispiel eine geringere nachfragegewichtete Gesamt-Haversine-Distanz auf (1.4016^{4} vs. 1.409^{4} Box-km).
Kontinuierliche Standortplanung
Steiner-Weber-Modell mit Manhattan-Distanzen
Steiner-Weber-Modell mit Manhattan-Distanzen
Bestimme Koordinaten \((x,y)\) im Absatzgebiet, die die gewichtete gesamte Transportdistanz zu den Kundenstandorten minimieren.
\[ \min \; Z(x,y) = \sum_{i=1}^{n} a_i \left( |x-u_i| + |y-v_i| \right) = \sum_{i=1}^{n} a_i |x-u_i| + \sum_{i=1}^{n} a_i |y-v_i| \]
Algorithmus für den optimalen Standort
Bestimme für jede Dimension den gewichteten Median — hier beispielhaft für die \(x\)-Koordinate (Längengrad):
- Sortiere die Filialen nach aufsteigenden \(u_i\)-Koordinaten.
- Bestimme die kumulierte Nachfrage \(A_j = \sum_{i=1}^{j} a_i\).
- Wähle den ersten Kunden mit \(A_j \geq \frac{1}{2}\sum_{i=1}^{n} a_i\).
- Seine \(u_i\)-Koordinate ist die optimale \(x\)-Koordinate.
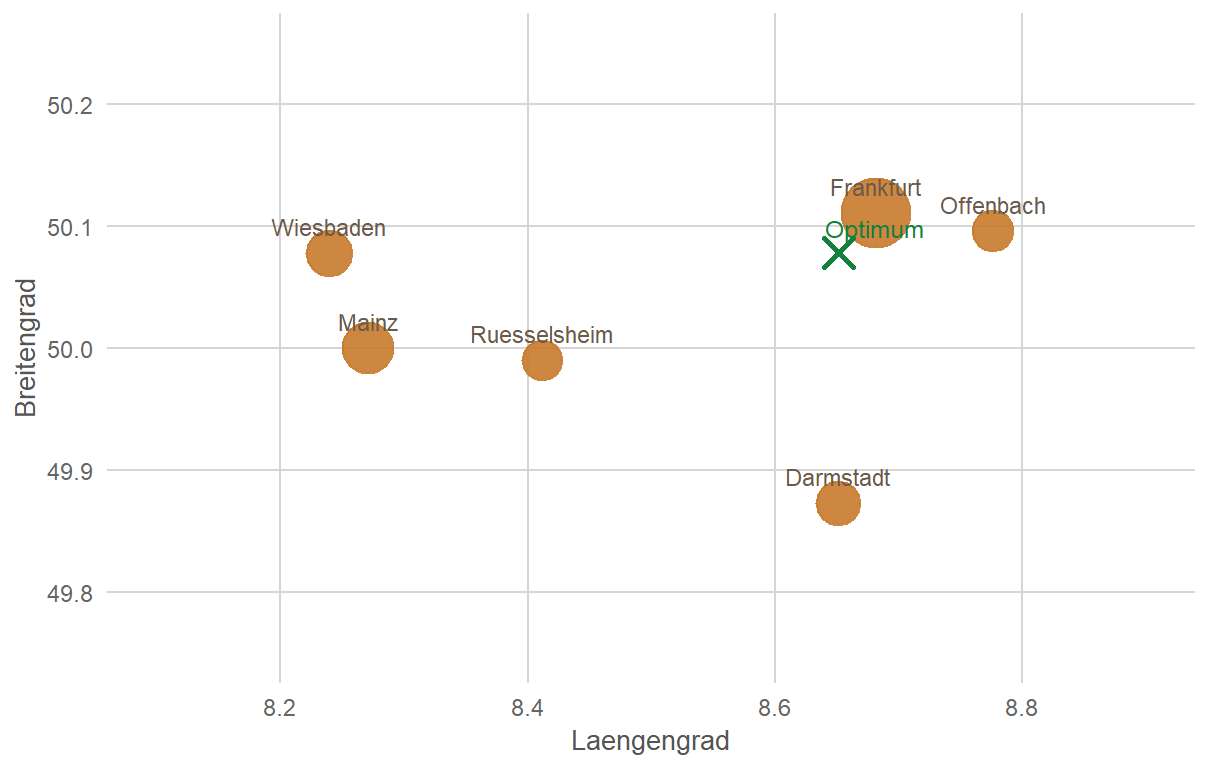
Für das SushiFresh-Beispiel ergibt sich: \[ (x^*, y^*) = (8.6512; 50.0782) \]
Strategische Gestaltung von Supply Chains - Warehouse Location Planning
Strategische Gestaltung von Supply Chains
- Multikriterielle Standortplanung
- Kontinuierliche Standortplanung
- Diskrete Standortplanung
- Transportplanung
Lernziele
Nach dieser Einheit können Sie …
- diskrete Standort- und Netzwerkplanungsprobleme formulieren,
- Transport-, Umschlags- und Standortentscheidungen in einem Netzwerk modellieren,
- zentrale Entscheidungsvariablen, Zielfunktionen und Nebenbedingungen interpretieren,
- Ergebnisse diskreter Netzwerkmodelle für strategische Standortentscheidungen bewerten.
Literatur zur Vertiefung
- Transport-, Umschlags- und Netzwerkmodelle: (Günther and Tempelmeier 2012, Kapitel 4).
- Diskrete Standortmodelle, Algorithmen und Anwendungen: Kapitel 1–4 in (Daskin 2013).
- Theorie und Anwendungen der Standortplanung: (Drezner and Hamacher 2002).
Planung von Distributionsnetzen
Einordnung
\(\rightarrow\) Wähle konkrete Standorte im Netzwerk aus \(\rightarrow\) in der Regel begrenzte Betrachtung der SC
Fallstudie – SushiFresh GmbH
Ausgangslage
Problemstellung
Die SushiFresh GmbH beliefert täglich sechs Supermarkt-Filialen im Rhein-Main-Gebiet mit frisch produzierten Sushi-Boxen. In Kapitel 4 wurde bereits eine qualitative Standortvorauswahl per AHP durchgeführt (Ergebnis: Mainz-Hechtsheim knapp vorn) sowie eine kontinuierliche Standortoptimierung (Center of Gravity/Weiszfeld). Nun stellt sich die Frage: Hält dieses Ergebnis auch einer kostenbasierten Prüfung stand?
Rückblick Kapitel 4
- AHP-Bewertung: Raunheim knapp vorn
- Center of Gravity / Weiszfeld: Optimalpunkt mitten im Rhein-Main-Gebiet, nahe Raunheim
- Offene Frage: Bestätigt eine Kostenoptimierung (Fixkosten + Transport) dieses Bild?
Fallstudie – SushiFresh GmbH
Entscheidungssituation
Entscheidungssituation
SushiFresh muss entscheiden, welcher der drei Kandidatenstandorte für Produktion und Distribution ausgebaut wird und welche Filiale von welchem Standort versorgt werden soll. Das Unternehmen möchte die Entscheidung so treffen, dass die jährlichen Gesamtkosten aus Fixkosten und Transport minimiert werden. Folgende Informationen sind bekannt:
Kandidatenstandorte und jährliche Fixkosten
| ID | Standort | Längengrad | Breitengrad | Fixkosten/Jahr (1000 €) |
|---|---|---|---|---|
| S1 | Wiesbaden-Erbenheim | 8.29990 | 50.06320 | 36 |
| S2 | Mainz-Hechtsheim | 8.28310 | 49.96980 | 42 |
| S3 | Raunheim | 8.46500 | 50.00000 | 52 |
| S4 | Höchst | 8.54218 | 50.11146 | 48 |
| S5 | Isenburg | 8.70720 | 50.05430 | 40 |
Transportdistanzen in km
| C1 | C2 | C3 | C4 | C5 | C6 | |
|---|---|---|---|---|---|---|
| S1 | 6.174 | 20.739 | 23.737 | 27.576 | 42.998 | 9.110 |
| S2 | 4.603 | 25.745 | 29.584 | 44.289 | 36.928 | 39.002 |
| S3 | 24.084 | 13.601 | 8.518 | 27.325 | 22.386 | 6.296 |
| S4 | 30.588 | 33.354 | 44.696 | 16.751 | 34.263 | 37.121 |
| S5 | 25.113 | 43.756 | 45.288 | 30.370 | 16.021 | 5.700 |
Filialen und tägliche Nachfrage
| ID | Filiale | Längengrad | Breitengrad | Nachfrage $\mu$ (Boxen/Tag) |
|---|---|---|---|---|
| C1 | Wiesbaden | 8.2398 | 50.0782 | 120 |
| C2 | Mainz | 8.2711 | 50.0000 | 150 |
| C3 | Frankfurt | 8.6821 | 50.1109 | 280 |
| C4 | Rüsselsheim | 8.4116 | 49.9904 | 90 |
| C5 | Darmstadt | 8.6512 | 49.8728 | 110 |
| C6 | Offenbach | 8.7761 | 50.0956 | 95 |
Warehouse Location Problem
Problembeschreibung
Problemstellung
Gegeben sei eine Menge an Kundenstandorten und eine Menge (potentieller) Lagerhausstandorte. Jeder Kundenstandort hat eine Warennachfrage (z.B. in Stück pro Monat/Jahr), die von den Lagerhäusern beliefert warden muss. Der Transport der Waren verursacht entfernungsabhängige Transportkosten. Die Eröffnung eines Lagerhauses verursacht Einrichtungskosten.
Es ist zu entscheiden, an welchen Standorten Lagerhäuser eingerichtet werden sollen und welche Kunden diese versorgen sollen.
Notation
- Menge der Lagerhäuser \(i \in I\)
- Menge der Kundenstandorte \(j \in J\)
- Transportverbindungen \(E \subseteq I \times J\)
- Eröffnungskosten an Lagerstandort \(i\): \(f_i\)
- Transportkosten (z.B. in €/Monat) Standort \(i\) zu Kunde \(j\): \(c_{ij}\)
- Nachfrage von Kunde \(j\): \(a_j\)
Warehouse Location Problem
Mathematisches Modell
Gemischt-ganzzahliges lineares Optimierungsmodell
Minimiere die Gesamtkosten aus Transport und Standorteröffnung
\[\min \rightarrow \sum_{i \in I} y_i \cdot f_i + \sum_{(i,j) \in E} x_{ij} \cdot c_{ij}\]
Nebenbedingungen \[ \begin{align} \sum_{(i,j) \in E} x_{ij} &= a_j & \forall j \in J &\quad\rightarrow \text{Nachfrage befriedigen} \\ x_{ij} &\leq y_i \cdot a_j & \forall (i,j) \in E &\quad\rightarrow \text{nur Transporte von eröffneten Standorten} \\ x_{ij} &\geq 0 & \forall (i,j) \in E &\quad\rightarrow \text{Transportmengen nicht negativ} \\ y_i &\in \{0,1\} & \forall i \in I &\quad\rightarrow \text{Standort wird eröffnet oder nicht} \end{align} \]
Warehouse Location Problem
Fallbeispiel
Standorte – Fixkosten \(f_i\) (€/Jahr)
| Standort i | f_i (€) |
|---|---|
| S1 | 36 000 |
| S2 | 42 000 |
| S3 | 52 000 |
| S4 | 48 000 |
| S5 | 40 000 |
Filialen – Nachfrage \(a_j\) (Boxen/Jahr)
| Filiale j | a_j |
|---|---|
| C1 | 120 000 |
| C2 | 150 000 |
| C3 | 280 000 |
| C4 | 90 000 |
| C5 | 110 000 |
| C6 | 95 000 |
Transportkosten \(c_{ij}\) (€/Box)
| C1 | C2 | C3 | C4 | C5 | C6 | |
|---|---|---|---|---|---|---|
| S1 | 0.123 | 0.415 | 0.475 | 0.552 | 0.860 | 0.182 |
| S2 | 0.092 | 0.515 | 0.592 | 0.886 | 0.739 | 0.780 |
| S3 | 0.482 | 0.272 | 0.170 | 0.546 | 0.448 | 0.126 |
| S4 | 0.612 | 0.667 | 0.894 | 0.335 | 0.685 | 0.742 |
| S5 | 0.502 | 0.875 | 0.906 | 0.607 | 0.320 | 0.114 |
Warehouse Location Problem
Implementierung mit R/OMPR
library(ompr)
library(ompr.roi)
library(ROI.plugin.glpk)

# Problemdaten
n_I <- 5; n_J <- 6
f   <- c(36000, 42000, 52000, 48000, 40000)
a   <- c(120000, 150000, 280000, 90000, 110000, 95000)
c_ij <- matrix(
  c(
    0.12348,    0.41478,    0.47474,    0.55152,    0.85996,    0.18220,
    0.09206,    0.51490,    0.59168,    0.88578,    0.73856,    0.78004,
    0.48168,    0.27202,    0.17036,    0.54650,    0.44772,    0.12592,
    0.61176,    0.66708,    0.89392,    0.33502,    0.68526,    0.74242,
    0.50226,    0.87512,    0.90576,    0.60740,    0.32042,    0.11400),
  nrow = n_I, byrow = TRUE)

# MILP-Modell
model <- MIPModel() |>
  # Variablen
  add_variable(y[i], i = 1:n_I, type = "binary") |>
  add_variable(x[i,j], i = 1:n_I, j = 1:n_J,
               type = "continuous", lb = 0) |>
  # Zielfunktion
  set_objective(
    sum_expr(f[i] * y[i], i = 1:n_I) +
    sum_expr(c_ij[i,j] * x[i,j],
             i = 1:n_I, j = 1:n_J),
    sense = "min") |>
  # NB1: Nachfrage vollständig befriedigen
  add_constraint(
    sum_expr(x[i,j], i = 1:n_I) == a[j],
    j = 1:n_J) |>
  # NB2: Transport nur von eröffneten Lagern
  add_constraint(
    x[i,j] <= y[i] * a[j],
    i = 1:n_I, j = 1:n_J)

result <- solve_model(model,
           with_ROI(solver = "glpk", verbose = FALSE))
OMPR – Workflow
MIPModel()→ leeres Modelladd_variable()→ Entscheidungsvariablenset_objective()→ Zielfunktionadd_constraint()→ Nebenbedingungensolve_model()→ Solver aufrufenget_solution()→ Lösung extrahieren
Warehouse Location Problem
Fallbeispiel – Optimale Lösung
| Standort $i$ | Filiale $j$ | Menge $x_{ij}$ (Boxen) | Transportkosten (€) |
|---|---|---|---|
| S1 | C1 | 120 000 | 14 817.6 |
| S3 | C2 | 150 000 | 40 803.0 |
| S3 | C3 | 280 000 | 47 700.8 |
| S3 | C4 | 90 000 | 49 185.0 |
| S3 | C5 | 110 000 | 49 249.2 |
| S3 | C6 | 95 000 | 11 962.4 |
| Kostenart | €/Jahr |
|---|---|
| Fixkosten | 88 000 |
| Transportkosten | 213 718 |
| Gesamtkosten Z* | 301 718 |
Warehouse Location Problem
Heuristische Lösungsverfahren - Grundideen
Warum Heuristiken?
Das WLP ist NP-schwer: exakte Solver (MILP) finden zwar optimale Lösungen, aber die Rechenzeit wächst exponentiell mit \(|I|\) und \(|J|\). Für große Praxisinstanzen sind konstruktive Heuristiken oft der einzig praktikable Ansatz.
Grundidee
- start mit einer zulässigen Lösung und versuche diese schrittweise zu verbessern
- Jeder Schritt: greedy – wähle die Änderung mit der größten Kostenreduktion
- Abbruch, wenn keine weitere Verbesserung möglich
- Kunden werden stets dem günstigsten offenen Lager zugeordnet
Zwei klassische Ansätze
| Methode | Ausgangspunkt | Richtung |
|---|---|---|
| Add-Heuristik | Keine Lager offen | Schrittweise hinzufügen |
| Drop-Heuristik | Alle Lager offen | Schrittweise schließen |
Grundideen Add/Drop - graphisch
Warehouse Location Problem
Add-Heuristik
Idee: Starte ohne geöffnetes Lager. Füge in jedem Schritt dasjenige Lager \(i^*\) hinzu, das die Gesamtkosten am stärksten reduziert.
Algorithmus
Initialisierung: \(S \leftarrow \emptyset\)
Wiederhole:
Berechne für jedes noch nicht geöffnete Lager \(i \notin S\) den Kostenbeitrag: \[\Delta_i = Z(S) - Z(S \cup \{i\})\]
Wähle \(i^* = \arg\max_{i \notin S} \Delta_i\)
Falls \(\Delta_{i^*} > 0\): öffne \(i^*\), setze \(S \leftarrow S \cup \{i^*\}\)
Sonst: Abbruch
Zuordnungsregel: Jeder Kunde \(j\) wird dem günstigsten offenen Lager zugeordnet: \(\sigma(j) = \arg\min_{i \in S} c_{ij}\)
Kostenberechnung
\[Z(S) = \underbrace{\sum_{i \in S} f_i}_{\text{Eröffnung}} + \underbrace{\sum_{j \in J} \min_{i \in S} c_{ij} \cdot a_j}_{\text{Transport}}\]
- Eigenschaft:
- Greedy, nicht garantiert optimal
- Transportkosten sinken von Schritt zu Schritt
- neues Lager wird eröffnet, wenn Eröffnungskosten < Transportkosteneinsparungen
Abbruchbedingung
Die Heuristik stoppt, sobald kein weiteres Lager die Gesamtkosten senkt.
Warehouse Location Problem
Drop-Heuristik
Idee: Starte mit allen Lagern geöffnet. Schließe in jedem Schritt dasjenige Lager \(i^*\), dessen Schließung die Gesamtkosten am stärksten reduziert.
Algorithmus
Initialisierung: \(S \leftarrow I\)
Wiederhole:
Berechne für jedes noch geöffnete Lager \(i \in S\) den Kostenbeitrag: \[\Delta_i = Z(S) - Z(S \setminus \{i\})\]
Wähle \(i^* = \arg\max_{i \in S} \Delta_i\)
Falls \(\Delta_{i^*} > 0\): schließe \(i^*\), setze \(S \leftarrow S \setminus \{i^*\}\)
Sonst: Abbruch
Zuordnungsregel: \(\sigma(j) = \arg\min_{i \in S} c_{ij}\)
Vergleich mit Add-Heuristik
| Merkmal | Add | Drop |
|---|---|---|
| Start | \(S = \emptyset\) | \(S = I\) |
| Richtung | aufbauend | abbauend |
| Startkosten | \(\infty\) (kein Lager) | \(\sum_i f_i + \ldots\) |
| Laufzeit | \(\mathcal{O}(|I|^2 \cdot |J|)\) | \(\mathcal{O}(|I|^2 \cdot |J|)\) |
| Tendenz | wenige Lager | mehr Lager |
Wichtig
Beide Heuristiken sind nicht garantiert optimal. Sie liefern zulässige Lösungen, die Lösungsqualität hängt stark von der Kostenstruktur der Instanz ab.
Warehouse Location Problem
Add-Heuristik – Fallbeispiel
| Schritt | Aktion | Offene Standorte | Fixkosten (€) | Transport (€) | Gesamt (€) |
|---|---|---|---|---|---|
| 1 | +S3 | {S3} | 52 000 | 256 702 | 308 702 |
| 2 | +S1 | {S1, S3} | 88 000 | 213 718 | 301 718 |
Filialzuordnung je Schritt:
| Schritt | C1 | C2 | C3 | C4 | C5 | C6 |
|---|---|---|---|---|---|---|
| 1 | S3 | S3 | S3 | S3 | S3 | S3 |
| 2 | S1 | S3 | S3 | S3 | S3 | S3 |
Ergebnis Add-Heuristik: Standort \(\{S1, S3\}\) geöffnet, \(Z_\text{Add} = 301 718\) €/Jahr
Warehouse Location Problem
Drop-Heuristik – Fallbeispiel
| Schritt | Aktion | Offene Standorte | Fixkosten (€) | Transport (€) | Gesamt (€) |
|---|---|---|---|---|---|
| 0 | Start | {S1, S2, S3, S4, S5} | 218 000 | 175 779.0 | 393 779.0 |
| 1 | -S2 | {S1, S3, S4, S5} | 176 000 | 179 549.4 | 355 549.4 |
| 2 | -S4 | {S1, S3, S5} | 128 000 | 198 582.6 | 326 582.6 |
| 3 | -S5 | {S1, S3} | 88 000 | 213 718.0 | 301 718.0 |
Filialzuordnung je Schritt:
| Schritt | C1 | C2 | C3 | C4 | C5 | C6 |
|---|---|---|---|---|---|---|
| 0 | S2 | S3 | S3 | S4 | S5 | S5 |
| 1 | S1 | S3 | S3 | S4 | S5 | S5 |
| 2 | S1 | S3 | S3 | S3 | S5 | S5 |
| 3 | S1 | S3 | S3 | S3 | S3 | S3 |
Ergebnis Drop-Heuristik: Standort \(\{S1, S3\}\) geöffnet, \(Z_\text{Drop} = 301 718\) €/Jahr — identisch zum Ergebnis der Add-Heuristik!
Warehouse Location Problem
Lösungsvergleich
| Kennzahl | Optimum (MILP) | Add-Heuristik | Drop-Heuristik |
|---|---|---|---|
| Geöffnete Standorte | S1, S3 | S1, S3 | S1, S3 |
| Anzahl Standorte | 2 | 2 | 2 |
| Fixkosten (€) | 36000 | 88000 | 88000 |
| Transportkosten (€) | 265718 | 213718 | 213718 |
| Gesamtkosten Z (€) | 301718 | 301718 | 301718 |
| Gap zum Optimum (%) | – | 0 % | 0 % |
In diesem Fallbeispiel finden Add-Heuristik und Drop-Heuristik unabhängig voneinander dieselbe, nachweislich optimale Lösung (\(Z = 301 718\) €/Jahr, nur Standort S1 = Wiesbaden-Erbenheim). Das ist keine Selbstverständlichkeit, zeigt hier aber den eindeutigen Kostenvorteil dieses Standorts.
Kostenvergleich
Qualitative vs. quantitative Standortbewertung
Diskussion
Widerspruch zu Kapitel 4?
Die AHP-Analyse aus Kapitel 4 favorisierte knapp Mainz-Hechtsheim. Die quantitative WLP-Analyse dieses Kapitels favorisiert Wiesbaden-Erbenheim und Raunheim. Wie passt das zusammen?
| Standort (Einzelbetrieb) | Fixkosten (€) | Transport (€/Jahr) | Gesamt (€/Jahr) |
|---|---|---|---|
| Wiesbaden-Erbenheim | 36 000 | 14 818 | 50 818 |
| Raunheim | 52 000 | 198 900 | 250 900 |
Raunheim und Wiesbaden-Erbenheim sind transportkostengünstiger, die Einsparungen kompensieren die höheren Fixkosten.
Fazit
- AHP (Kapitel 4): gut für erste Vorauswahl unter schwer quantifizierbaren, weichen Kriterien
- WLP (Kapitel 5): liefert die belastbare Kostenentscheidung, sobald harte Zahlen vorliegen
- Beide Verfahren ergänzen sich – keines ersetzt das andere
Strategische Gestaltung von Supply Chains - Transportplanung
Strategische Gestaltung von Supply Chains
- Multikriterielle Standortplanung
- Kontinuierliche Standortplanung
- Diskrete Standortplanung
- Transportplanung
Operative Distributionsplanung
Einordnung
| Planungsaufgabe | Leitfrage | Horizont | Modell |
|---|---|---|---|
| Standortplanung | Wo produzieren/lagern wir? | strategisch (Jahre) | WLP (MILP) |
| Transportplanung | Welche Quelle beliefert welche Senke mit welcher Menge? | taktisch/operativ (Wochen, Tage) | Transportproblem (LP) |
| Kürzeste Wege | Welcher Weg im Straßennetz ist der kürzeste? | operativ (Stammdaten, täglich) | Kürzeste-Wege-Problem |
| Tourenplanung | In welcher Reihenfolge fährt ein Fahrzeug seine Kunden an? | operativ (täglich) | TSP / VRP |
Roter Faden
Die Standortfrage für SushiFresh ist beantwortet: Von Raunheim und Wiesbaden-Erbenheim werden die sechs Filialen beliefert. Das WLP hat Standorte gewählt und Filialen zugeordnet. Was passiert, wenn die Standorte feststehen, aber Kapazitäten knapp werden?
Lernziele
Nach dieser Einheit können Sie …
- das klassische Transportproblem als lineares Optimierungsmodell formulieren,
- balancierte und unbalancierte Transportprobleme unterscheiden und durch Dummy-Knoten ausgleichen,
- Startlösungen mit der Nordwestecken-Regel und der Vogel’schen Approximationsmethode (VAM) berechnen,
- die Lösungsqualität heuristischer Verfahren im Vergleich zur LP-Optimallösung beurteilen.
Literatur zur Vertiefung
- Transport- und Netzwerkmodelle: (Günther and Tempelmeier 2012, Kapitel 4).
- Transportproblem und Lösungsverfahren (Tableau, VAM, MODI): (Domschke 2007).
- Ursprung der Vogel’schen Approximationsmethode: (Reinfeld and Vogel 1958).
Fallstudie – SushiFresh GmbH
Das Weihnachtsgeschäft
Ausgangslage
Im Normalbetrieb beliefern Raunheim und Wiesbaden-Erbenheim alle sechs Filialen. Die Planung für die Adventszeit steht an: Dann steigt die Nachfrage nach Sushi-Boxen um rund 40 %. Raunheim und Wiesbaden-Erbenheim können im Schichtbetrieb höchstens 850 Boxen/Tag produzieren (Raunheim: 450 Boxen/Tag, Wiesbaden-Erbenheim: 400 Boxen/Tag).
Idee der Geschäftsführung
Für vier Wochen wird daher in Neu-Isenburg eine temporäre Cateringküche angemietet, die eine Kapazität von 333 Boxen/Tag hat. Damit deckt die Gesamtkapazität die Adventsnachfrage genau.
Entscheidungsproblem
Die Standorte stehen fest, keine Standortentscheidung mehr. Offen ist nur: Welche Küche beliefert welche Filiale mit wie vielen Boxen, sodass die täglichen Transportkosten minimal sind?
Fallstudie – SushiFresh GmbH
Daten
Küchen und Kapazitäten \(s_i\) (Boxen/Tag)
| ID | Küche | Kapazität s_i |
|---|---|---|
| S3 | Raunheim | 450 |
| S1 | Wiesbaden-Erbenheim | 400 |
| S5 | Neu-Isenburg | 333 |
Filialen und Nachfrage \(a_j\) im Dezember (Boxen/Tag)
| ID | Filiale | Normal μ_j | Dezember a_j |
|---|---|---|---|
| C1 | Wiesbaden | 120 | 168 |
| C2 | Mainz | 150 | 210 |
| C3 | Frankfurt | 280 | 392 |
| C4 | Rüsselsheim | 90 | 126 |
| C5 | Darmstadt | 110 | 154 |
| C6 | Offenbach | 95 | 133 |
Transportkosten \(c_{ij}\) (€/Box, aus Einheit Standortplanung II)
| Küche | C1 | C2 | C3 | C4 | C5 | C6 |
|---|---|---|---|---|---|---|
| S3 | 0.482 | 0.272 | 0.170 | 0.546 | 0.448 | 0.126 |
| S1 | 0.123 | 0.415 | 0.475 | 0.552 | 0.860 | 0.182 |
| S5 | 0.502 | 0.875 | 0.906 | 0.607 | 0.320 | 0.114 |
Bilanz
Gesamtkapazität \(\sum_i s_i =\) 1183 Boxen, Gesamtnachfrage \(\sum_j a_j =\) 1183 Boxen → Angebot und Nachfrage sind ausgeglichen.
Transportproblem
Problembeschreibung
Problemstellung
Gegeben sind \(m\) Quellen (z. B. Werke, Küchen, Lager) mit Angebotsmengen und \(n\) Senken (z. B. Kunden, Filialen) mit Nachfragemengen. Für jede Verbindung fallen Transportkosten je Einheit an. Gesucht ist ein kostenminimaler Transportplan, der die Nachfrage deckt und die Angebotsmengen nicht überschreitet.
Notation
- Quellen \(i \in I\) mit Angebot \(s_i\)
- Senken \(j \in J\) mit Nachfrage \(a_j\)
- Transportkosten je Einheit von \(i\) nach \(j\): \(c_{ij}\)
- Entscheidungsvariable: Transportmenge \(x_{ij} \geq 0\)
Unterschied zum WLP (Einheit Standortplanung II)
- keine Standortentscheidung \(y_i\) – alle Quellen sind „geöffnet“
- dafür Kapazitäten \(s_i\) der Quellen
- keine Fixkosten, nur variable Transportkosten
Transportproblem
Mathematisches Modell
Lineares Optimierungsmodell (Hitchcock 1941)
Minimiere die gesamten Transportkosten
\[\min \rightarrow \sum_{i \in I} \sum_{j \in J} c_{ij} \cdot x_{ij}\]
Nebenbedingungen \[ \begin{align} \sum_{j \in J} x_{ij} &\leq s_i & \forall i \in I &\quad\rightarrow \text{Kapazität nicht überschreiten} \\ \sum_{i \in I} x_{ij} &= a_j & \forall j \in J &\quad\rightarrow \text{Nachfrage decken} \\ x_{ij} &\geq 0 & \forall i, j &\quad\rightarrow \text{keine negativen Mengen} \end{align} \]
Eigenschaften
- Balanciert, wenn \(\sum_i s_i = \sum_j a_j\) → alle Kapazitätsrestriktionen gelten mit „\(=\)“
- reines LP (keine Binärvariablen) → effizient exakt lösbar
- ganzzahlige \(s_i, a_j\) → ganzzahlige Optimallösung (Nebenbedingungsmatrix total unimodular)
- eine Basislösung hat höchstens \(m + n - 1\) positive Transportmengen
Für SushiFresh: \(m + n - 1 = 3 + 6 - 1 = 8\) genutzte Verbindungen von 18 möglichen.
Transportproblem
Lösungsverfahren im Überblick
Eröffnungsverfahren
Konstruieren eine zulässige Startlösung mit höchstens \(m+n-1\) Transporten:
- Nordwestecken-Regel – ignoriert die Kosten
- Matrixminimum-Methode – beliefert stets die insgesamt günstigste freie Zelle
- Vogel’sche Approximationsmethode (VAM) – berücksichtigt Opportunitätskosten
Verbesserungs- und exakte Verfahren
- Stepping-Stone- bzw. MODI-Methode: verbessern eine Startlösung schrittweise bis zum Optimum (Tableau-Varianten des Simplex-Verfahrens)
- LP-Solver (z. B.
glpküberompr): lösen das Modell direkt exakt
Warum Eröffnungsverfahren heute noch?
Sie sind per Hand nachvollziehbar, liefern in Sekundenbruchteilen gute Lösungen und dienen als Startlösung für Verbesserungsverfahren. Die Logik von VAM – „Wo wäre ein Fehler am teuersten?“ – ist zudem ein nützliches Denkmuster für Disponenten.
Nordwestecken-Regel
Kosten werden ignoriert
Algorithmus
- Starte in der linken oberen Zelle (Zeile 1, Spalte 1).
- Transportiere \(x_{ij} = \min(\text{Restangebot}_i, \text{Restnachfrage}_j)\).
- Ist das Angebot von \(i\) erschöpft → eine Zeile nach unten, sonst eine Spalte nach rechts.
- Wiederhole, bis alle Nachfrage gedeckt ist.
Schwäche
Die Reihenfolge der Zeilen/Spalten bestimmt die Lösung, nicht die Kosten.
Nordwestecken-Lösung für SushiFresh (Boxen/Tag)
| Küche | C1 | C2 | C3 | C4 | C5 | C6 |
|---|---|---|---|---|---|---|
| S3 | 168 | 210 | 72 | – | – | – |
| S1 | – | – | 320 | 80 | – | – |
| S5 | – | – | – | 46 | 154 | 133 |
Transportkosten: 438,80 €/Tag
Beispiel: Die Filiale Wiesbaden (C1) wird komplett aus Raunheim beliefert (0,482 €/Box), obwohl die Küche Wiesbaden-Erbenheim mit 0,123 €/Box fast viermal günstiger wäre.
Vogel’sche Approximationsmethode
Idee: Opportunitätskosten
Idee: Beliefere zuerst dort, wo eine falsche Entscheidung am teuersten wäre. Maß dafür ist die Strafkosten-Differenz (penalty) \(\Delta\) einer Zeile oder Spalte: die Differenz zwischen der zweitgünstigsten und der günstigsten noch verfügbaren Zelle.
Beispiel: Spalte C1 (Filiale Wiesbaden)
| Küche | c_i,C1 (€/Box) |
|---|---|
| S1 | 0.123 |
| S3 | 0.482 |
| S5 | 0.502 |
\(\Delta_{C1} = 0.482 - 0.123 = 0.358\) €/Box
Interpretation
Kann Wiesbaden nicht aus der günstigsten Küche (S1) beliefert werden, kostet jede Box mindestens 0,358 € mehr.
Bei 168 Boxen/Tag sind das bis zu 60,18 € Opportunitätskosten pro Tag.
→ Zeilen/Spalten mit großem \(\Delta\) werden zuerst bedient.
Vogel’sche Approximationsmethode
Algorithmus
Initialisierung: Alle Zeilen und Spalten sind aktiv; Restangebot \(s_i\), Restnachfrage \(a_j\).
Wiederhole, solange aktive Zeilen und Spalten existieren:
Berechne für jede aktive Zeile \(i\) und jede aktive Spalte \(j\) die Strafkosten-Differenz: \[\Delta = c_{(2)} - c_{(1)}\] (zweitkleinste minus kleinste Kosten unter den aktiven Zellen)
Wähle die Zeile oder Spalte mit dem größten \(\Delta\).
Wähle darin die günstigste aktive Zelle \((i^*, j^*)\).
Transportiere \(x_{i^*j^*} = \min(s_{i^*}, a_{j^*})\) und aktualisiere Restangebot und Restnachfrage.
Streiche die erschöpfte Zeile bzw. Spalte.
Hinweise
- Bei Gleichstand von \(\Delta\): beliebige Wahl (z. B. die Zeile/Spalte mit der günstigeren Zelle)
- Bleibt nur eine Zelle in einer Zeile/Spalte, ist \(\Delta = 0\) – die Zuordnung ist dann ohnehin erzwungen
- Nach höchstens \(m + n - 1\) Iterationen ist eine zulässige Lösung gefunden
Aber
VAM ist eine Heuristik: gute, aber nicht garantiert optimale Lösungen.
Vogel’sche Approximationsmethode
Fallbeispiel – Iteration 1
| C1 | C2 | C3 | C4 | C5 | C6 | si (Rest) | Δ Zeile | |
|---|---|---|---|---|---|---|---|---|
| S3 | 0.482 | 0.272 | 0.170 | 0.546 | 0.448 | 0.126 | 450 | 0.044 |
| S1 | 0.123 → 168 | 0.415 | 0.475 | 0.552 | 0.860 | 0.182 | 400 | 0.059 |
| S5 | 0.502 | 0.875 | 0.906 | 0.607 | 0.320 | 0.114 | 333 | 0.206 |
| aj (Rest) | 168 | 210 | 392 | 126 | 154 | 133 | ||
| Δ Spalte | 0.358 | 0.143 | 0.304 | 0.005 | 0.127 | 0.012 |
Zeilen: z. B. Raunheim (S3): günstigste Zellen C6 (0.126) und C3 (0.170) → \(\Delta_{S3} = 0.044\)
Spalten: z. B. Wiesbaden (C1): \(\Delta_{C1} = 0.358\) → größtes \(\Delta\) im gesamten Tableau
Entscheidung
Günstigste Zelle in Spalte C1: S1 → C1. Menge \(\min(400, 168) = 168\) Boxen. Nachfrage von C1 ist gedeckt → Spalte C1 streichen.
Vogel’sche Approximationsmethode
Fallbeispiel – Iteration 2
| C1 | C2 | C3 | C4 | C5 | C6 | si (Rest) | Δ Zeile | |
|---|---|---|---|---|---|---|---|---|
| S3 | 0.482 | 0.272 | 0.170 → 392 | 0.546 | 0.448 | 0.126 | 450 | 0.044 |
| S1 | 0.123 [168] | 0.415 | 0.475 | 0.552 | 0.860 | 0.182 | 232 | 0.233 |
| S5 | 0.502 | 0.875 | 0.906 | 0.607 | 0.320 | 0.114 | 333 | 0.206 |
| aj (Rest) | 0 | 210 | 392 | 126 | 154 | 133 | ||
| Δ Spalte | – | 0.143 | 0.304 | 0.005 | 0.127 | 0.012 |
Durch das Streichen von C1 ändert sich die Strafkosten-Differenz von S1: Die günstigste Zelle (C1) fällt weg, neu ist \(\Delta_{S1} = 0.233\).
Die Penalties müssen daher in jeder Iteration neu berechnet werden.
Entscheidung
Größtes \(\Delta\): Spalte C3 (Frankfurt, \(\Delta = 0.304\)). Günstigste Zelle: S3 → C3, Menge \(\min(450, 392) = 392\). Spalte C3 streichen.
Vogel’sche Approximationsmethode
Fallbeispiel – Iteration 3
| C1 | C2 | C3 | C4 | C5 | C6 | si (Rest) | Δ Zeile | |
|---|---|---|---|---|---|---|---|---|
| S3 | 0.482 | 0.272 | 0.170 [392] | 0.546 | 0.448 | 0.126 | 58 | 0.146 |
| S1 | 0.123 [168] | 0.415 | 0.475 | 0.552 | 0.860 | 0.182 → 133 | 232 | 0.233 |
| S5 | 0.502 | 0.875 | 0.906 | 0.607 | 0.320 | 0.114 | 333 | 0.206 |
| aj (Rest) | 0 | 210 | 0 | 126 | 154 | 133 | ||
| Δ Spalte | – | 0.143 | – | 0.005 | 0.127 | 0.012 |
Entscheidung
Erstmals ist eine Zeile ausschlaggebend: Wiesbaden-Erbenheim (S1) hat mit \(\Delta = 0.233\) das größte Penalty. Die günstigste verbleibende Zelle ist S1 → C6 (Offenbach). Menge \(\min(232, 133) = 133\) → Nachfrage von Offenbach gedeckt, Spalte C6 streichen. S1 bleibt mit Restangebot 99 Boxen aktiv.
Vogel’sche Approximationsmethode
Fallbeispiel – alle Iterationen
| It. | max. Δ in | Δ | Zelle | Menge | Kosten (€) | gestrichen |
|---|---|---|---|---|---|---|
| 1 | Spalte C1 | 0.358 | S1 → C1 | 168 | 20,74 | C1 |
| 2 | Spalte C3 | 0.304 | S3 → C3 | 392 | 66,78 | C3 |
| 3 | Zeile S1 | 0.233 | S1 → C6 | 133 | 24,23 | C6 |
| 4 | Zeile S5 | 0.287 | S5 → C5 | 154 | 49,34 | C5 |
| 5 | Zeile S3 | 0.274 | S3 → C2 | 58 | 15,78 | S3 |
| 6 | Spalte C2 | 0.460 | S1 → C2 | 99 | 41,06 | S1 |
| 7 | Zeile S5 | 0.268 | S5 → C4 | 126 | 76,53 | C4 |
| 8 | Zeile S5 | 0.000 | S5 → C2 | 53 | 46,38 | S5, C2 |
Beobachtungen
- Genau \(m + n - 1 = 8\) Iterationen bzw. Transporte
- Die teuren Fehlentscheidungen (Wiesbaden, Frankfurt) werden zuerst vermieden
- In der letzten Iteration ist \(\Delta = 0\): Die Zuordnung ist durch die Restmengen erzwungen
Vogel’sche Approximationsmethode
Fallbeispiel – Ergebnis
VAM-Transportplan (Boxen/Tag)
| Küche | C1 | C2 | C3 | C4 | C5 | C6 |
|---|---|---|---|---|---|---|
| S3 | – | 58 | 392 | – | – | – |
| S1 | 168 | 99 | – | – | – | 133 |
| S5 | – | 53 | – | 126 | 154 | – |
Transportkosten: 340,86 €/Tag gegenüber 438,80 €/Tag mit der Nordwestecken-Regel.
Zulässigkeit: Zeilensummen 450 / 400 / 333 = Kapazitäten, Spaltensummen = Nachfrage.
Transportproblem
Implementierung mit R
# Heuristik (scm_functions.R)
vam <- vogels_approximation(tp_cost,
                            supply = tp_supply,
                            demand = tp_demand)

# Exakte Lösung als LP mit ompr
library(ompr); library(ompr.roi)
library(ROI.plugin.glpk)
m <- nrow(tp_cost); n <- ncol(tp_cost)

tp_model <- MIPModel() |>
  add_variable(x[i, j], i = 1:m, j = 1:n,
               type = "continuous", lb = 0) |>
  set_objective(
    sum_expr(tp_cost[i, j] * x[i, j],
             i = 1:m, j = 1:n), "min") |>
  # Kapazitäten
  add_constraint(
    sum_expr(x[i, j], j = 1:n) <= tp_supply[i],
    i = 1:m) |>
  # Nachfrage
  add_constraint(
    sum_expr(x[i, j], i = 1:m) == tp_demand[j],
    j = 1:n)

tp_opt <- solve_model(tp_model, with_ROI(solver = "glpk"))| Verfahren | Kosten (€/Tag) | Abw. vom Optimum |
|---|---|---|
| Nordwestecke | 438,80 | 44,9 % |
| VAM | 340,86 | 12,5 % |
| LP-Optimum | 302,92 | 0,0 % |
Optimaler Transportplan (Boxen/Tag)
| Küche | C1 | C2 | C3 | C4 | C5 | C6 |
|---|---|---|---|---|---|---|
| S3 | – | 58 | 392 | – | – | – |
| S1 | 168 | 152 | – | 80 | – | – |
| S5 | – | – | – | 46 | 154 | 133 |
Transportproblem
Vergleich der Lösungen
Ergebnis
- VAM liegt 12,5 % über dem Optimum, die Nordwestecke 45 %.
- Der Unterschied VAM ↔︎ Optimum liegt allein in der Aufteilung von Mainz (C2), Rüsselsheim (C4) und Offenbach (C6) zwischen Wiesbaden-Erbenheim und Neu-Isenburg.
Hochgerechnet
Über vier Adventswochen (24 Liefertage) spart der optimale Plan gegenüber der Nordwestecke rund 3.261 €. Gegenüber VAM sind es nur 911 €.
Unbalancierte Transportprobleme
Dummy-Quellen und Dummy-Senken
Überkapazität \(\sum_i s_i > \sum_j a_j\)
- Einführung einer Dummy-Senke mit Nachfrage \(\sum_i s_i - \sum_j a_j\) und Kosten \(c_{i,\text{Dummy}} = 0\)
- Lieferungen an die Dummy-Senke = ungenutzte Kapazität
Unterkapazität \(\sum_i s_i < \sum_j a_j\)
- Einführung einer Dummy-Quelle mit Angebot \(\sum_j a_j - \sum_i s_i\)
- Kosten = Fehlmengenkosten (z. B. entgangener Deckungsbeitrag, vgl. Newsvendor)
- Lieferungen der Dummy-Quelle = nicht belieferte Nachfrage
Variante: Neu-Isenburg bietet 350 statt 333 Boxen/Tag → 17 Boxen Überkapazität
| Küche | C1 | C2 | C3 | C4 | C5 | C6 | Dummy |
|---|---|---|---|---|---|---|---|
| S3 | – | 58 | 392 | – | – | – | – |
| S1 | 168 | 82 | – | – | – | 133 | 17 |
| S5 | – | 70 | – | 126 | 154 | – | – |
vogels_approximation() ergänzt die Dummy-Spalte automatisch. Kosten: 348,68 €/Tag.
Dummy-Kosten von 0 verändern die Strafkosten-Differenzen. VAM kann daher bei unbalancierten Problemen deutlich schlechter abschneiden. Das LP liefert immer das Optimum.
Transportproblem
Grenzen des Modells und Ausblick
Annahme 1: Kosten \(c_{ij}\) sind gegeben
Bisher wurden die Transportkosten je Box vorgegeben. In der Praxis müssen sie aus Entfernungen im Straßennetz abgeleitet werden.
→ Kürzeste-Wege-Probleme (Einheit Kürzeste Wege)
Annahme 2: Kosten sind linear in der Menge
Das Modell unterstellt Direktverkehre (Pendelfahrten) mit Kosten proportional zur Menge. Tatsächlich fährt ein Kühlfahrzeug mehrere Filialen nacheinander an, und die Kosten hängen von der Fahrstrecke ab.
→ Tourenplanung / TSP (Einheit Tourenplanung)
Weitere Erweiterungen
Umschlagpunkte (Transshipment), mehrere Produkte, Kapazitäten auf Verbindungen, Mindestmengen je Fahrt (dann MILP).
Kernaussagen
Das Wichtigste in Kürze
- Das Transportproblem verteilt Angebotsmengen kostenminimal auf Nachfragemengen. Es ist ein LP mit ganzzahligen Optimallösungen.
- Unbalancierte Probleme werden über Dummy-Quellen bzw. -Senken ausgeglichen.
- Die Nordwestecken-Regel ist einfach, ignoriert aber die Kosten.
- Die Vogel’sche Approximationsmethode priorisiert Zeilen/Spalten mit hohen Opportunitätskosten und liefert meist Lösungen nahe am Optimum (SushiFresh: +12,5 %).
- Mit
omprlässt sich das Transportproblem in wenigen Zeilen exakt lösen.
Übung
Übungsaufgaben zu dieser Einheit
Aufgaben zur Klausurvorbereitung (Teil 1) und eine vertiefende Fallstudie (Teil 2) finden Sie in Fallstudie 3: Diskrete Standortplanung und Transportplanung.
Unsicherheits- und Risikomanagement in Supply Chains
Unsicherheit in Supply Chains
- Pooling
- Newsvendor-Modell
- Bullwhip-Effekt
Lernziele
Nach dieser Einheit können Sie …
- Quellen und Auswirkungen von Unsicherheit in Supply Chains erläutern,
- Nachfrageunsicherheit, implizierte Unsicherheit und Reaktionsfähigkeit voneinander abgrenzen,
- den Effekt von Risikopooling auf Nachfragevarianz und Sicherheitsbestände analysieren,
- zentrale und dezentrale Bestandsstrukturen unter Unsicherheit vergleichen und beurteilen.
Literatur zur Vertiefung
- Pooling, Nachfragevariabilität und Bestandsentscheidungen: (Cachon and Terwiesch 2024, Kapitel 10–13).
- Sicherheitsbestände, Servicegrade und Inventory-Management: (Silver et al. 2017, Kapitel 6–8).
Die Natur der Unsicherheit
Implizierte Unsicherheit in Supply Chains (Chopra and Meindl 2025)
Implizierte Unsicherheit (implied uncertainty) bezeichnet die Unsicherheit, mit der eine Supply Chain umgehen muss — bestimmt durch die Kombination aus Nachfrageunsicherheit und den Serviceanforderungen des Marktes (Chopra and Meindl 2025, Kap. 2).
Zwei Quellen implizierter Unsicherheit
| Dimension | Niedrig | Hoch |
|---|---|---|
| Nachfrageunsicherheit | Salz, Strom | Fashion, Elektronik |
| Liefervariabilität | Beton, Kohle | Halbleiter, Fischfang |
\(\rightarrow\) Hohe implizierte Unsicherheit erfordert reaktionsfähige (responsive) Supply Chains mit Pufferkapazität.
Das Grunddilemma
- Nachfrage ist variabel und schwer vorhersagbar
- Kapazitäten (Werke, Lager, Personal) werden im Voraus festgelegt
- \(\rightarrow\) Mismatch zwischen Angebot und Nachfrage ist strukturell unvermeidlich
Die Natur der Unsicherheit
Mismatch: Schwankende Nachfrage vs. fixe Kapazität
Kapazitäten (Maschinen, Personal, Lagerraum) werden ex ante bestimmt. Die Nachfrage realisiert sich ex post. Das Ergebnis: systematischer Mismatch in beide Richtungen.
Konsequenzen des Mismatches
| Szenario | Phänomen | Folge |
|---|---|---|
| \(d > C\) | Überlastung | Lost Sales, Umsatzverlust |
| \(d < C\) | Unterauslastung | Leerkosten |
| \(d \approx C\) | Gleichgewicht | bei perfekter Prognose |
Praxisbeispiele
- Automobilindustrie: Werke produzieren nur bestimmte Modelle für mehrere Jahre \(\rightarrow\) Auslastung hängt von Nachfrage ab
- Einzelhandel: Saisonware (Weihnachtsartikel) wird zu früh bestellt, Reste werden verramscht
- Krankenhaus: OP-Kapazitäten sind täglich fix, Notfallaufkommen ist hochvariabel
Umgang mit Unsicherheit
Kapazitätspooling
Ausgangssituation (Struktur nach Cachon & Terwiesch, Kap. 17)
In der Gründungsphase betrieb SushiFresh zunächst nur 2 Pilotküchen für 2 Pilotstandorte (die heutigen Filialen Wiesbaden und Mainz). Jede Küche ist genau ihrem eigenen Standort zugeordnet – keine Flexibilität. Die Kapazität je Küche beträgt 90 Boxen/Tag. Die Nachfrage ist unsicher und wird beobachtet, nachdem die Kapazitäten festgelegt wurden.
Konsequenzen der Inflexibilität
- Übersteigt die Nachfrage die Kapazität \(\rightarrow\) Fehlmenge (Lost Sales)
- Liegt die Nachfrage unter der Kapazität \(\rightarrow\) Leerkapazität (Idle Capacity)
- Beide Effekte reduzieren die Systemperformance
Kapazitätspooling
Originalkonfiguration – Jede Küche beliefert nur ihre zugewiesene Filiale
Monatliche Nachfrage und Produktion, Pilotphase (\(C^{Wi} = C^{Ma} = 90\))
| Monat | dtWi | dtMa | xtWi | xtMa |
|---|---|---|---|---|
| 1 | 78 | 102.0 | 78.00 | 90.00 |
| 2 | 79 | 92.0 | 79.00 | 90.00 |
| 3 | 92 | 93.0 | 90.00 | 90.00 |
| 4 | 76 | 87.0 | 76.00 | 87.00 |
| 5 | 95 | 80.0 | 90.00 | 80.00 |
| 6 | 104 | 97.0 | 90.00 | 90.00 |
| 7 | 87 | 90.0 | 87.00 | 90.00 |
| 8 | 92 | 76.0 | 90.00 | 76.00 |
| 9 | 91 | 89.0 | 90.00 | 89.00 |
| 10 | 85 | 86.0 | 85.00 | 86.00 |
| 11 | 96 | 89.0 | 90.00 | 89.00 |
| 12 | 93 | 93.0 | 90.00 | 90.00 |
| ⌀ | 89 | 89.5 | 86.25 | 87.25 |
System Evaluation
- Erwartete Nachfrage: \(E(d^{Wi})=\) 89; \(E(d^{Ma})=\) 89.5
- Erwartete Produktion: \(E(x^{Wi})=\) 86.2; \(E(x^{Ma})=\) 87.2
- Auslastung Standorte: \(\frac{E(x^{Wi})}{C^{Wi}}=\) 95.8 %; \(\frac{E(x^{Ma})}{C^2}=\) 96.9 %
- Erwarteter Lieferservicegrad: \(\frac{E(x^{Wi})}{E(d^{Wi})}=\) 97.2 %; \(\frac{E(x^{Ma})}{E(d^{Ma})}=\) 97.7 %
Problem
Auslastung und Lieferservicegrad sind hoch, dennoch gibt es lost sales und Unterauslastung \(\rightarrow\) Kann gegenseitiges Aushelfen (Kapazitätspooling) die Kennzahlen verbessern?
Kapazitätspooling
Einseitiges Pooling – Küche Wiesbaden kann beide Standorte beliefern
| Monat | dtWi | dtMa | xtWi,Wi | xtWi,Ma | xt2B |
|---|---|---|---|---|---|
| 1 | 78 | 102 | 78 | 12 | 90 |
| 2 | 79 | 92 | 79 | 2 | 90 |
| 3 | 92 | 93 | 90 | 0 | 90 |
| 4 | 76 | 87 | 76 | 0 | 87 |
| 5 | 95 | 80 | 90 | 0 | 80 |
| 6 | 104 | 97 | 90 | 0 | 90 |
| 7 | 87 | 90 | 87 | 0 | 90 |
| 8 | 92 | 76 | 90 | 0 | 76 |
| 9 | 91 | 89 | 90 | 0 | 89 |
| 10 | 85 | 86 | 85 | 0 | 86 |
| 11 | 96 | 89 | 90 | 0 | 89 |
| 12 | 93 | 93 | 90 | 0 | 90 |
Pooling-Regel (wenn \(d_t^{Ma} > C^{Ma}\) und \(d_t^{Wi} < C^{Wi}\)):
\[x_t^1 = d_t^{Wi} + \min(C^{Wi} - d_t^{Wi};\; d_t^{Ma} - C^{Ma})\] \[x_t^{Ma,Ma} = C^{Ma}\]
System Evaluation (Pooling)
- Produktion Werk 1: \(E(x^{Wi})=\) 87.4
- Versorgung Markt B: \(E(x^{Wi,Ma}+x^{Ma,Ma})=\) 88.4
- Auslastung Werk 1: \(\frac{E(x^{Wi})}{C^{Wi}}=\) 97.1 %
- Lieferservicegrad Markt B: \(\frac{E(x^{Wi,Ma}+x^{Ma,Ma})}{E(d^{Ma})}=\) 98.8 %
Kapazitätspooling
Zweiseitiges Pooling – Beide Küchen können beide Standorte beliefern
| Monat | dtWi | dtMa | xtWi,Wi | xtWi,Ma | xtMa,Ma | xtMa,Wi |
|---|---|---|---|---|---|---|
| 1 | 78 | 102 | 78 | 12 | 90 | 0 |
| 2 | 79 | 92 | 79 | 2 | 90 | 0 |
| 3 | 92 | 93 | 90 | 0 | 90 | 0 |
| 4 | 76 | 87 | 76 | 0 | 87 | 0 |
| 5 | 95 | 80 | 90 | 0 | 80 | 5 |
| 6 | 104 | 97 | 90 | 0 | 90 | 0 |
| 7 | 87 | 90 | 87 | 0 | 90 | 0 |
| 8 | 92 | 76 | 90 | 0 | 76 | 2 |
| 9 | 91 | 89 | 90 | 0 | 89 | 1 |
| 10 | 85 | 86 | 85 | 0 | 86 | 0 |
| 11 | 96 | 89 | 90 | 0 | 89 | 1 |
| 12 | 93 | 93 | 90 | 0 | 90 | 0 |
System Evaluation
- Produktion Wiesbaden: \(E(x^{Wi})=\) 87.4
- Produktion Mainz: \(E(x^{Ma})=\) 88
- Versorgung Wiesbaden: \(E(x^{Wi, Wi}+x^{Ma, Wi})=\) 87
- Versorgung Mainz: \(E(x^{Wi,Ma}+x^{Ma, Ma})=\) 88.4
- Auslastung Wiesbaden: \(\frac{E(x^{Wi})}{C^{Wi}}=\) 97.1 %
- Auslastung Werk 2: \(\frac{E(x^{Ma})}{C^{Ma}}=\) 97.8 %
- Lieferservicegrad Wiesbaden: \(\frac{E(x^{Wi,Wi}+x^{Ma,Wi})}{E(d^{Wi})}=\) 97.8 %
- Lieferservicegrad Mainz: \(\frac{E(x^{Ma,Ma}+x^{Wi,Ma})}{E(d^{Ma})}=\) 98.8 %
Versorgungssystem reagiert als wäre die Trennung zwischen Märkten/Produkten und Werken aufgehoben \(\rightarrow\) Gesamtkapazität und Gesamtnachfrage entscheidend
Kapazitätspooling
Kennzahlenvergleich
| Kennzahl | Dezentral | Pooling einseitig | Pooling zweiseitig |
|---|---|---|---|
| Ø Produktion Wiesbaden (Einh.) | 86.2 | 87.4 | 87.4 |
| Ø Produktion Mainz (Einh.) | 87.2 | 87.2 | 88.0 |
| Ø Verkäufe Wiesbaden (Einh.) | 86.2 | 86.2 | 87.0 |
| Ø Verkäufe Mainz (Einh.) | 87.2 | 88.4 | 88.4 |
| Lost Sales Wiesbaden (Einh.) | 33.0 | 33.0 | 24.0 |
| Lost Sales Mainz (Einh.) | 27.0 | 13.0 | 13.0 |
| Auslastung Wiesbaden (%) | 95.8 | 95.8 | 96.7 |
| Auslastung Mainz (%) | 96.9 | 98.2 | 98.2 |
| Verkaufsquote Wiesbaden (%) | 96.9 | 96.9 | 97.8 |
| Verkaufsquote Mainz (%) | 97.5 | 98.8 | 98.8 |
Nutzen des Kapazitätspooling
Kapazitätspooling verbessert alle Servicekennzahlen gleichzeitig: mehr Verkäufe, höhere Auslastung, weniger Leerkapazität – ohne zusätzliche Produktionskapazität.
Kosten des Kapazitätspooling
Kapazitätspooling benötigt jedoch zusätzliche logistische Kapazitäten und vor allem technologische Flexibilität
Kapazitätspooling
Chaining
Chaining
Kapazitätspooling ermöglicht die gemeinsame Nutzung von Kapazitäten für verschiedene Märkte. Es erfordert jedoch technologische und logistische Flexibilität. Je mehr Märkte und Produkte zu bedienen sind, desto komplexer und kostspieliger ist Kapazitätspooling. Die Frage ist also, wie Kapazitätspooling bei mehreren Produkten und Märkten organisiert werden kann?
vollständiges Chaining
Verbindungen: \(n \cdot n = 16\)
Technologien je Werk: \(n=4\)
Märkte je Werk: \(n=4\)
Kurzes Chaining
Verbindungen: \(2 \cdot n = 8\)
Technologien je Werk: \(n=2\)
Märkte je Werk: \(n=2\)
Langes Chaining
Verbindungen: \(2 \cdot n = 8\)
Technologien je Werk: \(n=2\)
Märkte je Werk: \(n=4\)
Umgang mit Unsicherheit
Pooling über die Zeit - Sicherheitsbestände
Definition Sicherheitsbestand (Wiederholung)
Sicherheitsbestände gleichen Nachfrageschwankungen über die Zeit aus. Sei \(S\) der Anfangslagerbestand zu Begin der Risikoperiode und \(\mu\) der erwartete Bedarf in der Risikoperiode, dann gilt für den Sicherheitsbestand \(sb\): \(sb = S - \mu\)
Beispiel: Das Zentralwerk Wiesbaden-Erbenheim bestellt frische Lachsfilet-Kisten periodisch beim Fischgroßhändler.
Festlegung von Sicherheitsbeständen
- nach Kosten: Sicherheitsbestände verursachen Lagerhaltungskosten und vermeiden Fehlmengenkosten \(\rightarrow\) Kostenabwägung
- Lieferbereitschaft: Absicherung des Risikos, im Risikozeitraum nicht lieferfähig zu sein (\(\alpha\)-Servicegrad)
- Versorgungsgrad: Anteil der Nachfrage, die langfristig innerhalb des Risikozeitraums erfüllt werden soll (\(\beta\)-Servicegrad)
Sicherheitsbestände
\(\alpha\)-Servicegrad und empirische Verteilungsfunktion
Gehen Sie davon aus, dass ein Fehlmengenrisiko von 5% akzeptable ist und der \(\alpha\)-Servicegrad daher 95% beträgt. Frage: Welcher (minimale) Anfangslagerbestand sichert diesen Servicegrad? Antwort: Formal soll gelten \(P(d \leq S) \geq \alpha\). Für eine empirische Nachfrageverteilung \(F(d)\) gilt also \(\hat{F}(S) \geq \alpha\) oder \(S \geq \hat{F}^{-1}(\alpha)\). Wir suchen also ein (empirisches) Quantil.
| Rang | dt | Anzahl | F̂(d) |
|---|---|---|---|
| 1 | 76 | 1 | 8.3 % |
| 2 | 78 | 1 | 16.7 % |
| 3 | 79 | 1 | 25 % |
| 4 | 85 | 1 | 33.3 % |
| 5 | 87 | 1 | 41.7 % |
| 6 | 91 | 1 | 50 % |
| 7 | 92 | 2 | 66.7 % |
| 8 | 93 | 1 | 75 % |
| 9 | 95 | 1 | 83.3 % |
| 10 | 96 | 1 | 91.7 % |
| 11 | 104 | 1 | 100 % |
Sicherheitsbestände \(sb=S-\mu\): \(sb_{75\%}=4\), \(sb_{90\%}=7\), \(sb_{95\%}=15\)
Lagerbestandspooling
Sicherheitsbestände bei dezentraler und zentraler Lagerhaltung
Dezentrales Netzwerk
Zentrales Netzwerk (Pooling)
Einsparung an Sicherheitsbestand: \(sb_{dezentral}=sb_{A}+sb_{B}=27.5\) vs. \(sb_{0}=22.5\) \(\rightarrow\) 5 Einheiten oder 18 %
Lagerbestandspooling
Sicherheitsbestände bei bekannter Nachfrageverteilung
Nachfrageverteilung
Oft wird davon ausgegangen, dass die Nachfrage nach Gütern in einer bestimmten Zeitspanne eine Zufallsvariable ist, deren Verteilungsparameter (wie Mittelwert und Varianz) bekannt sind oder geschätzt werden können. Reale Daten weichen davon oft ab — simuliert am Beispiel Frankfurt/Offenbach mit gelegentlichen, gemeinsamen Feiertags-Spitzen.
Datenbasis: Simulierte tägliche Nachfrage über 250 Tage (set.seed(616), Details siehe R-Code)
- ECDF (durchgezogen) = empirische Verteilung
- Normalverteilung (gepunktet) = parametrisches Modell
| Filiale | μ̂ | σ̂ | KS p-Wert | emp. SB (α=95%) | param. SB |
|---|---|---|---|---|---|
| Frankfurt | 294 | 65 | 0.000 | 366 | 400 |
| Offenbach | 95 | 23 | 0.001 | 120 | 132 |
Die gemeinsamen Feiertags-Spitzen erzeugen in beiden Filialen eine rechtsschiefe, deutlich von der Normalverteilung abweichende Verteilung (KS-Test: p < 0,01 für beide) — der empirische Sicherheitsbestand fällt entsprechend niedriger aus als der parametrische.
Lagerbestandspooling
Normalverteilte Nachfrage – Sicherheitsbestand für zwei Standorte
Seien \(D_1 \sim \mathcal{N}(\mu_1, \sigma_1^2)\) und \(D_2 \sim \mathcal{N}(\mu_2, \sigma_2^2)\) die normalverteilten Nachfragen an zwei Standorten mit Korrelation \(\rho = \text{Cor}(D_1, D_2)\).
Der Sicherheitsbestand am Standort \(i\) bei \(\alpha\)-Servicegrad beträgt: \(sb_i = z_\alpha \cdot \sigma_i\), sodass in Summe: \(sb_{dez} = z_\alpha \cdot (\sigma_1 + \sigma_2)\)
Zentrales Lager: Verteilung der Gesamtnachfrage
Die aggregierte Nachfrage \(D_0 = D_1 + D_2\) ist ebenfalls normalverteilt:
\[D_0 \sim \mathcal{N}\!\left(\mu_1 + \mu_2,\; \sigma_1^2 + \sigma_2^2 + 2\rho\,\sigma_1\sigma_2\right)\]
Damit gilt für den zentralen Sicherheitsbestand:
\[sb_{zen} = z_\alpha \cdot \sqrt{\sigma_1^2 + \sigma_2^2 + 2\rho\,\sigma_1\sigma_2}\]
Vergleich dezentral vs. zentral
| Konfiguration | Sicherheitsbestand |
|---|---|
| Dezentral (2 Lager) | \(z_\alpha \cdot (\sigma_1 + \sigma_2)\) |
| Zentral (\(\rho = -1\)) | \(z_\alpha \cdot \|\sigma_1 - \sigma_2\|\) |
| Zentral (\(\rho = 0\)) | \(z_\alpha \cdot \sqrt{\sigma_1^2 + \sigma_2^2}\) |
| Zentral (\(\rho = +1\)) | \(z_\alpha \cdot (\sigma_1 + \sigma_2)\) |
\(\rightarrow\) \(\|\sigma_1 - \sigma_2\| \leq \sqrt{\sigma_1^2 + \sigma_2^2} \leq \sigma_1 + \sigma_2\) \(\rightarrow\) Pooling lohnt sich, solange \(\rho < 1\)
Je kleiner die Korrelation \(\rho\), desto größer das Einsparungspotenzial durch zentrales Pooling. (Risikoausgleichseffekt)
Kernergebnis
Sicherheitsbestand für alle sechs SushiFresh-Filialen (\(\alpha = 95\%\))
Mit qnorm() verifiziert
- \(z_{0{,}95} =\) 1.645
- Dezentral: \(sb_{dez}=z_\alpha\sum\sigma_i=\) 289.5 Boxen
- Zentral (gepoolt, unabhängig): \(sb_{zen}=z_\alpha\sqrt{\sum\sigma_i^2}=\) 127.5 Boxen
- Einsparung durch Konsolidierung: 56 %
Gegenprobe pooling_safety_stock(): für 6 identische Filialen mit \(\bar\sigma=\) 29.3 ergäbe sich eine Einsparung von 59 % — mehr als die tatsächlichen 56 %. Der dominante, volatile Standort Frankfurt (\(\sigma=55\)) schmälert den relativen Pooling-Vorteil gegenüber dem idealisierten Fall gleich großer Standorte.
56,0 % weniger Sicherheitsbestand durch die Zentralisierung auf Wiesbaden-Erbenheim — bei identischem Servicegrad.
Lagerbestandspooling
Empirische Illustration
negative Korrelation \(\rho = -0.8\)
keine Korrelation \(\rho = 0\)
positive Korrelation \(\rho = +0.8\)
Bei negativer Korrelation dämpfen sich die Schwankungen von \(D_0\) gegenseitig — die Gesamtnachfrage ist stabiler als die Einzelnachfragen. Bei positiver Korrelation verstärken sie sich.
Lagerbestandspooling
Sicherheitsbestand in Abhängigkeit der Korrelation \(\rho\)
Drei Szenarien (Wiesbaden \(\sigma_1=25\), Mainz \(\sigma_2=30\), \(\alpha = 95\%\))
| \(\rho\) | \(sb_{zen}\) | Einsparung |
|---|---|---|
| \(-0.8\) | 29.7 | 67.2 % |
| \(\;\;\;0\) | 64.2 | 29 % |
| \(+0.8\) | 85.9 | 5.1 % |
| \((+1)\) | 90.5 | 0 % |
\(sb_{dez} = z_\alpha \cdot (\sigma_1 + \sigma_2) =\) 90.5
Zentralitätsgewinn wenn \(\sigma_1 \neq \sigma_2\)
\[1-\frac{sb_{zen}}{sb_{dez}} = 1-\frac{\sqrt{\sigma_1^2 + \sigma_2^2 + 2\rho\,\sigma_1\sigma_2}}{\sigma_1 + \sigma_2}\]
Zentralitätsgewinn wenn \(\sigma_1 = \sigma_2\)
\[1-\frac{sb_{zen}}{sb_{dez}} = 1-\sqrt{\frac{1+\rho}{2}}\]
Lagerbestandspooling
Simulierte Tagesnachfrage: Frankfurt & Offenbach
| Kennzahl | Frankfurt | Offenbach | Gesamt / Pool |
|---|---|---|---|
| μ̂ | 294.1 | 94.9 | 389 |
| σ̂ | 64.7 | 22.8 | 79.6 |
| SB dezentral (emp.) | 71.5 | 25.1 | 96.6 |
| SB zentral (emp.) | — | — | 80.5 |
| Einsparung (emp.) | — | — | 16.7 % |
| SB dezentral (norm.) | 106.4 | 37.5 | 143.9 |
| SB zentral (norm.) | — | — | 130.8 |
| Einsparung (norm.) | — | — | 9.1 % |
Korrelation \(\hat{\rho} =\) 0.55 \(\rightarrow\) Pooling-Einsparung empirisch: 16.7 %, parametrisch: 9.1 %
Exkurs: Normalverteilung
Wahrscheinlichkeitsdichtefunktion & Verteilungsfunktion
Formale Definition
Dichtefunktion \(f(x)\) gibt die relative Häufigkeit an, mit der ein Wert \(x\) auftritt und Verteilungsfunktion \(F(x)\) ist die kumulierte Wahrscheinlichkeit:
\[f(x) = \frac{1}{\sigma\sqrt{2\pi}}\,\exp\!\left(-\frac{(x-\mu)^2}{2\sigma^2}\right) \qquad F(x) = P(X \leq x) = \int_{-\infty}^{x} f(t)\,dt\]
Symmetrie-Eigenschaft und 68–95–99,7-Regel::
\[F(-z) = 1 - F(z)\]
| Wertebereich | Wahrscheinlichkeit |
|---|---|
| \(\mu \pm 1\sigma\) | ≈ 68,3 % |
| \(\mu \pm 2\sigma\) | ≈ 95,4 % |
| \(\mu \pm 3\sigma\) | ≈ 99,7 % |
Exkurs: Standardnormalverteilung
z-Transformation & Standardisierung
z-Transformation überführt jede Normalverteilung \(X \sim \mathcal{N}(\mu, \sigma^2)\) in die Standardnormalverteilung \(Z \sim \mathcal{N}(0, 1)\):
\[Z = \frac{X - \mu}{\sigma} \quad \Rightarrow P(X \leq x) = P\!\left(Z \leq \frac{x-\mu}{\sigma}\right) = \Phi(z)\] \(\rightarrow\) alle \(\mathcal{N}(\mu, \sigma^2)\) lassen sich auf eine Tabelle zurückführen — die Standard-Normalverteilungstabelle \(\Phi(z)\)
Wichtige Quantile der \(\mathcal{N}(0,1)\):
| Servicegrad \(\alpha\) | \(z_\alpha = \Phi^{-1}(\alpha)\) |
|---|---|
| 90,0 % | 1,282 |
| 95,0 % | 1,645 |
| 97,5 % | 1,960 |
| 99,0 % | 2,326 |
| 99,9 % | 3,090 |
Exkurs: Quantils-/Verteilungstabelle
Ablesen von \(\Phi(z)\) und Umkehrung \(z_\alpha = \Phi^{-1}(\alpha)\)
| +0.00 | +0.01 | +0.02 | +0.03 | +0.04 | +0.05 | +0.06 | +0.07 | +0.08 | +0.09 | |
|---|---|---|---|---|---|---|---|---|---|---|
| 0.0 | 0.5000 | 0.5040 | 0.5080 | 0.5120 | 0.5160 | 0.5199 | 0.5239 | 0.5279 | 0.5319 | 0.5359 |
| 0.1 | 0.5398 | 0.5438 | 0.5478 | 0.5517 | 0.5557 | 0.5596 | 0.5636 | 0.5675 | 0.5714 | 0.5753 |
| 0.2 | 0.5793 | 0.5832 | 0.5871 | 0.5910 | 0.5948 | 0.5987 | 0.6026 | 0.6064 | 0.6103 | 0.6141 |
| 0.3 | 0.6179 | 0.6217 | 0.6255 | 0.6293 | 0.6331 | 0.6368 | 0.6406 | 0.6443 | 0.6480 | 0.6517 |
| 0.4 | 0.6554 | 0.6591 | 0.6628 | 0.6664 | 0.6700 | 0.6736 | 0.6772 | 0.6808 | 0.6844 | 0.6879 |
| 0.5 | 0.6915 | 0.6950 | 0.6985 | 0.7019 | 0.7054 | 0.7088 | 0.7123 | 0.7157 | 0.7190 | 0.7224 |
| 0.6 | 0.7257 | 0.7291 | 0.7324 | 0.7357 | 0.7389 | 0.7422 | 0.7454 | 0.7486 | 0.7517 | 0.7549 |
| 0.7 | 0.7580 | 0.7611 | 0.7642 | 0.7673 | 0.7704 | 0.7734 | 0.7764 | 0.7794 | 0.7823 | 0.7852 |
| 0.8 | 0.7881 | 0.7910 | 0.7939 | 0.7967 | 0.7995 | 0.8023 | 0.8051 | 0.8078 | 0.8106 | 0.8133 |
| 0.9 | 0.8159 | 0.8186 | 0.8212 | 0.8238 | 0.8264 | 0.8289 | 0.8315 | 0.8340 | 0.8365 | 0.8389 |
| 1.0 | 0.8413 | 0.8438 | 0.8461 | 0.8485 | 0.8508 | 0.8531 | 0.8554 | 0.8577 | 0.8599 | 0.8621 |
| 1.1 | 0.8643 | 0.8665 | 0.8686 | 0.8708 | 0.8729 | 0.8749 | 0.8770 | 0.8790 | 0.8810 | 0.8830 |
| 1.2 | 0.8849 | 0.8869 | 0.8888 | 0.8907 | 0.8925 | 0.8944 | 0.8962 | 0.8980 | 0.8997 | 0.9015 |
| 1.3 | 0.9032 | 0.9049 | 0.9066 | 0.9082 | 0.9099 | 0.9115 | 0.9131 | 0.9147 | 0.9162 | 0.9177 |
| 1.4 | 0.9192 | 0.9207 | 0.9222 | 0.9236 | 0.9251 | 0.9265 | 0.9279 | 0.9292 | 0.9306 | 0.9319 |
| 1.5 | 0.9332 | 0.9345 | 0.9357 | 0.9370 | 0.9382 | 0.9394 | 0.9406 | 0.9418 | 0.9429 | 0.9441 |
| 1.6 | 0.9452 | 0.9463 | 0.9474 | 0.9484 | 0.9495 | 0.9505 | 0.9515 | 0.9525 | 0.9535 | 0.9545 |
| 1.7 | 0.9554 | 0.9564 | 0.9573 | 0.9582 | 0.9591 | 0.9599 | 0.9608 | 0.9616 | 0.9625 | 0.9633 |
| 1.8 | 0.9641 | 0.9649 | 0.9656 | 0.9664 | 0.9671 | 0.9678 | 0.9686 | 0.9693 | 0.9699 | 0.9706 |
| 1.9 | 0.9713 | 0.9719 | 0.9726 | 0.9732 | 0.9738 | 0.9744 | 0.9750 | 0.9756 | 0.9761 | 0.9767 |
| 2.0 | 0.9772 | 0.9778 | 0.9783 | 0.9788 | 0.9793 | 0.9798 | 0.9803 | 0.9808 | 0.9812 | 0.9817 |
| 2.1 | 0.9821 | 0.9826 | 0.9830 | 0.9834 | 0.9838 | 0.9842 | 0.9846 | 0.9850 | 0.9854 | 0.9857 |
| 2.2 | 0.9861 | 0.9864 | 0.9868 | 0.9871 | 0.9875 | 0.9878 | 0.9881 | 0.9884 | 0.9887 | 0.9890 |
| 2.3 | 0.9893 | 0.9896 | 0.9898 | 0.9901 | 0.9904 | 0.9906 | 0.9909 | 0.9911 | 0.9913 | 0.9916 |
| 2.4 | 0.9918 | 0.9920 | 0.9922 | 0.9925 | 0.9927 | 0.9929 | 0.9931 | 0.9932 | 0.9934 | 0.9936 |
| 2.5 | 0.9938 | 0.9940 | 0.9941 | 0.9943 | 0.9945 | 0.9946 | 0.9948 | 0.9949 | 0.9951 | 0.9952 |
| 2.6 | 0.9953 | 0.9955 | 0.9956 | 0.9957 | 0.9959 | 0.9960 | 0.9961 | 0.9962 | 0.9963 | 0.9964 |
| 2.7 | 0.9965 | 0.9966 | 0.9967 | 0.9968 | 0.9969 | 0.9970 | 0.9971 | 0.9972 | 0.9973 | 0.9974 |
| 2.8 | 0.9974 | 0.9975 | 0.9976 | 0.9977 | 0.9977 | 0.9978 | 0.9979 | 0.9979 | 0.9980 | 0.9981 |
| 2.9 | 0.9981 | 0.9982 | 0.9982 | 0.9983 | 0.9984 | 0.9984 | 0.9985 | 0.9985 | 0.9986 | 0.9986 |
| 3.0 | 0.9987 | 0.9987 | 0.9987 | 0.9988 | 0.9988 | 0.9989 | 0.9989 | 0.9989 | 0.9990 | 0.9990 |
Ablesen der Tabelle:
Gesucht: \(P(X \leq x)\) für \(X \sim \mathcal{N}(\mu, \sigma^2)\)
- Berechne \(z = (x - \mu)/\sigma\)
- Zeile = erste Dezimalstelle von \(z\)
- Spalte = zweite Dezimalstelle von \(z\)
- Tabellenwert = \(\Phi(z)\)
Beispiel Lagerbestand:
\(D \sim \mathcal{N}(500, 80^2)\), Servicegrad \(\alpha = 95\,\%\)
\[z_{0{,}95} = \Phi^{-1}(0{,}95) = 1{,}645\]
\[\Rightarrow\; \text{SB} = z_\alpha \cdot \sigma = 1{,}645 \cdot 80 \approx \mathbf{132\;\text{Stück}}\]
Unsicherheits- und Risikomanagement in SCs - Newsvendor-Modell
Unsicherheit in Supply Chains
- Pooling
- Newsvendor-Modell
- Bullwhip-Effekt
Lernziele
Nach dieser Einheit können Sie …
- das Newsvendor-Problem als einmalige Bestellentscheidung bei unsicherer Nachfrage einordnen,
- Über- und Unterdeckungskosten bestimmen,
- die kritische Fraktilregel herleiten und interpretieren,
- eine optimale Bestellmenge bei gegebener Nachfrageverteilung berechnen,
- den Einfluss zentraler Modellparameter auf die Bestellentscheidung erklären.
Literatur zur Vertiefung
- Einführung Newsvendor: (Thonemann 2023, Kapitel 5).
- Einperiodige Bestandsmodelle und Critical-Fractile-Logik: (Cachon and Terwiesch 2024, Kapitel 13).
- Newsvendor-Modelle im Kontext des Inventory Managements: (Silver et al. 2017, Kapitel 9).
Fallbeispiel
Sushi-Boxen im Supermarkt
Ein Supermarkt bezieht täglich frisch produzierte Sushi-Boxen von der SushiFresh GmbH, einem regionalen Sushi-Hersteller im Rhein-Main-Gebiet.
- Die Boxen werden morgens vorbereitet und vor Ladenöffnung geliefert.
- Die Nachfrage ist bis zum Abend unsicher. Nachlieferungen tagsüber sind ausgeschlossen.
- Nicht verkaufte Sushi-Boxen dürfen am Folgetag nicht mehr regulär verkauft werden.
Entscheidungsfrage: Wie viele Sushi-Boxen sollte der Lieferant vorbereiten?
Fallbeispiel
Kosten- und Erlösstruktur
Für eine Sushi-Box gelten die folgenden, vereinfachten Werte:
| Größe | Bedeutung | Wert |
|---|---|---|
| Verkaufspreis \(p\) | Erlös je verkaufter Sushi-Box | 10 EUR |
| Herstell- und Lieferkosten \(c\) | Kosten je vorbereiteter Sushi-Box | 5 EUR |
| Restwert \(v\) | Erlös bei Abendrabatt bzw. Verwertung | 2 EUR |
typischerweise gilt allgemein: \(p > c > v\)
\(\rightarrow\) Deckungsbeitrag pro verkaufte Sushi-Box: \(c^u=p-c = 10-5=5\) €
\(\rightarrow\) Verwertungsverlust pro nicht verkaufte Sushi-Box: \(c^o=c-v=5-2=3\) €
Fallbeispiel
Zwei möglische Situation aus Sicht des Lieferanten
Zu viele Boxen:
- weniger Nachfrage \(D\) als produzierte Sushi-Boxen \(q\) \(\rightarrow\) Überbestand \(q-D\)
- verkaufte Menge: \(\min(D,q) = D\)
- Deckungsbeitrag aus Verkauf: \(D \cdot c^u\)
- zusätzliche Kosten der Verwertung: \((q-D) \cdot c^o\)
Gesamtdeckungsbeitrag: \(P(D,q)= D \cdot c^u - (q - D) \cdot c^o\)
Zu wenige Boxen:
- mehr Nachfrage \(D\) als produzierte Sushi-Boxen \(q\) \(\rightarrow\) Fehlmenge \(D-q\)
- verkaufte Menge: \(\min(D,q) = q\)
- gesamter Deckungsbeitrag: \(q \cdot c^u\)
- Opportunitätskosten aus entgangenem Deckungsbeitrag: \((D-q) \cdot c^u\)
Gesamtdeckungsbeitrag: \(P(D,q) = q \cdot c^u\)
Fallbeispiel
Mögliche Nachfrage & Produktionsmenge
Als vereinfachtes Miniaturbeispiel (z. B. für eine kleine Filiale oder einen Testverkauf) schätzt SushiFresh aus Verkaufshistorie, Wochentag, Wetterprognose und aktuellen Aktionen zunächst vier mögliche Nachfrageszenarien:
| Nachfrage \(D\) | Wahrscheinlichkeit \(P(D=d)\) | Kumulierte Wahrscheinlichkeit \(F(d)\) |
|---|---|---|
| 30 Sushi-Boxen | 0,20 | 0,20 |
| 40 Sushi-Boxen | 0,35 | 0,55 |
| 50 Sushi-Boxen | 0,30 | 0,85 |
| 60 Sushi-Boxen | 0,15 | 1,00 |
Welche Menge sollte der Lieferant morgens vorbereiten: 30, 40, 50 oder 60 Sushi-Boxen?
Fallbeispiel
Erwartetes Ergebnis
Setze \(q=40\) Sushi-Boxen
| Nachfrage \(D\) | Wahrsch. \(P(D=d)\) | Überbestand \(q-D\) | Fehlmenge \(q-D\) | Deckungs-beitrag \(P\) |
|---|---|---|---|---|
| 30 Sushi-Boxen | 0,20 | 10 | 0 | 120 € |
| 40 Sushi-Boxen | 0,35 | 0 | 0 | 200 € |
| 50 Sushi-Boxen | 0,30 | 0 | 10 | 200 € |
| 60 Sushi-Boxen | 0,15 | 0 | 20 | 200 € |
erwarteter Gesamtdeckungsbeitrag: \(\begin{align} E(P|q=40)= & 0.2 \cdot 120 + 0.35 \cdot 200 + \\ & 0.30 \cdot 200 + 0.15 \cdot 200= 184 \end{align}\)
\(E(P|q)\) für alle \(q\)
\(\rightarrow\) maximaler erwarteter Deckungsbeitrag bei \(q=50\) mit 190 € pro Tag
Newsvendormodell
Herleitung der Zielfunktion
Überdeckung \(q > D\)
\[P(D,q) = D \cdot c^u - (q-D)^+\cdot c^o\]
\[\Downarrow\]
Unterdeckung \(q < D\)
\[P(D,q) = q \cdot c^u\]
\[\Downarrow\]
\[\begin{align} P(D,q) =& \min(D,q) \cdot c^u - (q-D)^+ \cdot c^o \\ = & (D-(D-q)^+) \cdot c^u - (q-D)^+ \cdot c^o \\ = & \underset{\text{Deckungsbeitrag}}{D \cdot c^u} - \underset{\text{ Fehlmengenkosten}}{(D-q)^+ \cdot c^u} - \underset{\text{Überbestandskosten}}{(q-D)^+ \cdot c^o} \end{align} \] wobei \((q-D)^+ = \max(0,q-D)\), \((D-q)^+ = \max(0,D-q)\) und \(\min(D,q) = D - (D-q)^+\)
Newsvendor-Modell
Formales Modell
Problembeschreibung
Suche die Bestellmenge \(q\), die den erwarteten Profit maximiert oder die erwarteten Kosten minimiert: \[ \underset{q}{\max} E(P(q)) = \mu \cdot c^u - E((D-q)^+) \cdot c^u - E((q-D)^+) \cdot c^o \; \Leftrightarrow \; \underset{q}{\min} E(C(q)) = E((D-q)^+) \cdot c^u + E((q-D)^+) \cdot c^o \] \(\rightarrow\) minimiere das gewichtete Mittel aus erwarteter Fehlmenge \(E((D-q)^+)\) und erwartetem Überbestand \(E((q-D)^+)\)
Diskrete Nachfrage (vgl. vorige Folie)
Kontinuierliche Nachfrage (Filiale Frankfurt) \(D \sim N(280,55^2)\)
Newsvendor-Modell
Formale Lösung
Die optimale Bestellmenge \(q^*\) ist, wo die Anstiege der erwarteten Fehlmengenkosten \(E((D-q)^+) \cdot c^u\) und der Überbestandskosten \(E((q-D)^+)\cdot c^o\) gleich sind: \[ \left(1 - F(q^*)\right) \cdot c^u \overset{!}{=} F(q^*) \cdot c^o \quad \Longrightarrow \quad q^* = F^{-1} \left( \frac{c^u}{c^o + c^u} \right)\]
Diskrete Nachfrage (Verteilungsparameter vgl. vorige Folie) mit \(c^u = 5\) und \(c^o=3\)
Kontinuierliche Nachfrage (Filiale Frankfurt) \(D \sim N(280,55^2)\) mit \(c^u = 5\) und \(c^o=3\)
Newsvendor-Modell
Kritisches Verhältnis
kritisches Verhältnis (critical ratio)
Die optimale Bestellmenge ist das Nachfragequantil, dessen kumulierte Wahrscheinlichkeit dem Verhältnis von Fehlmengen- zu Gesamtkosten entspricht. Das kritische Verhältnis entscheidet also über die Risikobereitschaft
\[ CR = \frac{c^u}{c^o + c^u}\]
Fall 1: \(c^u < c^o\)
- Fehlmengenkosten sind kleiner als Überbestandskosten
- Überbestände sollten vermieden werden
- \(\rightarrow\) opt. Bestellmenge \(q^*\) kleiner als Median der Nachfrageverteilung
Fall 2: \(c^u = c^o\)
- Fehlmengenkosten = Überbestandskosten
- Fehlmengen und Überbestände gleich bedeutend
- \(\rightarrow\) opt. Bestellmenge \(q^*\) gleicht dem Median der Nachfrageverteilung
Fall 3: \(c^u > c^o\)
- Fehlmengenkosten sind größer als Überbestandskosten
- Fehlmengen sollten vermieden werden
- \(\rightarrow\) opt. Bestellmenge \(q^*\) größer als Median der Nachfrageverteilung
Newsvendor-Modell
Optimale Lösung bei Normalverteilung
Normalverteilte Nachfrage
Im Falle normalverteilter Nachfrage mit \(D \sim (\mu,\sigma^2)\) kann die optimale Bestellmenge durch Transformation zur Standardnormalverteilung berechnet werden. Für optimale Bestellmenge und Kosten gilt \[z^* = \Phi^{-1} \left( \frac{c^u}{c^o + c^u} \right) \qquad q^*=\mu + \sigma \cdot z^* \qquad E(C(q^*))=(c^u+c^o)\cdot \sigma \cdot \varphi\left( z^* \right) \]
Fallbeispiel Filiale Frankfurt mit \(N(280,55^2)\)
Fall 1: \(c^u=1 < 5=c^o\)
\(q^* = 280 + 55 \cdot\) -0.97=226.8
Fall 2: \(c^u = 3 = c^o\)
\(q^* = 280 + 55 \cdot\) 0=280
Fall 3: \(c^u=5 > 1=c^o\)
\(q^* = 280 + 55 \cdot\) 0.97=333.2
Newsvendor-Modell
Typische Anwendungen
Voraussetzungen
Das Newsvendor wird besonders häufig verwendet, wenn keine Bedarfsglättung durch Lagerhaltung möglich ist und die Fehlmengenkosten gut bestimmbar sind
Typische Anwendungsbereich sind z.B. bei
- Saison- und Aktionsartikel
- Frischwaren mit kurzer Haltbarkeit
- Tickets für Veranstaltungen oder Verkehrsmittel
- …
Important
Darüber hinaus ist es die Basis für die Berechnung kostenoptimaler Sicherheitsbestände in Lagerhaltungssystemen.
Unsicherheits- und Risikomanagement in SCs - Bullwhip-Effekt
Unsicherheit in Supply Chains
- Pooling
- Newsvendor-Modell
- Bullwhip-Effekt
Lernziele
Nach dieser Einheit können Sie …
- den Bullwhip-Effekt entlang einer Supply Chain erklären
- wesentliche Ursachen und Folgen des Bullwhip-Effekts beurteilen
- Order-up-to-Level \(S\) und Sicherheitsbestand \(SB\) bestimmen
- Maßnahmen zur Reduktion des Bullwhip-Effekts einordnen
Literatur zur Vertiefung
- Grundlegende Ursachen und Gegenmaßnahmen des Bullwhip-Effekts: (Thonemann 2023, Kapitel 8, insbesondere 8.2).
- Empirische Untersuchung der Informationsübertragung: (Bray and Mendelson 2012).
- Messung, Aggregation und Wirkung von Bullwhip-Effekten: (Yao et al. 2020).
Fallbeispiel: Sushi-Boxen
Fortsetzung
Die SushiFresh-Lieferkette
SushiFresh GmbH ist ein regionaler Hersteller frischer Sushi-Boxen und beliefert sechs Supermarkt-Filialen im Rhein-Main-Gebiet. Für die Produktion ist SushiFresh auf die tägliche Lieferung von frischen Fischfilets angewiesen, die der Fischgroßhändler Nord-Fisch KG liefert. Die Sushi-Supply-Chain ist also so strukturiert:
\[ \text{Supermarkt-Filialen} \mathrel{ \mathop{\leftrightharpoons} \limits^{\text{Lieferung}}_{\text{Bestellung}} } \text{SushiFresh GmbH} \mathrel{ \mathop{\leftrightharpoons} \limits^{\text{Lieferung}}_{\text{Bestellung}} } \text{Nord-Fisch KG} \]
Supermarkt-Filialen
- beobachten Endkundennachfrage (z. B. Filiale Frankfurt: \(\mu=280\), \(\sigma=55\))
- bestellen täglich Sushi-Boxen bei SushiFresh
SushiFresh GmbH
- bekommt Bestellungen der Filialen (=Nachfrage)
- bestellt Fisch für die Sushi-Boxen bei Nord-Fisch KG und hält einen Bestand an Fisch als Vorrat
Nord-Fisch KG
- bekommt Bestellungen von SushiFresh GmbH (=Nachfrage)
- beschafft Rohfisch, produziert die Fisch-Filets und lagert diese, um schnell liefern zu können
Important
SushiFresh und Nord-Fisch Akteure halten einen (Sicherheits-)Bestand an Fischfilets, um Fehlmengen zu vermeiden \(\rightarrow\) Wie hoch sollte dieser sein?
Fallbeispiel: SushiFresh GmbH
Situation von SushiFresh GmbH
Bestellprozess für Fischfilets
SushiFresh GmbH entscheidet täglich über seine Produktionsmenge an Sushi-Boxen für die Filiale Frankfurt (vgl. Folien Newsvendormodell). Basierend auf der Sushi-Box-Nachfrage, sei \(d_t\) der Bedarf an Fischfilet-Einheiten an Tag \(t\) (Filiale Frankfurt: \(\mu=280\), \(\sigma=55\)). SushiFresh kann jeden Tag Nachschub bei Nord-Fisch KG bestellen. Die Bestellmenge an Tag \(t\) sei \(q_t\). Bestellte Fischfilets werden \(l=2\) Tage später geliefert. Die physisch verfügbare Menge an Fischfilet-Einheiten sei \(i_t\). Falls keine Fischfilets vorrätig sind, wird der Bedarf vorgemerkt (\(b_t\)) und später nachproduziert bzw. nachgeliefert.
Sushi-Boxen-Bestände
- der physische Bestand \(i_t\) wird berechnet als \(i_t = \max(0,i_{t-1} + q_{t-2} - d_t)\)
- der Nettobestand \(n_t\) berücksichtigt auch Fehlmengen \(n_t = i_{t-1} + q_{t-2} - d_t\)
- der disponible Bestand \(p_t\) berücksichtigt auch offene Bestellungen \(p_t = n_{t-1} + q_{t-1} (+q_t)\)
Fallbeispiel: SushiFresh GmbH
Bestand von SushiFresh GmbH (Filiale Frankfurt)
Nachfrage
| Periode | Nachfrage |
|---|---|
| 0 | NA |
| 1 | 234 |
| 2 | 256 |
| 3 | 344 |
| 4 | 410 |
| 5 | 278 |
| 6 | 322 |
| 7 | 212 |
| 8 | 256 |
| 9 | 278 |
| 10 | 234 |
| 11 | 256 |
| 12 | 278 |
Anfangslagerbestand \(i_0 =\) 990 Zielbestand \(S =\) 990
Fallbeispiel: SushiFresh GmbH
Festlegung des Ziellagerbestands
Bestellprozess & Ziellagerbestand \(S\)
Durch Festlegung des Ziellagerbestand \(S\) ergibt sich die Bestellmenge und der Sicherheitsbestand:
\[ q_t = S - p_t \qquad \qquad sb_t = S - \mu \cdot (l+1) \]
bei gegebenen \(\alpha\)-Servicegrad
Übertragung der Formel für eine Periode (vgl. Pooling-Vorlesung) auf mehrere Perioden:
\[ S = \mu \cdot (l+1) + \sqrt{l+1} \cdot \sigma \cdot z_{\alpha}\]
bei gegebenen Fehlmengen-Kostensatz \(c^u\) und Lagerhaltungskostensatz \(c^o\)
Übertragung der Newsvendor-Formel:
\[ S = \mu \cdot (l+1) + \sqrt{l+1} \cdot \sigma \cdot z_{\frac{c^u}{c^u+c^o}}\]
Important
Wichtig: Die Parameter \(\mu\) und \(\sigma\) sind die erwarte tägliche Nachfrage(-rate) (Nachfrage pro Periode) und die erwartete Abweichung (Standardabweichung). Beide Parameter werden geschätzt auf Basis der empirischen Kundennachfrage.
Fallbeispiel: SushiFresh GmbH
Bestellentscheidungen und deren Auswirkungen
Schätzung der Nachfrageparameter \(\mu\) und \(\sigma\)
Die Parameter der Nachfrageverteilung werden durch statistische Schätzverfahren (Schätzer) ermittelt, wie dem (gleitenden) Mittelwert und der empirischen Standardabweichung:
\(\hat{\mu} = \frac{1}{T} \sum_{\tau=t-T}^{t-1} d_\tau \qquad \qquad \hat{\sigma} = \sqrt{ \frac{1}{T-1} \sum_{\tau=t-T}^{t-1} (d_\tau - \hat{\mu})^2 } \rightarrow \;\text{Prognosefehler}\)
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Bedarf d[t] | 234 | 256 | 344.0 | 410.0 | 278.0 | 322 | 212.0 | 256.0 | 278.0 | 234.0 | 256 | 278 |
| Mittelwert μ̂[t] | 256 | 234 | 245.0 | 278.0 | 336.7 | 344 | 336.7 | 270.7 | 263.3 | 248.7 | 256 | 256 |
| Standardabweichung σ̂[t] | 1 | 1 | 15.6 | 58.2 | 77.3 | 66 | 67.2 | 55.4 | 55.4 | 33.6 | 22 | 22 |
| Zielbestand S[t] | 771 | 705 | 779.0 | 1000.0 | 1230.0 | 1220 | 1201.0 | 970.0 | 948.0 | 842.0 | 831 | 831 |
| Bestellung q[t] | 15 | 190 | 418.0 | 631.0 | 508.0 | 312 | 193.0 | 25.0 | 256.0 | 128.0 | 245 | 278 |
Beobachtung
Die Schwankung der Nachfrage \(\sigma_d=\) 55.1 ist deutlich kleiner als die Standardabweichung der Bestellmengen \(\sigma_q=\) 183.1 \(\rightarrow\) zusätzliche Unsicherheit für Nord-Fisch KG wird generiert
Bullwhip-Effekt
Definition & Illustration
Definition (Cachon and Terwiesch 2024)
The bullwhip effect is present in a supply chain if the variability of demand at one level of the supply chain is greater than the variability of demand at the next downstream level in the supply chain, where variability is measured with the coefficient of variation.
Typische Verläufe
Upstream-Effekte
- “Aufschaukeln” der Bestellmengen
- Volatilität der Bestände steigt
- häufigere Fehlmengen
Bullwhip-Effekt
Typische Beobachtungen
- meist gilt \(q_t \neq d_t\), denn die Bestellmenge enthält mehrere Bestandteile \[ q_t=\text{erwarteter Bedarf}+\text{Bestandskorrektur}+\text{Sicherheitsbestandskorrektur}.\]
- für Lieferanten ist es nicht ersichtlich, ob Bestellmengenschwankungen langfristig Verschiebungen anzeigen (d.h. die Endkundennachfrage steigt) oder ob es kurzfristige Bestandskorrekturen sind \(\rightarrow\) Schätzung der zukünftigen Nachfrage schwierig \(\rightarrow\) Prognosefehler steigen \(\rightarrow\) Bestellmengen schwanken stärker
- daher folgt oft das die Schwankungen der Bestellmengen mit jeder Wertschöpfungsstufe steigen: \(\operatorname{Var}(d_t)< \operatorname{Var}(q_t^{i})<\operatorname{Var}(q_t^{i+1})<\operatorname{Var}(q_t^{i+2})< ...\)
Messung des Bullwhip-Effekts
Maße für den Bullwhip-Effekt sind die Varianzquotienten \(B=\frac{\operatorname{Var}(q_t)}{\operatorname{Var}(d_t)}>1\) und \(B=\frac{\operatorname{Var}(q^{i}_t)}{\operatorname{Var}(q^{i-1}_t)}>1\)
\(\rightarrow\) je größer \(B\) desto stärker der Bullwhip-Effekt
Bullwhip-Effekt
Empirie (Bray and Mendelson 2012; Chen and Lee 2012; Yao et al. 2020)
\(2/3\) der Unternehmen
In einer Stichprobe von 4.689 börsennotierten US-Unternehmen zeigten rund zwei Drittel eine positive Verstärkung der Beschaffungs- gegenüber der Absatzvariabilität.
\(+15{,}8\%\) im Durchschnitt
Die mittlere Bullwhip-Verstärkung betrug \(15{,}8\%\) der Nachfragevariabilität; der Median lag bei \(6{,}7\%\).
Größenordnung
Im Mittel lag die quartalsweise Standardabweichung vorgelagerter Bestellungen um rund 20 Mio. US-Dollar über derjenigen der beobachteten Nachfrage.
Reale Performance-Folgen (Yao et al. 2020)
Ein stärkerer Bullwhip-Effekt geht mit einem höheren Bestandsverhältnis und zugleich mehr Fehlmengen einher \(\rightarrow\) Sicherhietsbestände reichen nicht
Aggregation verdeckt das Problem
Auf Produkt-, Filial- oder Zeitaggregate verdichtete Kennzahlen unterschätzen den Bullwhip-Effekt gegenüber einer Messung auf SKU-Ebene.
Management-Botschaft
Nicht nur die Endkundennachfrage erzeugt Volatilität:
\[ \text{Nachfragesignal} + \text{lokale Disposition} = \text{Bestellvarianz} \]
Bullwhip-Effekt
Ursachen des Bullwhip-Effekts
| Ursache | Wirkungsmechanismus |
|---|---|
| Lokale Prognosen | Bestellungen werden als tatsächliche Nachfrage interpretiert |
| Prognoseaktualisierung | Kleine Nachfrageänderungen führen zu Anpassungen der Zielbestände |
| Lange Lieferzeiten | Entscheidungen müssen weit in die Zukunft wirken |
| Auftragsbündelung | Seltene Großbestellungen erzeugen künstliche Bedarfsspitzen |
| Preisaktionen | Vorratskäufe verzerren die beobachtete Nachfrage |
| Rationierung | Akteure bestellen strategisch mehr als ihren tatsächlichen Bedarf |
| Fehlende Transparenz | Endkundennachfrage ist nicht für alle Stufen sichtbar |
| Lokale Zielsysteme | Stufen optimieren individuell statt systemweit |
Bullwhip-Effekt
Typische Folgen
Operative Folgen
- Schwankende Produktionsprogramme
- Instabile Kapazitätsauslastung
- Eiltransporte und Sondermaßnahmen
- Hohe Bestände und dennoch Fehlmengen
- Niedrigere Lieferfähigkeit
- Höhere Planungsunsicherheit
Ökonomische Folgen
- Höhere Kapitalbindung
- Höhere Lagerkosten
- Höhere Obsoleszenzrisiken
- Höhere Rüst- und Produktionskosten
- Höhere Transportkosten
- Umsatz- und Deckungsbeitragsverluste
Bullwhip-Effekt
Gegenmaßnahmen
| Hebel | Maßnahme | Wirkung auf Bestände und Varianz |
|---|---|---|
| Informationsfluss | Point-of-Sale-Daten teilen | \(\sigma\) der Prognosefehler sinkt |
| Planung | Gemeinsame Prognosen und CPFR | Lokale Prognoseverzerrungen sinken |
| Bestellpolitik | Kleine, häufige Bestellungen | Auftragsbündelung sinkt |
| Lieferzeit | Informations- und Lieferzeiten verkürzen | Risikozeitraum sinkt |
| Preise | Stabile Preise statt Vorratsanreize | Künstliche Bedarfsspitzen sinken |
| Allokation | Rationierung nach historischen Mengen | Strategische Überbestellung sinkt |
| Steuerung | Gesamtoptimum statt lokaler Zielgrößen | Bestell- und Bestandsentscheidungen werden koordiniert |
Distributionslogistik
Distributionslogistik
- Lager und Kommissionierung
- Verkehrsmittel, Antriebe und Kosten
Lernziele
Nach dieser Einheit können Sie …
- Lagertypen und Kommissionierverfahren unterscheiden und für ein Sortiment auswählen,
- feste, chaotische und zugriffsorientierte Lagerplatzvergabe (ABC, COI) vergleichen und anwenden,
- Kommissioniertouren mit S-Shape, Return und Largest Gap bestimmen und mit der optimalen Tour vergleichen,
- das Zusammenspiel von Lagerplatzvergabe und Routing beurteilen.
Literatur zur Vertiefung
- Lager- und Kommissioniersysteme: (ten Hompel and Schmidt 2010); (Günther and Tempelmeier 2012).
- Übersicht zur Kommissionierplanung: (de Koster et al. 2007).
- Routing und Lagerplatzvergabe: (Ratliff and Rosenthal 1983); (Hall 1993); (Petersen and Schmenner 1999).
Fallstudie – SushiFresh GmbH
Sushi@Home: Das neue Kommissionierlager in Raunheim
Ausgangslage
SushiFresh setzt eine der Wachstumsideen aus der Einheit Distributionsstrukturen um: den Onlineshop Sushi@Home mit Kits zum Selbermachen, Saucen, Getränken und Zubehör. Dafür entsteht in Raunheim ein Fachbodenlager mit 8 Gängen und 192 Fächern für 192 Artikel.
Problem nach dem Start
Rund 300 Aufträge pro Tag mit Ø 7,5 Positionen. Die Artikel wurden eingelagert, „wo gerade Platz war“. Die Picker laufen lange Wege, der Versand am Nachmittag wird knapp.
Fragen
- Welcher Lagertyp und welches Kommissionierverfahren passen?
- Welcher Artikel gehört auf welchen Platz?
- In welcher Reihenfolge sollen die Picker die Fächer anlaufen?
Lagerfunktionen und Lagerprozesse
Warum und wie gelagert wird
Funktionen eines Lagers
- Ausgleich: Mengen und Zeitpunkte von Zu- und Abgängen entkoppeln (Losgrößen, Saison)
- Sicherung: Schutz gegen Nachfrage- und Lieferunsicherheit (Einheit Pooling)
- Sortimentsbildung: aus sortenreinen Lieferungen kundenspezifische Aufträge zusammenstellen
- Veredelung: Reifen, Konfektionieren, Verpacken
Reserve- und Kommissionierlager
Häufig werden Reservelager (Paletten, große Mengen, platzsparend) und Kommissionierlager (Anbruchmengen, gut erreichbar) getrennt. Der Nachschub füllt die Kommissionierplätze auf. Bei SushiFresh: Palettenregal für Reis-Säcke und Getränke, Fachbodenregal für die Kommissionierung.
Lagertypen
Statische Lagersysteme im Überblick
| Lagertyp | Ladeeinheit | Zugriff | Flächennutzung | Automatisierung | Geeignet für |
|---|---|---|---|---|---|
| Bodenlager (Block) | Paletten, Säcke | nur obere/vordere Einheit (LIFO) | sehr hoch | keine | wenige Artikel, große Mengen |
| Bodenlager (Zeile) | Paletten | jede Einheit | mittel | keine | mittlere Artikelzahl |
| Palettenregal | Paletten | jede Palette | mittel | Stapler | breites Sortiment, Reserve |
| Durchlaufregal | Paletten, Behälter | FIFO (Ein- und Ausgabeseite getrennt) | hoch | Schwerkraft | Frische, Haltbarkeit (FIFO) |
| Fachbodenregal | Kartons, Kleinteile | jedes Fach | gering | manuell | manuelle Kommissionierung |
| Hochregallager (HRL) | Paletten | jede Palette (RBG) | sehr hoch | vollautomatisch | hohe Durchsätze, große Bestände |
Auswahlkriterien
Artikelzahl, Menge je Artikel, Zugriffshäufigkeit, Ladeeinheit, Haltbarkeit (FIFO, Mindesthaltbarkeit), Temperaturzone, Investitionsbudget.
SushiFresh
Fachbodenregal für die Kommissionierung. Für kühlpflichtige Kit-Bestandteile ein Durchlaufregal in der Kühlzelle: Die Befüllung von hinten sichert FIFO.
Lagertypen
Automatisierte Systeme: Ware zur Person
| System | Prinzip | Stärke | Schwäche |
|---|---|---|---|
| Automatisches Kleinteilelager (AKL) | Regalbediengerät bringt Behälter zum Pickplatz | kompakt, bewährt | Investition, begrenzter Durchsatz je Gasse |
| Shuttle-System | Shuttle je Ebene, sehr hohe Behälterdurchsätze | Durchsatz | hohe Investition |
| Würfelspeicher (z. B. AutoStore) | Behälter gestapelt, Roboter greifen von oben | Flächennutzung, modular | Zugriff auf untere Behälter dauert |
| Liftsystem / Paternoster | Tablare werden zur Bedienöffnung gefahren | günstiger Einstieg, kompakt | geringe Leistung |
| Autonome mobile Roboter (AMR) | Roboter fahren Regale oder Behälter zum Picker | flexibel, skalierbar | Software, Flottenmanagement |
Bei Ware-zur-Person entfallen die Wege des Pickers. Picker Routing wird dann zur Reihenfolgeplanung der Behälter. Investitionen lohnen sich bei hohen Auftragszahlen und stabiler Auslastung. Für 300 Aufträge pro Tag bleibt SushiFresh zunächst bei Person-zur-Ware.
Lagerplatzvergabe
Feste, chaotische und zonierte Lagerplatzvergabe
| Strategie | Regel | Vorteil | Nachteil |
|---|---|---|---|
| Feste Lagerplatzvergabe | Jeder Artikel hat einen festen Platz | Picker kennen die Plätze, kein IT-System nötig | Platz für den Maximalbestand jedes Artikels nötig |
| Chaotische (freie) Lagerplatzvergabe | Einlagerung auf irgendeinen freien Platz | hohe Flächennutzung, flexibel bei Sortimentswechsel | Lagerverwaltungssystem (LVS) zwingend, Wege nicht gesteuert |
| Zonierte Vergabe (z. B. ABC-Zonen) | Feste Zone je Klasse, innerhalb der Zone frei | kurze Wege für Schnelldreher bei guter Flächennutzung | Klassen pflegen, Umlagerungen bei Nachfrageänderung |
Platzbedarf
- fest: \(\displaystyle \sum_i \max_t B_{i}(t)\)
- chaotisch: \(\displaystyle \max_t \sum_i B_{i}(t)\)
mit Bestand \(B_i(t)\) von Artikel \(i\) in Lagerplätzen
Da nicht alle Artikel gleichzeitig ihren Höchstbestand haben, gilt immer: chaotisch ≤ fest. Im Mittel ist bei gleichmäßigem Abbau nur gut die Hälfte des Maximalbestands belegt, die chaotische Lagerung muss aber die gemeinsame Spitze abdecken.
Lagerplatzvergabe
Beispiel: Platzbedarf im Reservelager
Zwölf Artikel im Reservelager, Bestand jeweils sägezahnförmig zwischen Bestellmenge \(Q_i\) und null (Bestellzyklus 6–14 Tage, zeitlich versetzt).
Ergebnis
- fest: \(\sum_i Q_i =\) 56 Plätze
- chaotisch: höchstens 44 Plätze gleichzeitig belegt (im Mittel nur 36)
- Ersparnis: 21 %
Bei synchronen Bestellungen (alle Artikel am selben Tag) schrumpft der Vorteil. Bei schwankender Nachfrage braucht auch die chaotische Lagerung einen Puffer.
Zugriffsorientierte Platzvergabe
ABC-Analyse der Zugriffe
Sushi@Home-Sortiment
- A-Artikel (20 % der Artikel): 69 % aller Picks, z. B. Sushi-Reis, Nori, Sojasauce
- B-Artikel (30 %): 17 % der Picks
- C-Artikel (50 %): 14 % der Picks, z. B. Zubehör, Geschirr
Grundregel
Schnelldreher gehören auf Plätze mit kurzem Weg (und in Griffhöhe), Langsamdreher dürfen weiter weg liegen. Was „kurzer Weg“ heißt, hängt aber von der Routingstrategie ab, dazu später mehr.
Zugriffsorientierte Platzvergabe
Cube-per-Order-Index (COI)
Idee (Heskett 1963): Artikel mit viel Platzbedarf belegen viele gute Plätze. Deshalb wird nicht nur die Zugriffshäufigkeit, sondern das Verhältnis aus Platzbedarf und Zugriffen betrachtet: \[\text{COI}_i = \frac{\text{Platzbedarf}_i}{\text{Zugriffe}_i}\] Artikel werden nach aufsteigendem COI den Plätzen mit den kürzesten Wegen zugeordnet.
Unter bestimmten Annahmen (Weg je Zugriff proportional zur Distanz des Platzes, Return-Routing) ist die COI-Regel optimal. Bei S-Shape-Routing oder Aufträgen mit vielen Positionen ist sie eine Heuristik.
| Artikel | Fächer | Zugriffe/Woche | COI (×10⁻³) | Rang nach Zugriffen | Rang nach COI |
|---|---|---|---|---|---|
| Sushi-Reis 1 kg | 4 | 900 | 4,44 | 1 | 4 |
| Nori-Blätter | 1 | 700 | 1,43 | 3 | 1 |
| Sojasauce | 2 | 800 | 2,50 | 2 | 3 |
| Stäbchen | 1 | 600 | 1,67 | 4 | 2 |
| Bambusmatte | 3 | 400 | 7,50 | 5 | 5 |
| Reiskocher | 6 | 60 | 100,00 | 6 | 6 |
Der Sushi-Reis wird am häufigsten gegriffen, braucht aber 4 Fächer. Nach COI erhalten Nori und Stäbchen die besten Plätze, der Reis rückt auf Rang 4.
Lagerplatzvergabe bei SushiFresh
Drei Varianten im Layout
Zufällig (chaotisch)
ABC am Gangkopf (vorne in allen Gängen)
ABC gangweise (A in den ersten Gängen)
■ A-Artikel ■ B-Artikel ■ C-Artikel. Innerhalb einer Zone werden die Artikel zufällig verteilt.
Beide ABC-Varianten bringen die Schnelldreher näher an das Depot, aber auf unterschiedliche Weise. Welche besser ist, entscheidet die Art, wie die Picker durch das Lager laufen.
Kommissionierung
Begriffe und Zeitanteile
Begriffe
- Kommissionierung: Zusammenstellen von Teilmengen aus einem Sortiment nach einem Auftrag
- Auftrag: Kundenauftrag bzw. Kommissionierauftrag
- Position: Auftragszeile (ein Artikel in bestimmter Menge)
- Pick: einzelner Greifvorgang
- Kommissionierleistung: Positionen bzw. Picks pro Stunde
Typische Aufteilung der Zeit eines Pickers bei Person-zur-Ware (de Koster et al. 2007).
Rund die Hälfte der Zeit entfällt auf das Gehen. Kürzere Wege durch gute Lagerplatzvergabe und Routing sind deshalb der größte Hebel für die Kommissionierleistung.
Kommissionierverfahren
Gestaltungsmöglichkeiten
| Merkmal | Varianten | Wirkung |
|---|---|---|
| Bereitstellung | Person-zur-Ware (statisch) · Ware-zur-Person (dynamisch) | Wegzeit vs. Investition |
| Auftragsbearbeitung | einstufig, auftragsweise: ein Auftrag pro Tour | einfach, kurze Durchlaufzeit je Auftrag |
| zweistufig, serienweise (Batch): mehrere Aufträge pro Tour, danach Sortieren | weniger Wege, aber Sortieraufwand und Fehlerrisiko | |
| Zonen | einzonig · mehrzonig (sequenziell weitergeben oder parallel und zusammenführen) | kurze Wege je Picker, Abstimmung nötig |
| Informationsbereitstellung | Papier-Pickliste · Scanner/MDE · Pick-by-Voice · Pick-by-Light · Datenbrille | Fehlerquote, Geschwindigkeit, Hände frei |
Kommissionierzeit eines Auftrags
\[t = t_{\text{Basis}} + \frac{w}{v} + n \cdot t_{\text{Pos}}\] Basiszeit \(t_{\text{Basis}}\), Weglänge \(w\), Gehgeschwindigkeit \(v\), Positionen \(n\) mit Greif- und Bestätigungszeit \(t_{\text{Pos}}\)
SushiFresh
Person-zur-Ware, einstufig, auftragsweise, eine Zone, Scanner (Artikel und Fach werden bestätigt). Nur die Weglänge \(w\) hängt von Lagerplatzvergabe und Routing ab.
Picker Routing
Ein TSP im Lager
Problemstellung: Gegeben ist eine Pickliste mit \(n\) Positionen. Gesucht ist die kürzeste Rundtour vom Depot zu allen Pickpositionen und zurück. Das ist ein Rundreiseproblem (Traveling Salesman Problem, TSP) auf einem speziellen Graphen aus Gängen und Quergängen. Allgemein behandeln wir das TSP später in der Einheit Tourenplanung.
Annahmen (Ein-Block-Layout)
- parallele Gänge, Quergang vorne und hinten
- Picker greift beidseitig, Gangbreite vernachlässigt
- Depot am vorderen Quergang links
Distanz zwischen Pickpositionen \((x_1, y_1)\) und \((x_2, y_2)\):
- gleicher Gang: \(d = |y_1 - y_2|\)
- verschiedene Gänge: \(d = |x_1 - x_2| + \min\big(y_1 + y_2,\; 2Y - y_1 - y_2\big)\)
(Umweg über vorne oder hinten; \(Y\) = Lage des hinteren Quergangs)
Lösungswege
- Optimal: Für dieses Layout gibt es ein effizientes exaktes Verfahren (dynamische Programmierung) (Ratliff and Rosenthal 1983). Alternativ: allgemeine TSP-Heuristiken auf der Distanzmatrix (später in der Einheit Tourenplanung)
- Einfache Routingstrategien: S-Shape, Return, Midpoint, Largest Gap (Hall 1993)
Warum einfache Strategien?
Picker folgen in der Praxis lieber leicht merkbaren Mustern. Optimale Touren wirken oft unlogisch, werden nicht eingehalten und führen in engen Gängen zu Staus.
Picker Routing
Beispielauftrag bei chaotischer Lagerung
| Nr. | Artikel | Menge | Klasse | Gang | Fach |
|---|---|---|---|---|---|
| 1 | Sushi-Reis 1 kg | 2 | A | 6 | L1 |
| 2 | Sojasauce 150 ml | 3 | A | 2 | R9 |
| 3 | Stäbchen 10 Paar | 1 | A | 7 | R8 |
| 4 | Bambusmatte | 1 | A | 3 | L10 |
| 5 | Sriracha-Sauce | 1 | A | 1 | L12 |
| 6 | Sushi-Bazooka | 1 | B | 6 | R4 |
| 7 | Reis-Messbecher | 1 | B | 8 | L7 |
| 8 | Keramik-Sojaschale | 2 | C | 6 | L9 |
Auftrag 4711 von Sushi@Home: ein „Starter-Kit“ mit Zubehör. Die Artikel liegen verstreut über 6 Gänge.
Routingstrategie S-Shape
Jeden Gang mit Picks vollständig durchlaufen
Regel (auch: Traversal)
- Jeder Gang mit mindestens einem Pick wird vollständig durchlaufen, abwechselnd nach hinten und nach vorne.
- Bei ungerader Gangzahl wird der letzte Gang nur bis zum hintersten Pick betreten (Hin und Zurück).
- Gänge ohne Pick werden übersprungen.
Bewertung
Weglänge: 184,0 m. Einfach zu merken und gut bei vielen Picks pro Gang. Bei wenigen, weit vorne liegenden Picks wird viel unnötig gelaufen.
Routingstrategie Return
Jeden Gang von vorne betreten und umkehren
Regel
- Jeder Gang mit Picks wird vom vorderen Quergang betreten.
- Der Picker geht bis zum hintersten Pick des Gangs und kehrt um.
- Der hintere Quergang wird nie benutzt.
Bewertung
Weglänge: 232,0 m. Gut, wenn Picks nahe am vorderen Gangende liegen. Bei Picks tief im Gang wird jeder Meter doppelt gelaufen.
Routingstrategie Largest Gap
Die größte Lücke im Gang nicht laufen
Regel (Hall 1993)
- Erster und letzter Gang mit Picks werden vollständig durchlaufen.
- In den Gängen dazwischen wird die größte Lücke bestimmt: zwischen benachbarten Picks bzw. zu den Quergängen.
- Picks vor der Lücke werden vom vorderen, Picks dahinter vom hinteren Quergang aus geholt (jeweils hin und zurück).
Bewertung
Weglänge: 166,5 m. Etwas schwerer zu merken, schneidet aber in Studien meist am besten unter den einfachen Strategien ab.
Optimale Tour
Exakte Lösung durch vollständige Enumeration
| Strategie | Weglänge | über Optimum |
|---|---|---|
| S-Shape | 184,0 m | +16 % |
| Return | 232,0 m | +46 % |
| Largest Gap | 166,5 m | +5 % |
| Optimal (TSP) | 159,0 m | +0 % |
Beobachtung
Die optimale Tour (40.320 mögliche Reihenfolgen geprüft) kombiniert Elemente der einfachen Strategien: manche Gänge werden durchlaufen, andere von vorne oder hinten angelaufen.
Für größere Aufträge: Ratliff-Rosenthal-Algorithmus oder TSP-Heuristiken wie Nearest Neighbor + 2-opt (behandelt in der späteren Einheit Tourenplanung).
Picker Routing in R
Implementierung der Strategien
# pk: Picks mit Gang (gang) und Tiefe (y)
# Ergebnis: Wegpunkte ab/bis Depot (0, 0)
route_sshape <- function(pk) {
  g <- sort(unique(pk$gang)); m <- length(g)
  wp <- list(c(0, 0)); vorne <- TRUE
  for (k in seq_len(m)) {
    x <- gang_x[g[k]]; ys <- pk$y[pk$gang == g[k]]
    if (k == m && m %% 2 == 1) {        # letzter Gang:
      wp <- c(wp, list(c(x, 0), c(x, max(ys)), c(x, 0)))
    } else if (vorne) {                 # nach hinten
      wp <- c(wp, list(c(x, 0), c(x, Y))); vorne <- FALSE
    } else {                            # nach vorne
      wp <- c(wp, list(c(x, Y), c(x, 0))); vorne <- TRUE
    }
  }
  do.call(rbind, c(wp, list(c(0, 0))))
}
route_return <- function(pk) {
wp <- list(c(0, 0))
for (j in sort(unique(pk$gang))) {
x <- gang_x[j]
wp <- c(wp, list(c(x, 0),
c(x, max(pk$y[pk$gang == j])),
c(x, 0)))
}
do.call(rbind, c(wp, list(c(0, 0))))
}
# Weglänge: Summe der Rechteck-Abstände
weg_laenge <- function(wp)
sum(abs(diff(wp[, 1])) + abs(diff(wp[, 2])))Alle Strategien liefern Wegpunkte. Daraus ergeben sich Weglänge und Grafik. Largest Gap und die TSP-Lösung sind im Quellcode der Folien enthalten.
Lagerplatzvergabe und Routing
Simulation mit 300 Aufträgen
Ergebnisse
- S-Shape profitiert von gangweiser ABC-Zonierung: Schnelldreher in wenigen Gängen → wenige Gänge zu durchlaufen.
- Return profitiert von ABC am Gangkopf: Schnelldreher vorne → kurze Stichwege.
- Die falsche Kombination verschenkt einen Großteil des Potenzials.
- NN + 2-opt ist eine allgemeine TSP-Heuristik (Nearest Neighbor als Startlösung, verbessert durch 2-opt; Details in der späteren Einheit Tourenplanung) und dient hier als Referenz nahe am Optimum.
Lagerplatzvergabe und Routing müssen gemeinsam geplant werden (Petersen and Schmenner 1999). Bestes Paar hier: ABC gangweise + NN + 2-opt mit Ø 111 m statt 159 m heute.
Kommissionierleistung bei SushiFresh
Was bringen die kürzeren Wege?
| Szenario | Weg (m) | Zeit/Auftrag (s) | Anteil Weg | Aufträge/h | Picker-Std./Tag |
|---|---|---|---|---|---|
| Heute: zufällig + S-Shape | 159 | 333 | 59 % | 10,8 | 27,8 |
| ABC gangweise + S-Shape | 129 | 296 | 54 % | 12,2 | 24,7 |
| ABC gangweise + Largest Gap | 118 | 282 | 52 % | 12,7 | 23,5 |
| ABC gangweise + NN + 2-opt | 111 | 274 | 51 % | 13,1 | 22,8 |
Annahmen: \(v\) = 0,8 m/s mit Wagen, \(t_{\text{Basis}}\) = 60 s, \(t_{\text{Pos}}\) = 10 s, Ø 7,5 Positionen, 300 Aufträge pro Tag.
Ergebnis
Allein durch Umlagern der Artikel und eine feste Laufregel sinkt der Personalbedarf von 27,8 auf 23,5 Picker-Stunden pro Tag (15 %), ohne Investition in Technik.
Umsetzung
Die ABC-Zonierung erfordert eine einmalige Umlagerung und eine regelmäßige Überprüfung der Klassen (z. B. quartalsweise, Saisonartikel!). Das Lagerverwaltungssystem sortiert die Pickliste in Laufreihenfolge.
Sammelkommissionierung
Mehrere Aufträge in einer Tour
Prinzip
Der Picker holt die Positionen mehrerer Aufträge in einer Tour (z. B. Wagen mit mehreren Kisten). Danach wird nach Aufträgen getrennt, entweder direkt am Wagen (pick and sort) oder in einem zweiten Schritt.
Beispiel (ABC gangweise, Largest Gap)
- Auftrag 1 allein: 138 m
- Auftrag 2 allein: 141 m
- Beide zusammen: 162 m statt 280 m (42 % weniger)
Batchbildung ist selbst ein Optimierungsproblem, z. B. per Savings-Logik (Ausblick in der späteren Einheit Tourenplanung): Aufträge mit überlappenden Gängen kombinieren.
Kernaussagen
Das Wichtigste in Kürze
- Lager gleichen aus, sichern ab und bilden Sortimente. Der Lagertyp richtet sich nach Ladeeinheit, Artikelzahl, Zugriffshäufigkeit und Haltbarkeit (FIFO).
- Chaotische Lagerplatzvergabe spart Fläche (SushiFresh-Beispiel: 21 %), zugriffsorientierte Vergabe (ABC, COI) spart Wege.
- Die Kommissionierung ist der teuerste Lagerprozess. Rund die Hälfte der Zeit ist Wegzeit.
- Picker Routing ist ein TSP im Lager. Einfache Strategien (S-Shape, Return, Largest Gap) sind praxistauglich und oft nahe am Optimum.
- Lagerplatzvergabe und Routing müssen zusammenpassen: S-Shape mit gangweiser Zonierung, Return mit Zonierung am Gangkopf.
- Sammelkommissionierung reduziert die Wege weiter, erfordert aber Sortieraufwand.
Übung
Übungsaufgaben zu dieser Einheit
Aufgaben zur Klausurvorbereitung (Teil 1) und eine vertiefende Fallstudie (Teil 2) finden Sie in Fallstudie 7: Lagerplanung und Kommissionierung.
Distributionslogistik - Verkehrsmittel, Antriebe und Kosten
Distributionslogistik
- Lager und Kommissionierung
- Verkehrsmittel, Antriebe und Kosten
Lernziele
Nach dieser Einheit können Sie …
- Verkehrsträger, Verkehrsmittel und Antriebstechnologien unterscheiden und für eine Transportaufgabe auswählen,
- die Einschränkungen batterieelektrischer Fahrzeuge, von Lastenrädern und Drohnen für die Transport- und Tourenplanung ableiten,
- Transportkostensätze berechnen, Antriebe über die Gesamtkosten (TCO) und Eigen- vs. Fremdtransport vergleichen,
- Transportemissionen nach ISO 14083 berechnen und Sendungen zuordnen.
Literatur zur Vertiefung: Verkehrsträger (Chopra and Meindl 2025; Günther and Tempelmeier 2012), E-VRP (Schneider et al. 2014), Lkw-Drohnen-Kombination (Murray and Chu 2015), Emissionsbilanzierung (ISO 2023; Smart Freight Centre 2023).
Fallstudie – SushiFresh GmbH
Drei Transportentscheidungen
1. Beschaffung
Der Lachs kommt aus Norwegen (ca. 1.700 km). Bisher per Kühl-Lkw mit Fähre. Ein Lieferant bietet eine Kombination aus Lkw und Bahn an.
Welcher Verkehrsträger passt zu Frischfisch?
2. Fuhrpark
Das Leasing des 7,5-t-Diesel-Kühl-Lkw läuft aus. Alternative: ein batterieelektrischer Kühl-Lkw.
Was kostet das, und wie weit kommt ein E-Kühl-Lkw überhaupt?
3. Letzte Meile
Pilot für einen Lieferdienst an Endkunden in Frankfurt. Im Gespräch: E-Transporter, Lastenrad oder sogar Drohne.
Was ist pro Zustellung am günstigsten?
Dazu brauchen wir einen Überblick über Verkehrsträger und Antriebe und ein Werkzeug zur Berechnung von Transportkostensätzen. Die bisher verwendeten Kostensätze (z. B. 0,02 €/(Box·km) aus Einheit Standortplanung II) werden wir dabei nachrechnen.
Begriffe
Verkehrsträger, Verkehrsmittel, Ladeeinheiten
Verkehrsträger
Infrastruktur, auf der Verkehr stattfindet:
- Straße
- Schiene
- Wasser (Binnen-, Seeschifffahrt)
- Luft
- Rohrleitung
Verkehrsmittel
Fahrzeuge, die Güter bewegen:
- Lastenrad, Transporter, Lkw, Sattelzug
- Güterzug (Ganzzug, Einzelwagen)
- Binnen- und Seeschiff
- Frachtflugzeug, Drohne
Ladeeinheiten
Standardisierte Behälter, die zwischen Verkehrsmitteln wechseln:
- Palette, Rollcontainer
- Wechselbrücke, Sattelauflieger
- ISO-Container (TEU/FEU)
Verkehrsketten
- Unimodal: ein Verkehrsträger
- Multimodal: mehrere Verkehrsträger
- Intermodal / kombinierter Verkehr: mehrere Verkehrsträger mit derselben Ladeeinheit, ohne die Ware umzuladen
Verkehrsträger im Vergleich
Kennzahlen & Charakteristika
| Verkehrsträger | Typische Einheit | Geschwindigkeit | Netz | Kosten (€/tkm) | THG (g CO₂e/tkm) | Typische Güter |
|---|---|---|---|---|---|---|
| Straße | Sattelzug ~25 t Nutzlast | 60–80 km/h | sehr dicht | ~0,10–0,15 | ~110–120 | Stückgut, Frische, Teilladungen |
| Schiene | Ganzzug ~1.000–2.000 t | 40–60 km/h | mittel | ~0,05–0,08 | ~16–18 | Massengut, Container, Autos |
| Binnenschiff | Großmotorgüterschiff ~2.000–3.000 t | 10–20 km/h | dünn (Wasserstraßen) | ~0,02–0,03 | ~31–33 | Massengut, Container |
| Seeschiff | Containerschiff bis ~240.000 t | 25–40 km/h | Häfen | ~0,005–0,01 | ~5–20 | Container, Massengut |
| Luft | Frachtflugzeug ~100–120 t | 800–900 km/h | Flughäfen | ~0,3–0,6 | ~500–1.000 | hochwertig, eilig, verderblich |
Lesart
Kein Verkehrsträger dominiert. Die Wahl hängt vom Produkt ab (Wert, Verderblichkeit, Gewicht), von der Entfernung und von der Bedeutung der Lieferzeit (vgl. Strategic Fit).
Hinweis THG-Raten & Kostensätze
Emissionsraten sind grobe Näherung basierend auf TREMOD (Umweltbundesamt 2024). Diese hängen stark von der Auslastung/Beladung und den technischen Details der eingesetzten Fahrzeuge ab. Ähnliches gilt für die Kostensätze.
Logistikdienstleister
Wer bietet Transportleistungen an?
| Akteur | Leistung | Vertrag | Beispiel SushiFresh |
|---|---|---|---|
| Frachtführer | führt die Beförderung selbst durch (eigene Fahrzeuge) | Frachtvertrag (§ 407 HGB) | regionaler Kühltransporteur |
| Spediteur | organisiert die Beförderung im eigenen Namen, beauftragt Frachtführer | Speditionsvertrag (§ 453 HGB) | organisiert den Lachs aus Norwegen |
| KEP-Dienst | Kurier-, Express-, Paketsendungen in eigenen Netzen (Hub-and-Spoke) | Frachtvertrag, AGB | Versand Sushi@Home (Einheit Lager und Kommissionierung) |
| Kontraktlogistiker (3PL) | langfristige, kundenspezifische Leistungsbündel: Lager, Kommissionierung, Transport, Mehrwertdienste | individueller Logistikvertrag | Betrieb des Sushi@Home-Lagers? |
| 4PL / Lead Logistics Provider | steuert das gesamte Logistiknetz inkl. weiterer Dienstleister, oft ohne eigene Anlagen | Rahmenvertrag | für SushiFresh zu groß |
| Digitale Spedition / Frachtbörse | Plattform vermittelt Ladungen und Laderaum, oft mit Echtzeit-Preisen | Vermittlung bzw. Spedition | Zusatztouren in der Saison |
Der Logistikmarkt ist sehr fragmentiert: viele kleine Frachtführer und wenige große Netzwerkanbieter. Für Verlader bedeutet das: Preise und Kapazitäten schwanken stark mit Saison, Dieselpreis und Fahrermangel.
Kombinierter Verkehr
Wann lohnt sich die Bahn im Hauptlauf?
Kostenstruktur (je Ladeeinheit, z. B. Sattelauflieger)
- Straße direkt: \(K_S = k_S \cdot d_S\)
- Kombiniert: \(K_{KV} = 2 \cdot u + k_Z \cdot (d_V + d_N) + k_B \cdot d_B\)
typische Kosten- & Distanzstrukturen
- \(d_S < d_V+d_N+d_B\) und \(d_S \approx d_B\)
- \(k_B < k_S < k_Z\)
- \(u\) … Umladekosten
Sei \(d_B = d_S = d\) und \(d_V+d_N = \alpha \cdot d\), dann gilt für die Break-Even-Distanz: \[d^*=\frac{2 \cdot u}{k_S-k_B-\alpha\cdot k_Z}\] Hierbei ist \(\alpha<1\) der Umwegfaktor. Der maximal erlaubte Umweg ist dabei \(\alpha < \frac{k_S - k_B}{k_Z}\)
Straßengüterverkehr
Fahrzeugklassen & Antriebe
| Fahrzeug | zul. Gesamtgewicht | Nutzlast | Paletten | Führerschein | Lkw-Maut | Typischer Einsatz |
|---|---|---|---|---|---|---|
| Lastenrad | bis ~0,4 t (System) | 100–250 kg | – | keiner (Pedelec) | nein | Innenstadt, KEP |
| Transporter (N1) | bis 3,5 t | ~1 t | 3–5 | B | nein | KEP, Handwerk, letzte Meile |
| Leichter Lkw (N2) | 7,5 t | ~2–3 t | 8–15 | C1 | ja (> 3,5 t) | Filialbelieferung, Kühlverteilung |
| Motorwagen (N3) | 12–26 t | ~5–15 t | 15–20 | C | ja | Regionalverteilung |
| Sattelzug (N3) | 40 t (E-Lkw: bis 42 t) | ~25 t | 33 | CE | ja | Fernverkehr, Hauptlauf |
| Antrieb | Energieträger | Reichweite | Tanken/Laden | Infrastruktur | Lkw-Maut 2026 |
|---|---|---|---|---|---|
| Diesel (fossil) | Diesel | > 1.500 km | Minuten | flächendeckend | voll |
| HVO / Biodiesel | Diesel aus Rest-/Abfallstoffen | > 1.500 km | Minuten | wachsend | voll |
| Bio-LNG / CNG | Methan (fossil/biogen) | ~1.000 km | Minuten | dünn | voll |
| Batterieelektrisch (BEV) | Strom aus Batterie | ~200–500 km | 45 min (MCS) bis Stunden | Depot + wachsend | befreit bis 06/2031 |
| Brennstoffzelle (FCEV, H₂) | Wasserstoff → Strom | ~400–800 km | ~15 min | sehr dünn | befreit bis 06/2031 |
| Oberleitung (O-Lkw) | Strom aus Fahrdraht + Batterie | unbegrenzt unter Draht | während der Fahrt | Teststrecken (z. B. A5 Hessen) | befreit bis 06/2031 |
Planungsrelevante Parameter allgemein
Kapazität (Gewicht, Fläche, Volumen), Fahrerqualifikation, Maut, Zufahrts- und Durchfahrtsverbote, Lenk- und Ruhezeiten (ab 3,5 t: nach 4,5 h Lenkzeit 45 min Pause).
Planungsrelevante Parameter BEV
begrenzte Reichweite, lange Ladezeiten, Ladeinfrastruktur, höheres Gewicht
Batterieelektrische Lkw
Technik und Rahmenbedingungen 2026
Technik (schwerer Fernverkehr)
- Batterien ~500–800 kWh, Herstellerreichweite ~500 km bei 40 t, in der Praxis 15–30 % weniger
- Verbrauch ~1,2–1,8 kWh/km (Last, Wetter, Tempo, Topografie)
- Laden: Depot über Nacht (50–150 kW), unterwegs CCS bis ~400 kW oder Megawatt Charging (MCS)
- Kaufpreis etwa das 2-Fache eines Diesel-Sattelzugs
Rahmenbedingungen in Deutschland
- Lkw-Maut: emissionsfreie Lkw sind bis 30.06.2031 befreit (SIHK zu Hagen 2026). Diesel-Sattelzug (Euro VI, CO₂-Klasse 1): 34,8 ct/km (Toll Collect GmbH 2024)
- Gewicht: bis zu 2 t Zusatzgewicht für emissionsfreie Lkw (z. B. 42 statt 40 t). Die Revision der EU-Richtlinie 96/53/EG sieht je nach Achskonfiguration Zuschläge bis 4 t vor, die Umsetzung steht noch aus.
- Strom: Depot ~20–28 ct/kWh netto, öffentliches Schnellladen ~38–60 ct/kWh netto
Batterieelektrische Lkw
Was beeinflusst die Reichweite?
Einflussfaktoren
- Masse: Beladung, Batteriegewicht
- Geschwindigkeit: Luftwiderstand steigt quadratisch
- Topografie: Steigungen; bergab Rückgewinnung (Rekuperation)
- Temperatur: Batterieleistung und Heizung im Winter
- Nebenverbraucher: Kühlaggregat, Ladebordwand
Beim Diesel spielt das für die Planung kaum eine Rolle (Tank reicht). Beim E-Lkw kann es über die Zulässigkeit einer Tour entscheiden.
Letzte Meile
Warum die letzten Kilometer so teuer sind
Merkmale
- viele Stopps mit kleinen Sendungen → keine Bündelung
- Parkplatzsuche, Halten in zweiter Reihe, Fußwege
- Zeitfenster und Nicht-Antreffen (Zweitzustellung)
- Zufahrtsbeschränkungen, Umweltzonen, Fußgängerzonen
- hoher Personalkostenanteil → Kosten in € pro Stopp bzw. € pro Sendung
Neue Optionen
- Lastenrad mit Mikrodepot (Container, Ladenfläche)
- E-Transporter (emissionsfrei und mautbefreit)
- Paketstationen und Abholpunkte
- autonome Drohnen und Lieferroboter
Letzte Meile
Mikrodepots mit Lastenrädern und autonome Fahrzeuge
alternative Zustellfahrzeuge
- benötigen ein Mikrodepot zum Umschlag
- 2-stufiges Problem: Depot → Mikrodepot → Kunde
- meist Steuerung über Infrastrukturzugang
- Kosten meist höher als bei 1-stufiger Letzten Meile → Ausnahme: Personalkosteneisparung bei autonomen Fahrzeugen
| Option | Kapazität | Geschwindigkeit | Reichweite | Wichtigste Restriktion | Planungsmodell |
|---|---|---|---|---|---|
| Lastenrad | 100–250 kg | bis 25 km/h, Radwege | ~40–80 km | Kapazität, Wetter, Mikrodepot nötig | 2E-VRP |
| Drohne | 2–5 kg | schnell, luftlinienartig | ~10–40 km | Genehmigung, Wetter, Gewicht | TSP-D / FSTSP |
| Lieferroboter | ~20–50 kg | Schritttempo | wenige km | Gehwegrecht, Treppen, Vandalismus | Roboter-VRP |
Transportkostensätze
Grundlagen der Fahrzeugkostenrechnung
Fixe (nutzungsunabhängige) Kosten pro Jahr
- Abschreibung (AfA): \(\dfrac{A - RW}{N}\)
- kalkulatorische Zinsen: \(\dfrac{A + RW}{2} \cdot i\)
- Versicherung, Kfz-Steuer
- anteilige Gemeinkosten (Disposition, Verwaltung, Infrastruktur)
Variable (wegabhängige) Kosten pro km
- Energie: Verbrauch × Preis (Diesel bzw. Strom)
- Wartung und Reparatur
- Reifen
- AdBlue, Schmierstoffe
- Maut: Mautsatz × Anteil mautpflichtiger Strecke
Variable (zeitabhängige) Kosten pro Stunde
- Fahrerpersonal (Lohn + Nebenkosten)
Kostensätze
\[k_{km} = \frac{K_{fix}}{L_{Jahr}} + k_{var} \qquad\qquad k_{h} = \frac{K_{Personal}}{T_{Jahr}} \qquad\qquad k_{tkm} = \frac{k_{km}}{m \cdot \alpha \cdot (1 - \lambda)}\] mit Jahresfahrleistung \(L\), produktiven Stunden \(T\), Nutzlast \(m\) (t), Auslastung \(\alpha\) und Leerfahrtanteil \(\lambda\).
Beispiel 1 – Diesel-Kühl-Lkw
Kostensätze für den 7,5-Tonner von SushiFresh
Sushi-Fresh-Distribution ab Raunheim
Sushi-Fresh beliefert von Raunheim aus alle Filialen durch Pendeltouren. Insgesamt sind pro Arbeits-Tag damit 204 km zu fahren. Dazu wird ein 7,5-t-Kühltransporter an 300 Arbeits-Tagen eingesetzt.
| Kalkulationsposition | Wert |
|---|---|
| Anschaffung A / Restwert RW / Nutzung N | 95.000 € / 15.000 € / 6 J. |
| Abschreibung (A − RW)/N | 13.333 € |
| Kalk. Zinsen (A + RW)/2 · 5 % | 2.750 € |
| Versicherung + Kfz-Steuer | 5.000 € |
| Gemeinkosten (Fahrzeuganteil) | 6.000 € |
| Fixkosten Fahrzeug pro Jahr | 27.083 € |
| Diesel 17 l/100 km × 2,00 €/l | 0,340 €/km |
| Wartung + Reifen | 0,120 €/km |
| Maut 15,1 ct/km × 50 % | 0,075 €/km |
| Variable Kosten pro km | 0,536 €/km |
Kostensätze (Pendelverkehr, 61.326 km/Jahr)
- Fahrzeug fix: 90,28 €/Tag bzw. 0,442 €/km
- Fahrzeug gesamt: 0,977 €/km
- Fahrer: 52.000 € / 1650 h = 31,52 €/h
Zweigliedriger Kostensatz
Für die Tourenplanung ist die Trennung in €/km (Fahrzeug, variabel) und €/h (Fahrer + fixe Fahrzeugkosten je Einsatzstunde) üblich, denn Touren unterscheiden sich in Strecke und Dauer.
Beispiel 1 – Diesel-Kühl-Lkw
Was kostet eine Box? Nachrechnen des Satzes aus Einheit Standortplanung II
Sushi-Fresh-Distribution ab Raunheim
Die ersten Einschätzungen gehen davon aus, dass der 7,5-t-Kühltransporter die Pendeltouren mit einer Durchschnittsgeschwindigkeit von 45 km/h zurücklegt. Die Beladung in Raunheim dauert jedes Mal 15 Minuten, die Entladung in jeder Filiale 15 Minuten.
| Variante | km/Tag | h/Tag | Fahrzeug fix (€) | Fahrzeug var. (€) | Fahrer (€) | Gesamt (€/Tag) | €/Box |
|---|---|---|---|---|---|---|---|
| Pendelverkehr | 204 | 7,5 | 90,28 | 109,47 | 237,71 | 437,45 | 0,518 |
Kostensatz je Box und km
Im Pendelverkehr legen alle Boxen zusammen \(\sum_j \mu_j \cdot d_{Rj} =\) 12.835 beladene Box-km zurück (Rückfahrt leer): \[\frac{437{,}45\ \text{€}}{12.835\ \text{Box-km}} \approx 0{,}034\ \text{€}/(\text{Box} \cdot \text{km})\] Das liegt über der Annahme von 0,02 €/(Box·km) aus Einheit Standortplanung II. Woher könnte die Differenz stammen?
Beispiel 2 – Diesel oder E-Lkw?
Jahreskosten des E-LKW
Sushi-Fresh-Distribution ab Raunheim mit E-LKW
Als Alternative zum Diesel 7,5-t-Diesel-Lkw erwägt Sushi-Fresh einen 7,5-t-E-LKW einzusetzen. Das entsprechende Modell verbraucht 66 kWh/100 km (Jahresmittel inkl. Kühlung). Der E-LKW soll über Nacht im Depot zu 0,24 €/kWh geladen werden. Der Depot-Ladepunkt schlägt mit 3.500 €/Jahr zu buche.
| Kalkulationsposition | Wert |
|---|---|
| Anschaffung A / Restwert RW / Nutzung N | 170.000 € / 30.000 € / 6 |
| Abschreibung (A − RW)/N | 23.333 € |
| Kalk. Zinsen (A + RW)/2 · 5 % | 5.000 € |
| Versicherung + Kfz-Steuer | 5.000 € |
| Gemeinkosten (inkl. Ladepunkt) | 9.500 € |
| Fixkosten Fahrzeug pro Jahr | 42.833 € |
| Energiekosten | 0,158 €/km |
| Wartung + Reifen | 0,090 €/km |
| Maut | 0,000 €/km |
| Variable Kosten pro km | 0,248 €/km |
Beispiel 2 – Diesel oder E-Lkw?
Break-even-Fahrleistung
Interpretation
- E-Lkw: hohe Fixkosten, niedrige variable Kosten → lohnen sich bei hoher Fahrleistung
- Break-even bei ca. 55 Tsd. km/Jahr
- bei der aktuellen Fahrleistung (61,3 Tsd. km/Jahr) lohnt sich der E-Lkw
- Unsicherheit bestehen durch:
- Reichweite
- Mischkalkulation bei externen Laden
- Lebensdauer und Wartungskosten (Batteriedegradation)
- weitere mögliche Kostenkompoente: Opportunitätskosten der entgangenen Stromeinspeisevergütung
CO₂-Bilanzierung von Transporten
Warum und nach welchem Standard?
Anlass
- Transporte sind für die meisten Unternehmen Scope-3-Emissionen (außer z.B. Logistikunternehmen und Selbsterbringung)
- Händler fragen oft Emissionen je Sendung bei ihren Lieferanten ab
- Vergleich von Alternativen: Verkehrsträger, Antriebe, Touren
- Logistikdienstleister müssen ihren Kunden vergleichbare Werte liefern
ISO 14083:2023
Internationale Norm zur Quantifizierung und Berichterstattung von Treibhausgasemissionen aus Transportketten (ISO 2023):
- alle Verkehrsträger und Umschlagpunkte (Hubs)
- Personen- und Güterverkehr
- Well-to-Wheel: Betrieb und Energiebereitstellung
- löst die europäische Norm EN 16258 ab
- Branchenleitfaden mit Default-Werten: GLEC Framework (Smart Freight Centre 2023)
Kernidee: Emissionen werden für Gruppen gleichartiger Transporte ermittelt und anschließend über die Transportleistung (tkm) fair auf einzelne Sendungen verteilt.
ISO 14083
Zentrale Begriffe
| Begriff | Bedeutung |
|---|---|
| Transportkette | alle Abschnitte einer Sendung vom Versender bis zum Empfänger |
| Transportkettenelement (TCE) | ein Abschnitt: eine Fahrt mit einem Verkehrsmittel oder ein Umschlag |
| Transport-Vorgangskategorie (TOC) | Gruppe gleichartiger Transporte (z. B. alle Filialtouren des Kühl-Lkw) |
| Hub-Vorgangskategorie (HOC) | Gruppe gleichartiger Umschlagvorgänge (z. B. Kühllager, Cross-Dock) |
| Well-to-Tank (WTT) | Emissionen der Energiebereitstellung (Förderung, Raffinerie, Kraftwerk) |
| Tank-to-Wheel (TTW) | Emissionen im Fahrzeug (Verbrennung) |
| Well-to-Wheel (WTW) | WTT + TTW, verpflichtend auszuweisen |
| Transportaktivität | Masse × Allokations-Distanz (tkm), Allokations-Distanz = kürzeste realisierbare Entfernung (SFD), Luftverkehr: Großkreisdistanz (GCD) |
Transportkette kombinierter Verkehr
Für die Allokation der Emissionen wird die kürzeste realisierbare Distanz (SFD) vom Versandort zum Zielort verwendet. Diese Allokations-Distanzen sind unabhängig von der tatsächlich gefahrenen Tour. Die Emissionen der tatsächlich gefahrenen Tour (inkl. Leerfahrten) werden durch den Energieverbrauch der TOC berücksichtigt.
ISO 14083
Berechnung in fünf Schritten
Vorgehen
- Transportkette in Transport- und Hub-Elemente zerlegen
- Elemente zu TOC bzw. HOC gruppieren
- Energieverbrauch je TOC/HOC bestimmen (Primärdaten bevorzugt: getankte Liter, geladene kWh; sonst Modell- oder Default-Werte)
- Emissionen = Energie × Emissionsfaktor (WTT und TTW getrennt)
- Emissionsintensität je TOC (g CO₂e/tkm) und Zuordnung auf die Sendung: Intensität × Sendungs-tkm, danach Summe über alle Elemente der Kette
Formeln
\[E_{\text{TOC}} = \sum_k V_k \cdot f_k^{\text{WTW}} \qquad\quad \varepsilon_{\text{TOC}} = \frac{E_{\text{TOC}}}{\sum_s m_s \cdot d_s^{\text{SFD}}}\] \[E_s = \varepsilon_{\text{TOC}} \cdot m_s \cdot d_s^{\text{SFD}}\] Energiemenge \(V_k\) je Energieträger \(k\), Emissionsfaktor \(f_k\), Sendungsmasse \(m_s\)
Emissionsfaktoren
Diesel TTW ≈ 2,65 kg CO₂/l, WTW ≈ 3,2 kg CO₂e/l
Strom (Netz DE) ≈ 0,38 kg CO₂e/kWh inkl. Vorkette (Umweltbundesamt 2025)
Fallstudie – CO₂ der Filialbelieferung
Emissionen je Box nach ISO 14083: Pendelverkehr oder Rundtour?
Pendelverkehr: 204 km/Tag
- Diesel-Lkw: 34,8 l Diesel \(\rightarrow\) 111,2 kg CO\(_2\)e
- E-Lkw: 148,4 kWh Strom \(\rightarrow\) 56,4 kg CO\(_2\)e
g CO₂e je Box
|
kg CO₂e je Filiale/Tag
|
|||||
|---|---|---|---|---|---|---|
| Standort | Boxen | Distanz (km) | Diesel | E-Lkw | Diesel | E-Lkw |
| Wiesbaden | 120 | 24 | 209 | 106 | 25,0 | 12,7 |
| Mainz | 150 | 14 | 118 | 60 | 17,7 | 9,0 |
| Frankfurt | 280 | 9 | 74 | 37 | 20,7 | 10,5 |
| Rüsselsheim | 90 | 27 | 237 | 120 | 21,3 | 10,8 |
| Darmstadt | 110 | 22 | 194 | 98 | 21,3 | 10,8 |
| Offenbach | 95 | 6 | 55 | 28 | 5,2 | 2,6 |
| Ø je Box | 845 | 132 | 67 | |||
| Gesamt | 204 km/Tag | 111,2 | 56,4 | |||
Rundtour (eine Tour durch alle Filialen; wie man sie bestimmt, zeigt die Einheit Tourenplanung): 153 km/Tag
- Diesel-Lkw: 26,0 l Diesel \(\rightarrow\) 83,2 kg CO\(_2\)e
- E-Lkw: 111,1 kWh Strom \(\rightarrow\) 42,2 kg CO\(_2\)e
g CO₂e je Box
|
kg CO₂e je Filiale/Tag
|
|||||
|---|---|---|---|---|---|---|
| Standort | Boxen | Distanz (km) | Diesel | E-Lkw | Diesel | E-Lkw |
| Wiesbaden | 120 | 24 | 156 | 79 | 18,7 | 9,5 |
| Mainz | 150 | 14 | 88 | 45 | 13,2 | 6,7 |
| Frankfurt | 280 | 9 | 55 | 28 | 15,5 | 7,8 |
| Rüsselsheim | 90 | 27 | 177 | 90 | 15,9 | 8,1 |
| Darmstadt | 110 | 22 | 145 | 74 | 16,0 | 8,1 |
| Offenbach | 95 | 6 | 41 | 21 | 3,9 | 2,0 |
| Ø je Box | 845 | 98 | 50 | |||
| Gesamt | 153 km/Tag | 83,2 | 42,2 | |||
Energiebedarf E-Lkw: 66 kWh/100 km + 10 % Ladeverluste
Kernaussagen
Das Wichtigste in Kürze
- Verkehrsträger unterscheiden sich in Kosten, Geschwindigkeit, Netzdichte, Kapazität und Klimabilanz. Der kombinierte Verkehr lohnt sich ab einer Break-even-Entfernung.
- Alternative Antriebe verändern die Planung: Batterieelektrische Lkw bringen Reichweiten-, Lade- und Gewichtsrestriktionen, die in E-VRP-Modellen abgebildet werden.
- Mit dem E-Kühl-Lkw ist der heutige Pendelverkehr von SushiFresh nicht fahrbar. Ob eine Rundtour passt, wird zur Machbarkeitsfrage der anschließenden Tourenplanung.
- Lastenrad, Mikrodepot und Drohne führen zu zweistufigen bzw. synchronisierten Planungsproblemen. Auf der letzten Meile zählt € pro Stopp.
- Fremdvergabe wandelt Fixkosten in variable Kosten und lohnt sich bei geringer Auslastung. Dieselfloater teilen das Preisrisiko.
- ISO 14083 bilanziert Emissionen Well-to-Wheel je Transportkategorie und verteilt sie über tkm (kürzeste realisierbare Distanz) auf Sendungen. Im Fallbeispiel spart die Rundtour rund 25 % der Emissionen, der E-Lkw rund 49 %.
- Transportkostensätze entstehen aus Fixkosten (AfA, Zinsen, Versicherung, Personal) und variablen Kosten (Energie, Wartung, Maut). Fahrleistung, Auslastung und Leerfahrten bestimmen, was ein km, eine Stunde oder ein tkm kostet.
Übung
Übungsaufgaben zu dieser Einheit
Aufgaben zur Klausurvorbereitung (Teil 1) und eine vertiefende Fallstudie (Teil 2) finden Sie in Fallstudie 8: Transportmittel, Antriebe und Transportkosten.
operative Distributionsplanung
Distributionsplanung
- Kürzeste Wege
- Tourenplanung
Lernziele
Nach dieser Einheit können Sie …
- Straßennetze als Graphen mit Knoten, Kanten und Kantengewichten modellieren,
- verschiedene Varianten des Kürzeste-Wege-Problems unterscheiden,
- den Dijkstra-Algorithmus von Hand durchführen und in R implementieren,
- aus kürzesten Wegen eine Distanzmatrix für Transport- und Tourenplanung ableiten.
Literatur zur Vertiefung
- Kürzeste Wege und Graphentheorie in der Logistik: (Domschke 2007).
- Originalarbeit zum Algorithmus: (Dijkstra 1959).
- Transport- und Tourenplanung im Überblick: (Günther and Tempelmeier 2012).
Fallstudie – SushiFresh GmbH
Woher kommen eigentlich die Transportkosten?
Rückblick
In der Standort- und der Transportplanung waren die Transportkosten \(c_{ij}\) vorgegeben. Aus der Einheit Verkehrsmittel und Antriebe kennen wir Kostensätze je km. Es fehlen die Entfernungen: \(c_{ij}\) = Kostensatz × Entfernung. Im Januar endet das Weihnachtsgeschäft: Die Zentralküche Raunheim beliefert wieder alle sechs Filialen allein.
Auftrag der Disposition
Die neue Disponentin möchte die Kostensätze selbst nachvollziehen. Dafür braucht sie die Straßenentfernungen
- von Raunheim zu jeder Filiale und
- zwischen allen Filialen (für die Tourenplanung in Einheit Tourenplanung).
Erste Idee: Luftlinie (Haversine, Einheit Standortplanung I)
| ID | Filiale | Luftlinie ab Raunheim (km) |
|---|---|---|
| C1 | Wiesbaden | 18,3 |
| C2 | Mainz | 13,9 |
| C3 | Frankfurt | 19,8 |
| C4 | Rüsselsheim | 4,0 |
| C5 | Darmstadt | 19,4 |
| C6 | Offenbach | 24,6 |
Lkw fahren nicht Luftlinie: Rhein- und Mainbrücken, Autobahnkreuze und Ortsdurchfahrten bestimmen die tatsächliche Strecke.
Straßennetz als Graph
Modellierung
Graph \(G = (V, E)\)
- Knoten \(V\): Orte (Küche, Filialen) und Verknüpfungspunkte (Autobahnkreuze)
- Kanten \(E\): direkte Straßenverbindungen
- Kantengewicht \(c_{vw} \geq 0\): Länge, Fahrzeit oder Kosten
- ungerichtet, wenn beide Richtungen gleich lang sind; sonst gerichtet (Einbahnstraßen, Auffahrten)
Weg von \(s\) nach \(t\): Folge benachbarter Knoten; Länge = Summe der Kantengewichte
Das SushiFresh-Netz hat 10 Knoten und 16 Kanten (vereinfacht).
Kürzeste-Wege-Probleme
Problemvarianten
| Variante | Frage | Verfahren | Beispiel |
|---|---|---|---|
| 1 → 1 | Kürzester Weg von s nach t | Dijkstra (mit Abbruch), A* | Navigationssystem |
| 1 → alle | Kürzeste Wege von s zu allen Knoten | Dijkstra, Bellman-Ford | Kostensätze ab Zentralküche |
| alle → alle | Kürzeste Wege zwischen allen Knotenpaaren | Floyd-Warshall oder n × Dijkstra | Distanzmatrix für die Tourenplanung |
Als Netzwerkflussproblem
Ein Kürzeste-Wege-Problem ist ein Transportproblem auf einem Netz: Eine Einheit fließt von \(s\) nach \(t\).
\[\min \sum_{(v,w) \in E} c_{vw} \, x_{vw}\] \[\sum_{w} x_{vw} - \sum_{w} x_{wv} = \begin{cases} 1 & v = s \\ -1 & v = t \\ 0 & \text{sonst} \end{cases}\] \[x_{vw} \geq 0\]
Mit spezialisierten Algorithmen geht es aber deutlich schneller als mit einem LP-Solver.
Dijkstra-Algorithmus
Idee
Idee (Dijkstra 1959): Breite dich vom Startknoten \(s\) wie eine Welle aus. Jeder Knoten \(v\) trägt eine Marke \(d(v)\) (bisher kürzeste bekannte Entfernung) und einen Vorgänger \(p(v)\). In jedem Schritt wird der nächstgelegene noch offene Knoten endgültig („permanent“) markiert.
Zwei Arten von Marken
- temporär: vorläufiger Wert, kann noch verbessert werden
- permanent: endgültig kürzeste Entfernung
Warum ist der kleinste temporäre Wert endgültig? Jeder andere Weg müsste über einen Knoten mit größerer Marke laufen und kann wegen \(c_{vw} \geq 0\) nicht kürzer werden.
Kernoperation: Markenkorrektur
Für jeden Nachbarn \(w\) des neu permanenten Knotens \(v\): \[d(w) \leftarrow \min\big(d(w),\; d(v) + c_{vw}\big)\] Verbessert sich \(d(w)\), wird \(p(w) \leftarrow v\) gesetzt.
Voraussetzung: keine negativen Kantengewichte.
Dijkstra-Algorithmus
Algorithmus
Initialisierung: \(d(s) = 0\), \(d(v) = \infty\) für alle \(v \neq s\); alle Marken temporär; \(p(v) = \text{–}\)
Wiederhole, bis alle Knoten permanent sind:
- Wähle den temporär markierten Knoten \(v\) mit kleinstem \(d(v)\).
- Markiere \(v\) permanent.
- Für jeden temporär markierten Nachbarn \(w\) von \(v\):
- falls \(d(v) + c_{vw} < d(w)\): setze \(d(w) = d(v) + c_{vw}\) und \(p(w) = v\)
Ergebnis: \(d(v)\) = kürzeste Entfernung von \(s\) nach \(v\); der Weg ergibt sich durch Rückverfolgung der Vorgänger \(p(v)\).
Aufwand
- \(n\) Iterationen, je Iteration Minimumsuche über \(n\) Knoten → \(\mathcal{O}(n^2)\)
- mit Prioritätswarteschlange (Heap) → \(\mathcal{O}(|E| + n \log n)\)
- Ein Navigationssystem durchsucht so Millionen Knoten in Millisekunden (mit Beschleunigungen wie A*).
Notation im Fallbeispiel
Marke „\(d\) | \(p\)“, z. B. „15 | MH“ = 15 km, Vorgänger Mönchhof-Dreieck
Dijkstra-Algorithmus
Fallbeispiel – Iteration 1: Start in Raunheim
Schritt
- R hat die kleinste Marke (0) → permanent
- Nachbarn erhalten erste Marken:
- MH: \(0 + 5 = 5\)
- C4: \(0 + 6 = 6\)
- C3: \(0 + 33 = 33\) (Bundesstraße direkt nach Frankfurt)
Legende
- ● permanent
- ● temporär markiert
- ○ in dieser Iteration verbessert
- graue Knoten: noch \(d = \infty\)
Dijkstra-Algorithmus
Fallbeispiel – Iteration 3: Rüsselsheim
Schritt
- Iteration 2: MH (5) wurde permanent → WK = 18, FK = 15
- Iteration 3: kleinste temporäre Marke ist C4 (6) → permanent
- Nachbarn von C4:
- C2: \(6 + 16 = 22\) → neu
- C5: \(6 + 33 = 39\) → neu
- MH ist bereits permanent → keine Prüfung
Die Marke von C4 bleibt 6: Der Umweg über MH (\(5 + 10 = 15\)) war nie besser.
Dijkstra-Algorithmus
Fallbeispiel – Iteration 4: Markenkorrektur in Frankfurt
Schritt
- FK (15) wird permanent
- Nachbarn von FK:
- C3: \(15 + 13 = 28 < 33\) → Korrektur! neue Marke 28, Vorgänger FK
- C6: \(15 + 12 = 27\) → neu
- C5: \(15 + 29 = 44 > 39\) → keine Änderung
Der direkte Weg nach Frankfurt (33 km) wird durch den Weg über die Autobahn (28 km) ersetzt. Temporäre Marken sind eben nur vorläufig.
Dijkstra-Algorithmus
Fallbeispiel – Tableau aller Iterationen
| It. | perm. | R | MH | WK | FK | C1 | C2 | C3 | C4 | C5 | C6 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | R | 0 | 5 | R | ∞ | ∞ | ∞ | ∞ | 33 | R | 6 | R | ∞ | ∞ |
| 2 | MH | 5 | 18 | MH | 15 | MH | ∞ | ∞ | 33 | R | 6 | R | ∞ | ∞ | |
| 3 | C4 | 18 | MH | 15 | MH | ∞ | 22 | C4 | 33 | R | 6 | 39 | C4 | ∞ | ||
| 4 | FK | 18 | MH | 15 | ∞ | 22 | C4 | 28 | FK | 39 | C4 | 27 | FK | |||
| 5 | WK | 18 | 26 | WK | 22 | C4 | 28 | FK | 39 | C4 | 27 | FK | ||||
| 6 | C2 | 26 | WK | 22 | 28 | FK | 39 | C4 | 27 | FK | |||||
| 7 | C1 | 26 | 28 | FK | 39 | C4 | 27 | FK | ||||||
| 8 | C6 | 28 | FK | 39 | C4 | 27 | |||||||
| 9 | C3 | 28 | 39 | C4 | ||||||||
| 10 | C5 | 39 |
Zellen: „\(d\) | \(p\)“ (temporäre Marke), grün = wird in dieser Iteration permanent, rot = in dieser Iteration verbessert, leer = bereits permanent.
Nach 10 Iterationen sind alle Knoten permanent. Die Reihenfolge entspricht aufsteigenden Entfernungen.
Dijkstra-Algorithmus
Ergebnis: Kürzeste-Wege-Baum ab Raunheim
| Filiale | Kürzester Weg | km | Luftlinie | Umweg-faktor |
|---|---|---|---|---|
| C1 | R → MH → WK → C1 | 26 | 18,3 | 1,42 |
| C2 | R → C4 → C2 | 22 | 13,9 | 1,59 |
| C3 | R → MH → FK → C3 | 28 | 19,8 | 1,41 |
| C4 | R → C4 | 6 | 4,0 | 1,51 |
| C5 | R → C4 → C5 | 39 | 19,4 | 2,01 |
| C6 | R → MH → FK → C6 | 27 | 24,6 | 1,10 |
Die Vorgänger bilden einen Baum (grün): Von jedem Knoten führt genau ein kürzester Weg zurück nach Raunheim. Der mittlere Umwegfaktor liegt bei 1,51. Typische Werte in Deutschland liegen bei 1,2–1,4.
Dijkstra-Algorithmus
Implementierung in R
# W: Gewichtsmatrix (0 = keine Kante)
dijkstra <- function(W, start) {
  ids  <- rownames(W)
  d    <- setNames(rep(Inf, nrow(W)), ids)
  pred <- setNames(rep(NA, nrow(W)), ids)
  perm <- setNames(rep(FALSE, nrow(W)), ids)
  d[start] <- 0
  while (!all(perm)) {
    # 1. kleinste temporäre Marke
    v <- names(which.min(ifelse(perm, Inf, d)))
    # 2. permanent markieren
    perm[v] <- TRUE
    # 3. Markenkorrektur der Nachbarn
    for (w in ids[W[v, ] > 0 & !perm]) {
      if (d[v] + W[v, w] < d[w]) {
        d[w]    <- d[v] + W[v, w]
        pred[w] <- v
      }
    }
  }
  list(d = d, pred = pred)
}Distanzmatrix für die Tourenplanung
Alle Paare: \(n\)-mal Dijkstra
Eigenschaften der Distanzmatrix
- symmetrisch (ungerichtetes Netz)
- erfüllt die Dreiecksungleichung \(d_{ik} \leq d_{ij} + d_{jk}\), denn jede Direktverbindung ist bereits ein kürzester Weg
- enthält nur noch die relevanten Orte, die Autobahnknoten sind „herausgerechnet“
Ausblick auf Einheit Tourenplanung
Fährt der Kühltransporter jede Filiale einzeln an (Pendelverkehr), legt er täglich \(2 \cdot \sum_j d_{Rj} =\) 296 km zurück, 45 % mehr als mit den geschätzten Distanzen der Standortplanung II (204 km, Einheit Verkehrsmittel und Antriebe). Geht das mit einer Rundtour kürzer?
Kürzeste Wege in der Praxis
Varianten und Erweiterungen
Weitere Algorithmen
- Bellman-Ford: erlaubt negative Kantengewichte (z. B. Rückfrachten mit Erlös), \(\mathcal{O}(n \cdot |E|)\)
- Floyd-Warshall: alle Paare auf einmal, \(\mathcal{O}(n^3)\)
- A*: Dijkstra mit Schätzung der Restentfernung (z. B. Luftlinie) → durchsucht viel weniger Knoten
Was ist „kurz“?
- Distanz (km): Kraftstoff, Verschleiß
- Fahrzeit: Personal, Frische der Ware, Lieferfenster
- Kosten: Maut, Fahrzeugkosten
- zeitabhängig: Berufsverkehr auf der A3 um 7 Uhr ≠ um 4 Uhr
Je nach Zielgröße ergeben sich unterschiedliche kürzeste Wege.
Kernaussagen
Das Wichtigste in Kürze
- Straßennetze werden als Graphen modelliert. Transportkosten \(c_{ij}\) ergeben sich aus kürzesten Wegen im Netz, nicht aus der Luftlinie.
- Der Dijkstra-Algorithmus markiert schrittweise den nächstgelegenen offenen Knoten permanent und korrigiert die Marken seiner Nachbarn. Voraussetzung: nichtnegative Gewichte.
- Temporäre Marken können sich noch verbessern (SushiFresh: Frankfurt von 33 auf 28 km).
- Mehrfaches Anwenden liefert eine symmetrische, metrische Distanzmatrix, die Grundlage der Tourenplanung.
Übung
Übungsaufgaben zu dieser Einheit
Aufgaben zur Klausurvorbereitung (Teil 1) und eine vertiefende Fallstudie (Teil 2) finden Sie in Fallstudie 9: Kürzeste Wege.
operative Distributionsplanung - Tourenplanung
Operative Distributionsplanung
- Kürzeste Wege
- Tourenplanung
Lernziele
Nach dieser Einheit können Sie …
- das Traveling Salesman Problem (TSP) als Grundproblem der Tourenplanung beschreiben und formulieren,
- die Komplexität des TSP einschätzen und den Einsatz von Heuristiken begründen,
- Touren mit dem Nearest-Neighbor-Verfahren konstruieren und mit 2-opt verbessern,
- heuristische Lösungen im Vergleich zur Optimallösung bewerten und Erweiterungen zum Vehicle Routing Problem einordnen.
Literatur zur Vertiefung
- Rundreise- und Tourenplanung: (Domschke and Scholl 2010).
- TSP – Geschichte, Modelle, exakte Verfahren: (Applegate et al. 2006).
- Vehicle Routing Problems: (Toth and Vigo 2014).
Fallstudie – SushiFresh GmbH
Pendelverkehr oder Rundtour?
Ausgangslage
Im Normalbetrieb liefert ein Kühltransporter (Kapazität 900 Boxen) jeden Morgen 845 Boxen aus Raunheim an die sechs Filialen. Der Fahrer fährt bisher jede Filiale einzeln an und kehrt danach zur Küche zurück (Pendelverkehr).
Täglich gefahrene Strecke: \(2 \cdot \sum_j d_{Rj} =\) 296 km (Straßennetz; Schätzung aus der Standortplanung II: 204 km)
Idee
Da alle Boxen auf einmal in den Transporter passen, kann er die Filialen in einer Rundtour nacheinander anfahren.
Frage: In welcher Reihenfolge ist die Tour am kürzesten?
Die Distanzen \(d_{ij}\) stammen aus der Distanzmatrix von Einheit Kürzeste Wege (kürzeste Wege im Straßennetz).
Traveling Salesman Problem
Problembeschreibung
Problemstellung
Gegeben sind \(n\) Orte (ein Depot und \(n-1\) Kunden) und die Entfernungen \(d_{ij}\) zwischen allen Paaren. Gesucht ist eine Rundreise, die jeden Ort genau einmal besucht, zum Ausgangspunkt zurückkehrt und minimale Gesamtlänge hat.
Begriffe
- Tour (Hamiltonkreis): Reihenfolge \((v_1, v_2, \ldots, v_n, v_1)\)
- symmetrisches TSP: \(d_{ij} = d_{ji}\) (SushiFresh)
- asymmetrisches TSP: \(d_{ij} \neq d_{ji}\) (Einbahnstraßen, Stadtverkehr)
- metrisches TSP: Dreiecksungleichung gilt, z. B. bei Distanzen aus kürzesten Wegen
Abgrenzung
- Kürzeste Wege: Wie komme ich von \(i\) nach \(j\)?
- TSP: In welcher Reihenfolge besuche ich alle Orte?
Distanzmatrix \(d_{ij}\) (km) aus Einheit Kürzeste Wege
| von | R | C1 | C2 | C3 | C4 | C5 | C6 |
|---|---|---|---|---|---|---|---|
| R | 0 | 26 | 22 | 28 | 6 | 39 | 27 |
| C1 | 26 | 0 | 14 | 44 | 30 | 60 | 43 |
| C2 | 22 | 14 | 0 | 49 | 16 | 49 | 48 |
| C3 | 28 | 44 | 49 | 0 | 33 | 34 | 10 |
| C4 | 6 | 30 | 16 | 33 | 0 | 33 | 32 |
| C5 | 39 | 60 | 49 | 34 | 33 | 0 | 24 |
| C6 | 27 | 43 | 48 | 10 | 32 | 24 | 0 |
Traveling Salesman Problem
Mathematisches Modell
Binäres Optimierungsmodell (Dantzig et al. 1954)
\(x_{ij} = 1\), falls direkt von \(i\) nach \(j\) gefahren wird
\[\min \rightarrow \sum_{i} \sum_{j \neq i} d_{ij} \cdot x_{ij}\]
Nebenbedingungen \[ \begin{align} \sum_{j \neq i} x_{ij} &= 1 && \forall i \\ \sum_{i \neq j} x_{ij} &= 1 && \forall j \\ \sum_{i \in S} \sum_{j \in S} x_{ij} &\leq |S| - 1 && \forall S \subset V,\ 2 \leq |S| < n \\ x_{ij} &\in \{0,1\} && \forall i \neq j \end{align} \]
Zeilen 1–2: jeden Ort genau einmal verlassen und erreichen. Zeile 3: keine Kurzzyklen.
Ohne die dritte Bedingung wären zwei getrennte Kreise zulässig: Jeder Ort hat genau einen Vorgänger und Nachfolger, aber die Filialen C3, C5, C6 sind nicht mit der Küche verbunden.
Traveling Salesman Problem
Warum nicht einfach alle Touren ausprobieren?
| Orte n | Touren (n−1)!/2 | Rechenzeit bei 10⁹ Touren/s |
|---|---|---|
| 5 | 12 | < 1 Sekunde |
| 7 | 360 | < 1 Sekunde |
| 10 | 181.440 | < 1 Sekunde |
| 15 | 4,4 · 1010 | 44 Sekunden |
| 20 | 6,1 · 1016 | 1,9 Jahre |
| 30 | 4,4 · 1030 | 1,4 · 1014 Jahre |
| 50 | 3,0 · 1062 | 9,6 · 1045 Jahre |
Kombinatorische Explosion
Das TSP ist NP-schwer: Es ist kein Verfahren bekannt, das jede Instanz in polynomieller Zeit optimal löst. Für SushiFresh (\(n = 7\)) gibt es nur 360 verschiedene Touren, ein Paketdienst mit 150 Stopps pro Fahrzeug hat dagegen unvorstellbar viele.
Lösungsansätze
- Eröffnungsverfahren konstruieren eine Tour: Nearest Neighbor, Einfügeverfahren, Savings
- Verbesserungsverfahren verändern eine Tour lokal: 2-opt, Or-opt, 3-opt
- Metaheuristiken (z. B. Simulated Annealing) und exakte Verfahren (Branch-and-Cut) für anspruchsvolle Fälle
Nearest-Neighbor-Verfahren
Idee und Algorithmus
Idee: Fahre vom aktuellen Ort immer zum nächstgelegenen noch nicht besuchten Ort. Sind alle besucht, kehre zum Depot zurück.
Algorithmus
Initialisierung: Tour \(T = (v_1)\) mit Startort (Depot) \(v_1\)
Wiederhole, bis alle Orte in \(T\) enthalten sind:
- Sei \(v\) der letzte Ort in \(T\).
- Wähle \(w^* = \arg\min_{w \notin T} d_{vw}\).
- Hänge \(w^*\) an \(T\) an.
Abschluss: Kante vom letzten Ort zurück zu \(v_1\)
Eigenschaften
- sehr einfach und schnell: \(\mathcal{O}(n^2)\)
- entspricht der Intuition vieler Fahrer
- greedy: Jede Entscheidung ist lokal gut, aber sie berücksichtigt nicht, was danach kommt
Typische Schwäche
Die letzten Orte liegen oft verstreut. Am Ende werden lange Wege und der Rückweg zum Depot „erzwungen“.
Nearest-Neighbor-Verfahren
Fallbeispiel – Start in Raunheim
| # | von | offene Orte: d (km) | nach | km | Σ km |
|---|---|---|---|---|---|
| 1 | R | C4: 6, C2: 22, C1: 26, C6: 27, C3: 28, C5: 39 | C4 | 6 | 6 |
| 2 | C4 | C2: 16, C1: 30, C6: 32, C3: 33, C5: 33 | C2 | 16 | 22 |
| 3 | C2 | C1: 14, C6: 48, C3: 49, C5: 49 | C1 | 14 | 36 |
| 4 | C1 | C6: 43, C3: 44, C5: 60 | C6 | 43 | 79 |
| 5 | C6 | C3: 10, C5: 24 | C3 | 10 | 89 |
| 6 | C3 | C5: 34 | C5 | 34 | 123 |
| 7 | C5 | Rückkehr zum Depot | R | 39 | 162 |
NN-Tour: R → C4 → C2 → C1 → C6 → C3 → C5 → R mit 162 km, gegenüber 296 km im Pendelverkehr.
Nearest-Neighbor-Verfahren
Kritische Würdigung
Was ist schiefgelaufen?
- In Schritt 4 springt die Tour von Wiesbaden quer durch das Gebiet nach Offenbach (43 km), weil Offenbach 1 km näher liegt als Frankfurt.
- Danach geht es zurück nach Frankfurt und wieder nach Süden nach Darmstadt.
- Die Tour kreuzt sich selbst, und der Rückweg von Darmstadt (39 km) ist lang.
Merkregel
In einer optimalen Tour eines euklidischen TSP gibt es keine Kreuzungen. Kreuzungen sind ein deutliches Zeichen für Verbesserungspotenzial.
NN-Tourlänge je nach Startort
| Start | Tour (ab Depot gelesen) | km |
|---|---|---|
| R | R → C4 → C2 → C1 → C6 → C3 → C5 → R | 162 |
| C1 | R → C6 → C3 → C5 → C1 → C2 → C4 → R | 167 |
| C2 | R → C4 → C6 → C3 → C5 → C2 → C1 → R | 171 |
| C3 | R → C2 → C1 → C3 → C6 → C5 → C4 → R | 153 |
| C4 | R → C2 → C1 → C6 → C3 → C5 → C4 → R | 162 |
| C5 | R → C4 → C2 → C1 → C5 → C6 → C3 → R | 158 |
| C6 | R → C4 → C2 → C1 → C5 → C6 → C3 → R | 158 |
Eine einfache Verbesserung: NN von jedem Startort aus rechnen und die beste Tour wählen.
2-opt-Verfahren
Idee: zwei Kanten austauschen (Croes 1958)
Idee: Entferne zwei nicht benachbarte Kanten \((a,b)\) und \((c,d)\) aus der Tour und verbinde die Teilstücke neu über \((a,c)\) und \((b,d)\). Das Teilstück zwischen \(b\) und \(c\) wird dabei in umgekehrter Richtung durchlaufen.
Ersparnis eines 2-opt-Zugs
\[\Delta = \underbrace{d_{ab} + d_{cd}}_{\text{entfernt}} - \underbrace{d_{ac} + d_{bd}}_{\text{hinzugefügt}}\] Der Zug lohnt sich, wenn \(\Delta > 0\).
Bei \(n\) Orten gibt es \(n(n-3)/2\) mögliche 2-opt-Züge, bei SushiFresh also 14.
2-opt-Verfahren
Algorithmus
Initialisierung: Starttour \(T = (v_1, \ldots, v_n)\), z. B. aus Nearest Neighbor
Wiederhole:
- Berechne für alle Paare nicht benachbarter Kanten \((v_i, v_{i+1})\) und \((v_k, v_{k+1})\) die Ersparnis \[\Delta_{ik} = d_{v_i v_{i+1}} + d_{v_k v_{k+1}} - d_{v_i v_k} - d_{v_{i+1} v_{k+1}}\]
- Wähle das Paar mit dem größten \(\Delta_{ik}\) (best improvement).
- Falls \(\Delta_{ik} > 0\): kehre die Reihenfolge \(v_{i+1}, \ldots, v_k\) um.
- Sonst: Abbruch, \(T\) ist 2-optimal.
Varianten
- first improvement: den ersten verbessernden Zug sofort ausführen (schneller pro Iteration)
- Or-opt: verschiebt Teilstücke aus 1–3 Orten an eine andere Stelle
- 3-opt: tauscht drei Kanten (mächtiger, aber \(\mathcal{O}(n^3)\) je Durchlauf)
Lokales Optimum
Eine 2-optimale Tour lässt sich durch keinen einzelnen 2-opt-Zug verbessern. Sie muss aber nicht global optimal sein.
2-opt-Verfahren
Fallbeispiel – alle Züge für die NN-Tour
| entfernte Kanten | neue Kanten | alt | neu | Δ |
|---|---|---|---|---|
| (C1,C6) (C3,C5) | (C1,C3) (C6,C5) | 77 | 68 | 9 |
| (C4,C2) (C5,R) | (C4,C5) (C2,R) | 55 | 55 | 0 |
| (C6,C3) (C5,R) | (C6,C5) (C3,R) | 49 | 52 | -3 |
| (C1,C6) (C5,R) | (C1,C5) (C6,R) | 82 | 87 | -5 |
| (R,C4) (C1,C6) | (R,C1) (C4,C6) | 49 | 58 | -9 |
| (C4,C2) (C1,C6) | (C4,C1) (C2,C6) | 59 | 78 | -19 |
| (R,C4) (C3,C5) | (R,C3) (C4,C5) | 40 | 61 | -21 |
| (C2,C1) (C5,R) | (C2,C5) (C1,R) | 53 | 75 | -22 |
| (R,C4) (C2,C1) | (R,C2) (C4,C1) | 20 | 52 | -32 |
| (C4,C2) (C3,C5) | (C4,C3) (C2,C5) | 50 | 82 | -32 |
| (R,C4) (C6,C3) | (R,C6) (C4,C3) | 16 | 60 | -44 |
| (C4,C2) (C6,C3) | (C4,C6) (C2,C3) | 26 | 81 | -55 |
| (C2,C1) (C3,C5) | (C2,C3) (C1,C5) | 48 | 109 | -61 |
| (C2,C1) (C6,C3) | (C2,C6) (C1,C3) | 24 | 92 | -68 |
Einziger verbessernder Zug
Entferne (C1, C6) und (C3, C5), füge (C1, C3) und (C6, C5) ein:
\[\Delta = (43 + 34) - (44 + 24) = 9\ \text{km}\]
Das Teilstück C6 → C3 wird umgedreht zu C3 → C6.
Neue Tour: R → C4 → C2 → C1 → C3 → C6 → C5 → R mit 153 km
2-opt-Verfahren
Fallbeispiel – vorher und nachher
Nearest Neighbor: 162 km
nach 2-opt: 153 km
Die Kreuzung ist aufgelöst. Danach findet 2-opt keinen weiteren verbessernden Zug: Die Tour ist 2-optimal.
Wie gut ist die Lösung?
Vergleich mit der Optimallösung
Ergebnis
- Optimale Tour (Enumeration aller 360 Touren): R → C1 → C2 → C4 → C5 → C6 → C3 → R mit 151 km
- NN + 2-opt liegt 1,3 % über dem Optimum, NN allein 7,3 %.
Grenze von 2-opt
Die optimale Tour unterscheidet sich von der 2-opt-Lösung in drei Kanten. Dafür ist ein 3-opt-Zug nötig, jeder einzelne 2-opt-Zug verlängert die Tour. 2-opt bleibt im lokalen Optimum stecken.
Gegenüber dem Pendelverkehr spart die Tour täglich 143 km. Was das in Euro und für den E-Kühl-Lkw bedeutet, zeigen die nächsten beiden Folien.
Was bringt die Rundtour?
Bewertung mit den Kostensätzen aus der Einheit Verkehrsmittel und Antriebe
| Variante | km/Tag | Stunden/Tag | Kosten/Tag | € je Box |
|---|---|---|---|---|
| Pendelverkehr | 296 | 9,6 | 550,8 € | 0,652 € |
| Nearest Neighbor | 162 | 5,3 | 345,7 € | 0,409 € |
| NN + 2-opt | 153 | 5,2 | 334,6 € | 0,396 € |
Fahrzeugfixkosten 90,3 €/Tag, 0,536 €/km, Fahrer 31,5 €/h; Ø 45 km/h, 15 min je Filiale, 15 min je Beladung in Raunheim.
Ergebnis
Die optimierte Rundtour senkt die Kosten je Box um 39 %, das sind rund 64.863 € pro Jahr. Gespart werden Kilometer und Fahrerstunden, weil nur einmal beladen wird.
Der lineare Satz von 0,02 €/(Box·km) aus der Standortplanung unterstellt Pendelverkehr. Bündelungseffekte der Tour kann er nicht abbilden.
Reichweite als Nebenbedingung
Klappt die Tour mit dem E-Kühl-Lkw?
| Tour | km | Sommer (0,62 kWh/km) | Winter (0,70 kWh/km) |
|---|---|---|---|
| Pendelverkehr | 296 | 184 kWh ✗ | 207 kWh ✗ |
| Nearest Neighbor | 162 | 100 kWh ✓ | 113 kWh ✗ |
| NN + 2-opt | 153 | 95 kWh ✓ | 107 kWh ✓ |
| Optimum | 151 | 94 kWh ✓ | 106 kWh ✓ |
Nutzbare Energie je Tour: \(Q =\) 110 kWh (vgl. Einheit Verkehrsmittel und Antriebe).
Ergebnis
- Pendelverkehr: unmöglich
- Nearest Neighbor: im Sommer ja, im Winter nicht
- 2-opt und Optimum: ganzjährig fahrbar, mit knappem Puffer
Lehre
Beim E-Lkw entscheidet die Qualität der Tourenplanung über die Machbarkeit, nicht nur über die Kosten. Modelle mit Energie-Nebenbedingung heißen E-VRP (Schneider et al. 2014).
TSP-Heuristiken in R
Implementierung
nearest_neighbor <- function(D, start = 1) {
  tour <- start
  while (length(tour) < nrow(D)) {
    offen  <- setdiff(seq_len(nrow(D)), tour)
    letzte <- tail(tour, 1)
    naechster <- offen[which.min(D[letzte, offen])]
    tour <- c(tour, naechster)
  }
  rownames(D)[tour]
}

tour_length <- function(tour, D)
  sum(D[cbind(tour, c(tour[-1], tour[1]))])
two_opt <- function(tour, D) {
n <- length(tour)
repeat {
best <- 0
for (i in 1:(n - 1)) for (k in (i + 1):n) {
a <- tour[i]; b <- tour[i + 1]
c <- tour[k]; d <- tour[k %% n + 1]
if (b == c || a == d) next
delta <- D[a, b] + D[c, d] - D[a, c] - D[b, d]
if (delta > best) {
best <- delta; bi <- i; bk <- k
}
}
if (best <= 0) break # 2-optimal
tour <- c(tour[1:bi], rev(tour[(bi + 1):bk]),
if (bk < n) tour[(bk + 1):n])
}
tour
}TSP exakt lösen
MTZ-Formulierung mit ompr
library(ompr); library(ompr.roi)
library(ROI.plugin.glpk)
n <- nrow(D)

tsp_model <- MIPModel() |>
  add_variable(x[i, j], i = 1:n, j = 1:n,
               type = "binary") |>
  add_variable(u[i], i = 1:n, lb = 1, ub = n) |>
  set_objective(sum_expr(D[i, j] * x[i, j],
                i = 1:n, j = 1:n), "min") |>
  add_constraint(x[i, i] == 0, i = 1:n) |>
  add_constraint(sum_expr(x[i, j], j = 1:n) == 1,
                 i = 1:n) |>
  add_constraint(sum_expr(x[i, j], i = 1:n) == 1,
                 j = 1:n) |>
  # MTZ: Reihenfolgevariablen verhindern Kurzzyklen
  add_constraint(u[i] - u[j] + 1 <= (n - 1) * (1 - x[i, j]),
                 i = 2:n, j = 2:n, i != j)

tsp_sol <- solve_model(tsp_model,
                       with_ROI(solver = "glpk"))
MTZ-Bedingungen (Miller et al. 1960)
Statt exponentiell vieler Kurzzyklus-Bedingungen erhält jeder Kunde eine Position \(u_i\) in der Tour. Fährt man von \(i\) nach \(j\), muss \(u_j \geq u_i + 1\) gelten. Ein Kreis ohne Depot ist damit unmöglich.
Ergebnis: R → C1 → C2 → C4 → C5 → C6 → C3 → R mit 151 km, identisch zur Enumeration.
Die MTZ-Formulierung ist einfach, aber schwach. Für große Instanzen werden Spezialverfahren eingesetzt (z. B. der Concorde-Solver).
Ausblick: Tourenplanung
Vom TSP zum Vehicle Routing Problem
Neue Flotte
Der 900-Boxen-Transporter wird durch zwei Kühlvans à 500 Boxen ersetzt (Führerscheinklasse B, leichter zu besetzen). Die Tagesmenge von 845 Boxen passt nicht mehr in ein Fahrzeug.
Capacitated VRP (CVRP): Teile die Kunden so auf mehrere Touren auf, dass die Kapazität eingehalten wird und die Gesamtstrecke minimal ist. Das TSP ist der Spezialfall mit einem Fahrzeug ohne Kapazitätsgrenze.
Savings-Verfahren (Clarke and Wright 1964)
Start: jede Filiale in einer eigenen Pendeltour. Verbinde schrittweise Touren mit der größten Ersparnis \(s_{ij} = d_{Ri} + d_{Rj} - d_{ij}\), solange die Kapazität reicht und \(i\), \(j\) Tourenden sind.
- Tour West: R → C1 → C2 → C4 → R: 62 km, 360 Boxen
- Tour Ost: R → C3 → C6 → C5 → R: 101 km, 485 Boxen
- Gesamt 163 km statt 151 km mit einem Fahrzeug
Weitere Erweiterungen: Zeitfenster (Anlieferung vor 8 Uhr), maximale Tourdauer (Kühlkette, Lenkzeiten), heterogene Flotte, mehrere Depots
Kernaussagen
Das Wichtigste in Kürze
- Das TSP sucht die kürzeste Rundreise durch alle Orte. Es ist NP-schwer: Die Zahl der Touren wächst mit \((n-1)!/2\).
- Nearest Neighbor konstruiert schnell eine Tour, neigt aber zu langen Sprüngen am Ende und zu Kreuzungen (SushiFresh: 162 km).
- 2-opt tauscht Kantenpaare, solange sich die Tour verkürzt, und entfernt dabei Kreuzungen (SushiFresh: 153 km).
- Das Ergebnis ist ein lokales Optimum. Das globale Optimum (151 km) erfordert hier einen 3-opt-Zug oder ein exaktes Verfahren.
- Gegenüber dem Pendelverkehr (296 km) halbiert die Rundtour die Fahrstrecke nahezu.
Übung
Übungsaufgaben zu dieser Einheit
Aufgaben zur Klausurvorbereitung (Teil 1) und eine vertiefende Fallstudie (Teil 2) finden Sie in Fallstudie 10: Tourenplanung.
Supply Chain Management