Kapitel 5 · Supply Chain Management & Distribution
Nach dieser Einheit können Sie …
Literatur zur Vertiefung
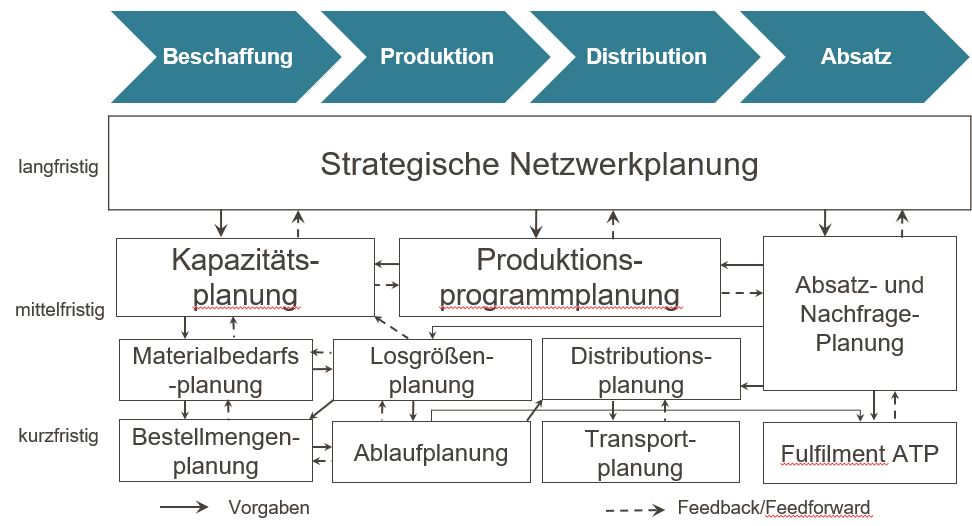
Supply Chain Planning Matrix
Zielstellung der Standortplanung
Entscheidung über Standort von:
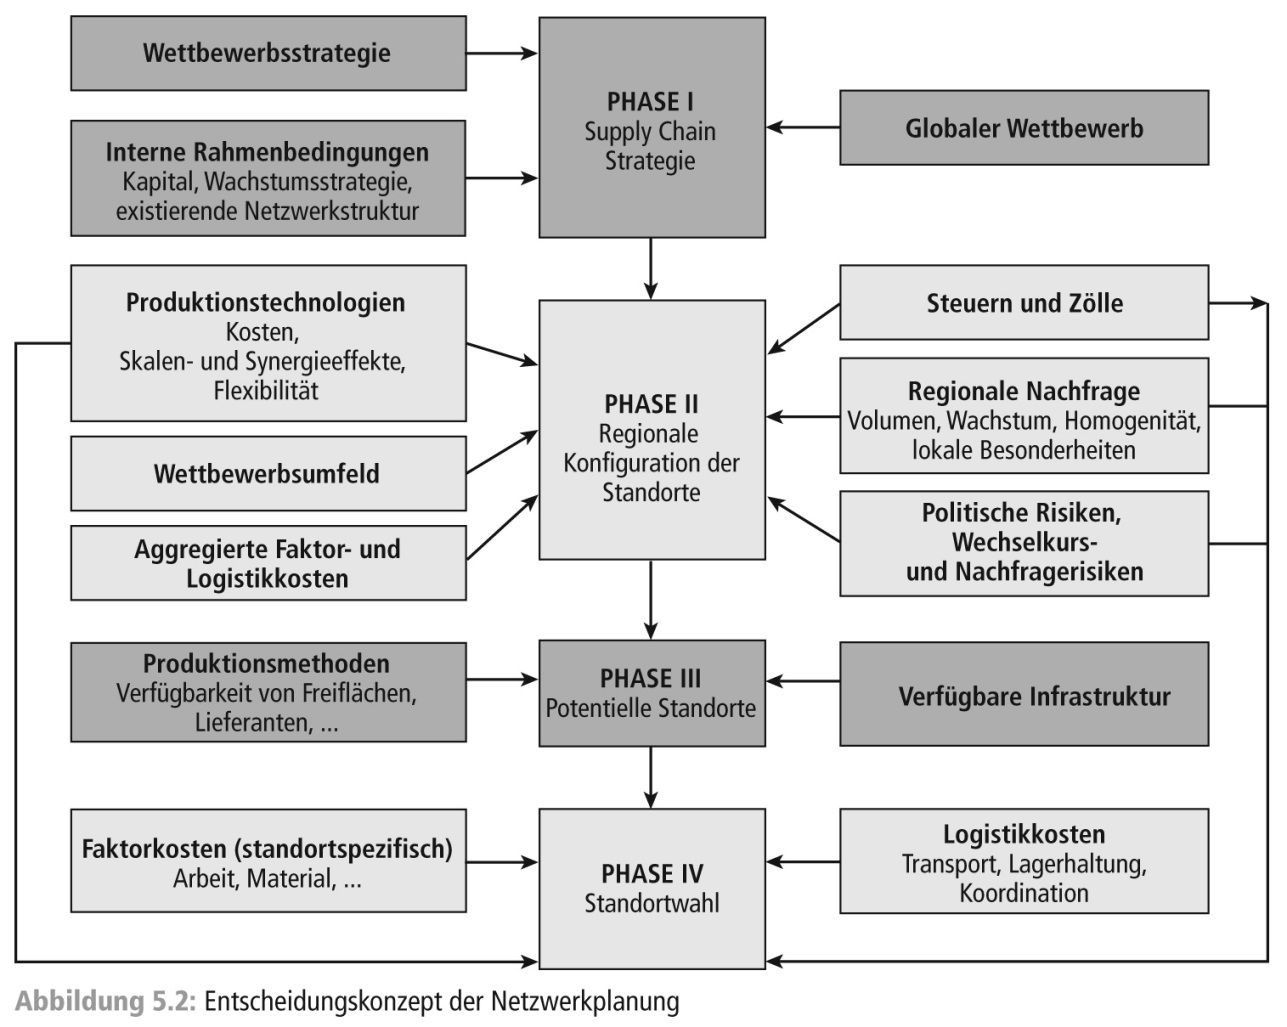
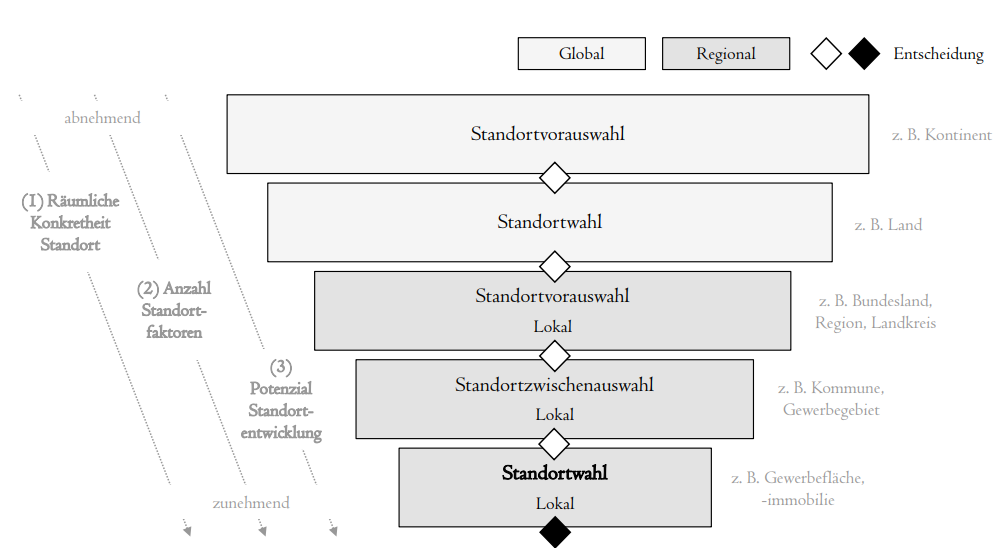
Phasen der Standortwahl
Standortplanungsprozess

(Kik 2022)
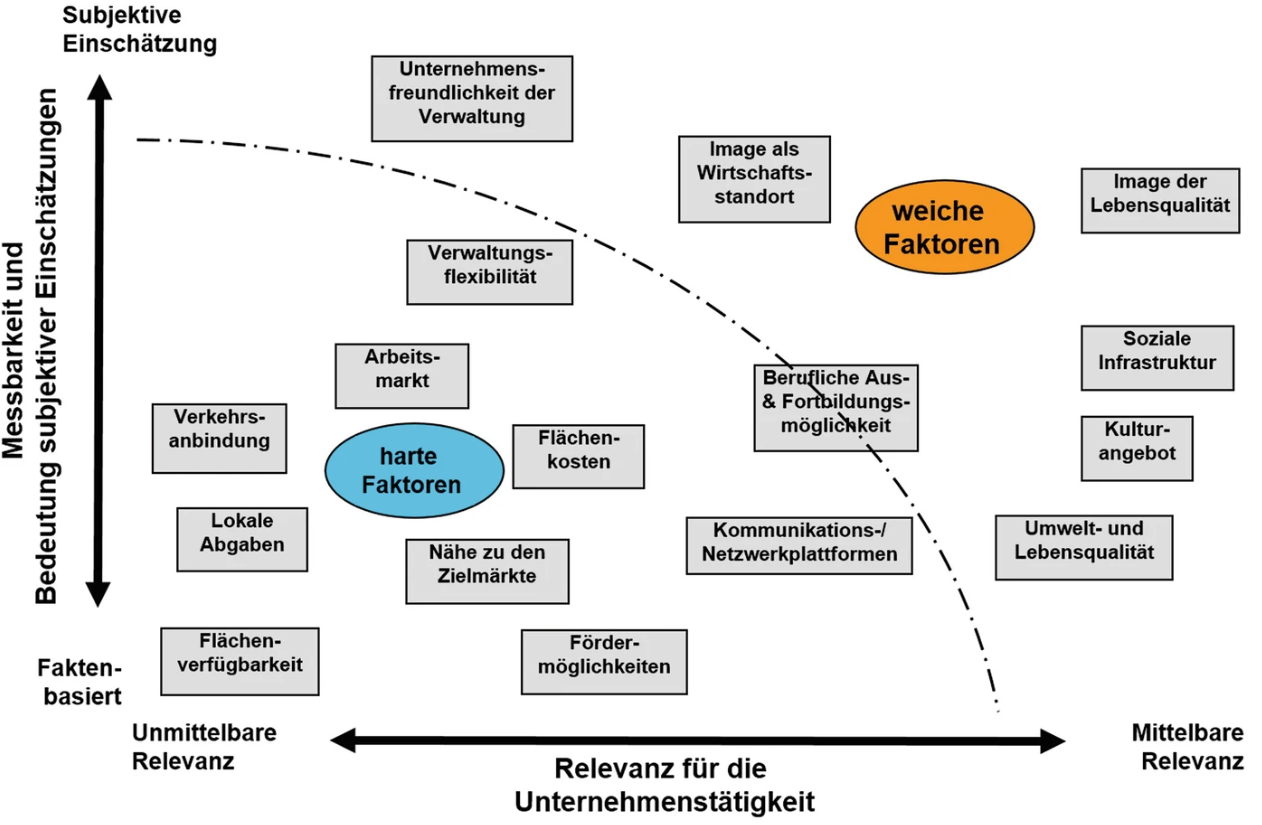
Standortfaktoren
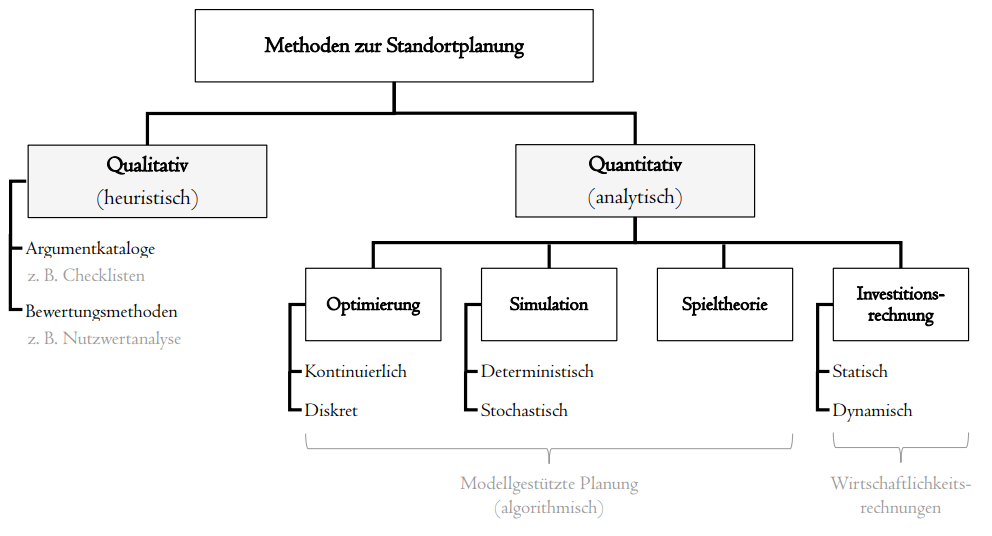
Methoden der Standortplanung

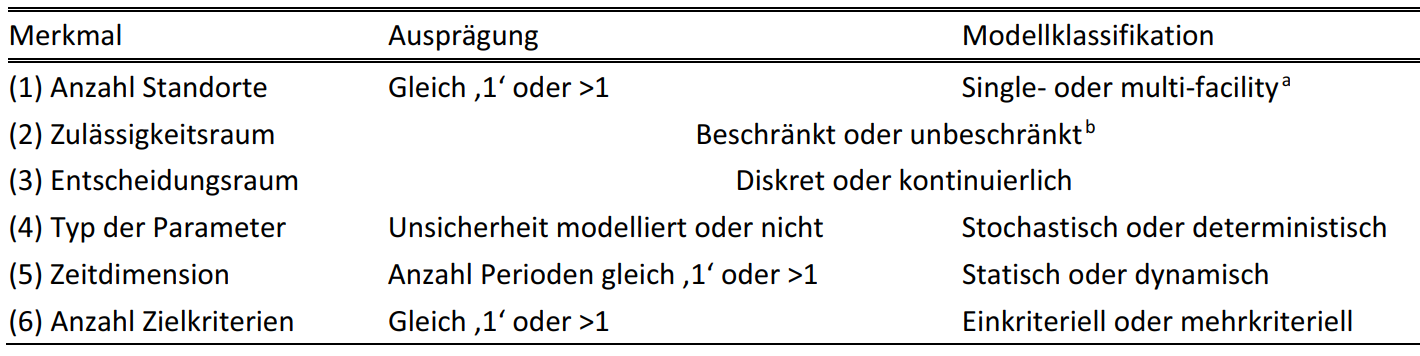
Merkmale von Optimierungsmodellen (Kik 2022) 
Fallstudie: SushiFresh GmbH
SushiFresh GmbH ist ein fiktiver regionaler Hersteller frischer Sushi-Boxen im Rhein-Main-Gebiet, der täglich sechs Supermarkt-Filialen beliefert. Diese Fallstudie begleitet uns durch dieses und die folgenden Kapitel.
SushiFresh prüft, ob sich zusätzlich zur Auslieferung eine eigene Produktionsstätte lohnt, und hat drei Kandidatengrundstücke identifiziert.
# Sechs Filialen: Koordinaten, Tagesnachfrage mu und Standardabweichung sigma
filialen <- tibble(
Filiale = c("Wiesbaden", "Mainz", "Frankfurt", "Ruesselsheim", "Darmstadt", "Offenbach"),
lat = c(50.0782, 50.0000, 50.1109, 49.9904, 49.8728, 50.0956),
lon = c(8.2398, 8.2711, 8.6821, 8.4116, 8.6512, 8.7761),
mu = c(120, 150, 280, 90, 110, 95),
sigma = c(25, 30, 55, 20, 24, 22)
)
# Drei Kandidatenstandorte fuer die Produktionsstaette
standorte <- tibble(
Standort = c("Wiesbaden-Erbenheim", "Mainz-Hechtsheim", "Raunheim"),
lat = c(50.0632, 49.9698, 50.0000),
lon = c(8.2999, 8.2831, 8.4650),
Fixkosten = c(180000, 210000, 260000)
)
sum(filialen$mu) # Gesamtnachfrage: 845 Boxen/Tag[1] 845
Nutzwertanalyse
Fallbeispiel
SushiFresh bewertet die drei Kandidatenstandorte Wiesbaden-Erbenheim, Mainz-Hechtsheim und Raunheim für die neue Produktionsstätte anhand der Kriterien Transportnähe, Mietkosten und Fachkräfteverfügbarkeit, die hier aus Vereinfachungsgründen gleich gewichtet werden.
Die Konstellation ist bewusst so gewählt, dass sich sehr unterschiedliche Standortprofile ergeben: Wiesbaden-Erbenheim ist stark bei den Mietkosten, Raunheim bei der Transportnähe, während Mainz-Hechtsheim bei den Fachkräften vorn liegt.
Gerade dieses Beispiel zeigt die Schwäche der additiven Nutzwertanalyse: Trotz klar unterschiedlicher Stärken- und Schwächenprofile können alle Alternativen denselben Gesamtnutzwert erreichen.
Nutzwertanalyse in R: Code und Ergebnistabelle
library(dplyr)
library(knitr)
# Tabelle mit Rohdaten der Fallstudie (drei Kriterien, gleich gewichtet)
nwa <- tibble(
Kriterium = c(
"Transportnaehe",
"Mietkosten",
"Fachkraefteverfuegbarkeit"
),
Gewicht = c(1/3, 1/3, 1/3),
`WI-Erb` = c(5, 8, 2),
`MZ-Hech` = c(2, 5, 8),
Raunheim = c(8, 2, 5)
)
# Berechne Nutzwerte der Standorte
nutzwert <- c(
`WI-Erb` = sum(nwa$Gewicht * nwa$`WI-Erb`),
`MZ-Hech` = sum(nwa$Gewicht * nwa$`MZ-Hech`),
Raunheim = sum(nwa$Gewicht * nwa$Raunheim)
)
# Verbinde Rohdaten und Nutzwerte in einer Tabelle
nwa <- bind_rows(nwa, nutzwert)
# Setze Namen Nutzwert in Zeile 4 und Spalte Kriterium
nwa$Kriterium[4] <- "Nutzwert"
# Gib Tabelle aus
nwa |>
mutate(
Gewicht = ifelse(is.na(Gewicht), "", sprintf("%.2f", Gewicht)), # Stelle 2 Nachkommastellen dar
`WI-Erb` = sprintf("%.1f", `WI-Erb`),
`MZ-Hech` = sprintf("%.1f", `MZ-Hech`),
Raunheim = sprintf("%.1f", Raunheim)
) |>
kable(
col.names = c("Kriterium", "Gewichtung", "WI-Erb", "MZ-Hech", "Raunheim"),
format = "html",
align = c("l", "c", "c", "c", "c")
)| Kriterium | Gewichtung | WI-Erb | MZ-Hech | Raunheim |
|---|---|---|---|---|
| Transportnaehe | 0.33 | 5.0 | 2.0 | 8.0 |
| Mietkosten | 0.33 | 8.0 | 5.0 | 2.0 |
| Fachkraefteverfuegbarkeit | 0.33 | 2.0 | 8.0 | 5.0 |
| Nutzwert | 5.0 | 5.0 | 5.0 |
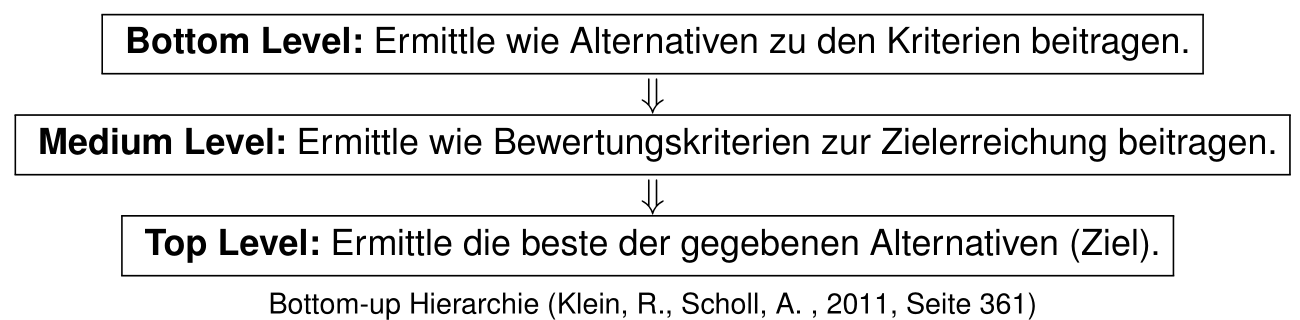
Analytical Hierarchy Process (AHP Methode)
Analytical Hierarchy Process (AHP Methode) - Beispiel
Fallbeispiel
SushiFresh vergleicht die drei Kandidatenstandorte Wiesbaden-Erbenheim (W-E), Mainz-Hechtsheim (M-H) und Raunheim (R) nun paarweise statt über direkt geschätzte Punktwerte. Folgende Bewertungskriterien werden herangezogen.
Bewertungsskala
| Präferenz | Wert |
|---|---|
| Gleich | 1 |
| Gleich bis leicht bevorzugt | 2 |
| leicht bevorzugt | 3 |
| leicht bis deutlich bevorzugt | 4 |
| deutlich bevorzugt | 5 |
| deutlich bis stark bevorzugt | 6 |
| stark bevorzugt | 7 |
| Stark bis extrem bevorzugt | 8 |
| Extremely preferred | 9 |
Analytical Hierarchy Process (AHP Methode) - Beispiel
Ablauf
Transportnähe
| site | W-E | M-H | R |
|---|---|---|---|
| W-E | 1 | 2 | 1/2 |
| M-H | 1/2 | 1 | 1/3 |
| R | 2 | 3 | 1 |
Mietkosten
| site | W-E | M-H | R |
|---|---|---|---|
| W-E | 1 | 2 | 4 |
| M-H | 1/2 | 1 | 2 |
| R | 1/4 | 1/2 | 1 |
Fachkräfte
| site | W-E | M-H | R |
|---|---|---|---|
| W-E | 1 | 1/7 | 2 |
| M-H | 7 | 1 | 5 |
| R | 1/2 | 1/5 | 1 |
Analytical Hierarchy Process (AHP Methode) - Beispiel
Ablauf
Transportnähe — Synthese (Berechnung des größten Eigenvektors)
Spaltensummen
| site | W-E | M-H | R |
|---|---|---|---|
| W-E | 1 | 2 | 1/2 |
| M-H | 1/2 | 1 | 1/3 |
| R | 2 | 3 | 1 |
| \(\sum\) | 7/2 | 6 | 11/6 |
Normierung
| site | W-E | M-H | R |
|---|---|---|---|
| W-E | 2/7 | 1/3 | 3/11 |
| M-H | 1/7 | 1/6 | 2/11 |
| R | 4/7 | 1/2 | 6/11 |
| \(\sum\) | 1 | 1 | 1 |
Konsolidierung
| site | W-E | M-H | R | \(\varnothing\) |
|---|---|---|---|---|
| W-E | 0.29 | 0.33 | 0.27 | 0.297 |
| M-H | 0.14 | 0.17 | 0.18 | 0.163 |
| R | 0.57 | 0.50 | 0.55 | 0.540 |
| \(\sum\) | 1 | 1 | 1 | 1 |
Analytical Hierarchy Process (AHP Methode) - Beispiel
Ablauf
Präferenzvektoren aller Standorte für alle Kriterien
| site | Transportnähe | Mietkosten | Fachkräfte |
|---|---|---|---|
| WI-Erb | 0.297 | 0.571 | 0.160 |
| MZ-Hech | 0.163 | 0.286 | 0.730 |
| Raunheim | 0.540 | 0.143 | 0.110 |
Analytical Hierarchy Process (AHP Methode) - Beispiel
Ablauf
| Kriterium | Transportnähe | Mietkosten | Fachkräfte |
|---|---|---|---|
| Transportnähe | 1 | 3 | 2 |
| Mietkosten | 1/3 | 1 | 1/5 |
| Fachkräfte | 1/2 | 5 | 1 |
| \(\sum\) | 11/6 | 9 | 16/5 |
Analytical Hierarchy Process (AHP Methode) - Beispiel
Ablauf
Nach demselben Verfahren (geometrisches Mittel der Zeilen, dann normieren) wie auf der vorherigen Folie für die Standorte ergibt sich für die drei Kriterien:
| Kriterium | Transportnähe | Mietkosten | Fachkräfte | \(\varnothing\) |
|---|---|---|---|---|
| Transportnähe | 6/11 | 1/3 | 10/16 | 0.501 |
| Mietkosten | 2/11 | 1/9 | 1/16 | 0.118 |
| Fachkräfte | 3/11 | 5/9 | 5/16 | 0.380 |
| \(\sum\) | 1 | 1 | 1 | 1 |
Analytical Hierarchy Process (AHP Methode) - Beispiel
Ablauf
\(\left( \begin{array}{ccc} 0.297 & 0.571 & 0.160 \\ 0.163 & 0.286 & 0.730 \\ 0.540 & 0.143 & 0.110 \end{array} \right) \times \left( \begin{array}{c} 0.501\\ 0.118\\ 0.380 \end{array} \right) = \left( \begin{array}{c} 0.280\\ 0.390\\ 0.330 \end{array} \right) \begin{array}{c} \text{= Score WI-Erb}\\ \text{= Score MZ-Hech}\\ \text{= Score Raunheim} \end{array}\)
Ergebnis: Beste Alternative ist Mainz-Hechtsheim — allerdings nur knapp vor Raunheim!
Vorteile AHP
Analytical Hierarchy Process (AHP Methode) - Konsistenzindex
Interpretation
\(\bar{P}\) ist der größte Eigenwert der Präferenzmatrix. Bei \(KI=0\) ist sie perfekt konsistent. Geprüft wird aber die Konsistenzrate: Faustregel \(CR < 0{,}1\). Mit \(CR \approx 0{,}14\) ist die Kriterienmatrix nicht hinreichend konsistent – die Paarvergleiche sollten überprüft werden.
\(RI\) nach Saaty: \(n=3\): 0,58; \(n=4\): 0,90; \(n=5\): 1,12
Neoklassische Standorttheorie – Steiner-Weber-Modell
Annahmen

Ziel
Gesucht ist der transportkostenminimale Standort für eine Produktions-, Lager- oder Umschlagsstelle im Absatzgebiet — bei SushiFresh: der ideale Punkt im Rhein-Main-Gebiet für die neue Produktionsstätte, unabhängig von den drei konkret verfügbaren Grundstücken.
Neoklassische Standorttheorie – Steiner-Weber-Modell
Modellformulierung
Bestimme Koordinaten \((x,y)\) im Absatzgebiet, die die gewichtete gesamte Transportdistanz zu den Kundenstandorten minimieren.
\[ \min\; Z(x,y) = \sum_{i=1}^{n} a_i \cdot d\big((x,y),(u_i,v_i)\big) \]
Entscheidungsvariable
Parameter
Distanzmaße
Steiner-Weber-Modell bei euklidischer Distanz
Für gegebene Kundenstandorte \((u_i,v_i)\) und Gewichte \(a_i\) gilt mit
\[ g_i(x,y)=\frac{a_i}{\sqrt{(x-u_i)^2+(y-v_i)^2}} \]
die Update-Regel
\[ x_{t+1}=\frac{\sum_{i=1}^n u_i\, g_i(x_t,y_t)}{\sum_{i=1}^n g_i(x_t,y_t)}, \qquad y_{t+1}=\frac{\sum_{i=1}^n v_i\, g_i(x_t,y_t)}{\sum_{i=1}^n g_i(x_t,y_t)}. \]
Umsetzung in R
steiner_weber_euclid <- function(data, x0 = NULL, y0 = NULL,
tol = 1e-6, max_iter = 1000) {
# data muss die Spalten u, v und a enthalten:
# u = x-Koordinate der Kunden
# v = y-Koordinate der Kunden
# a = Nachfragegewicht
stopifnot(all(c("u", "v", "a") %in% names(data)))
# Startwert: gewichteter Schwerpunkt, falls nichts vorgegeben ist
if (is.null(x0)) x0 <- sum(data$a * data$u) / sum(data$a)
if (is.null(y0)) y0 <- sum(data$a * data$v) / sum(data$a)
x <- x0
y <- y0
history <- data.frame(
iter = 0,
x = x,
y = y,
delta = NA_real_
)
for (t in 1:max_iter) {
# Abstand des aktuellen Standorts zu jedem Kunden
d <- sqrt((x - data$u)^2 + (y - data$v)^2)
# Iterationsgewichte gemäß Weiszfeld-Algorithmus
g <- data$a / d
# Aktualisierung der Koordinaten
x_new <- sum(data$u * g) / sum(g)
y_new <- sum(data$v * g) / sum(g)
# Änderung zwischen zwei Iterationen
delta <- sqrt((x_new - x)^2 + (y_new - y)^2)
history <- rbind(
history,
data.frame(iter = t, x = x_new, y = y_new, delta = delta)
)
# Abbruch bei hinreichend kleiner Änderung
if (delta < tol) {
return(list(
x = x_new,
y = y_new,
iter = t,
converged = TRUE,
history = history
))
}
x <- x_new
y <- y_new
}
list(
x = x,
y = y,
iter = max_iter,
converged = FALSE,
history = history
)
}Hinweise
Steiner-Weber-Modell bei euklidischer Distanz - Beispiel
| Filiale | Standort (u_i,v_i) | Nachfrage a_i |
|---|---|---|
| Wiesbaden | (8.2398; 50.0782) | 120 |
| Mainz | (8.2711; 50.0000) | 150 |
| Frankfurt | (8.6821; 50.1109) | 280 |
| Ruesselsheim | (8.4116; 49.9904) | 90 |
| Darmstadt | (8.6512; 49.8728) | 110 |
| Offenbach | (8.7761; 50.0956) | 95 |
| Iteration t | Standort (x,y) | Abweichung |
|---|---|---|
| 0 | (8.7500; 49.8500) | --- |
| 1 | (8.5959; 50.0087) | 0.2212 |
| 2 | (8.5851; 50.0443) | 0.0372 |
| 3 | (8.5868; 50.0536) | 0.0095 |
| 4 | (8.5904; 50.0565) | 0.0046 |
| 5 | (8.5937; 50.0581) | 0.0037 |
euklidisches Steiner-Weber-Modell — Short cut
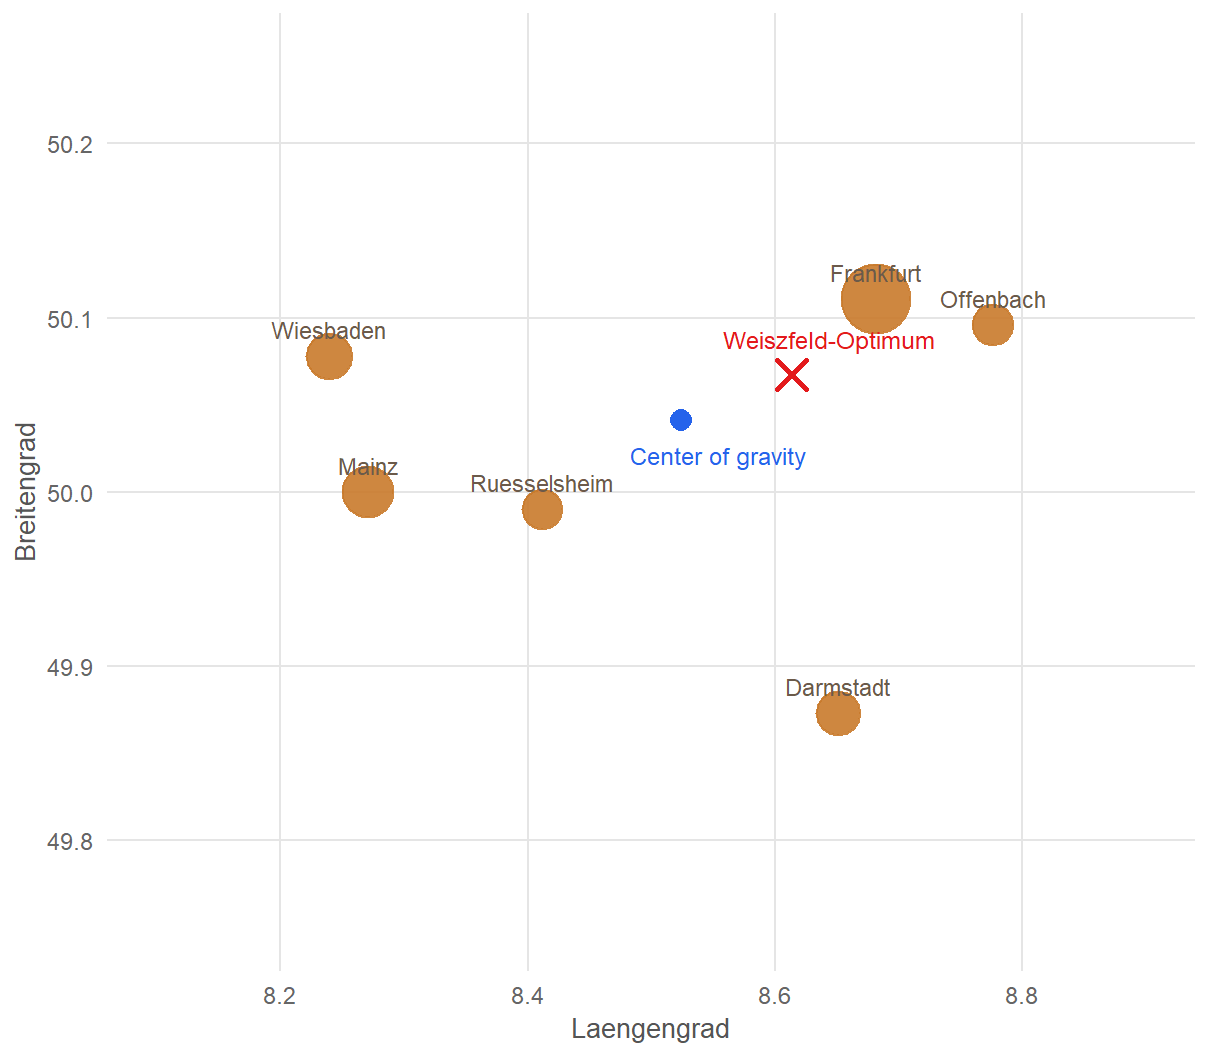
Center of gravity
Das Center of Gravity ist eine Schwerpunkt-Approximation des euklidischen Steiner-Weber-Problems (hier: Laengen-/Breitengrad naeherungsweise als planare Koordinaten behandelt):
\[ x^{CoG} = \frac{\sum_{i=1}^{n} a_i u_i}{\sum_{i=1}^{n} a_i}, \qquad y^{CoG} = \frac{\sum_{i=1}^{n} a_i v_i}{\sum_{i=1}^{n} a_i}. \] Für das SushiFresh-Beispiel gilt:
\[ (x^{CoG}, y^{CoG}) = (8.5241; 50.0410). \]
Das Center of Gravity ist schnell berechenbar, aber nur eine Approximation: Der iterative Steiner-Weber-Standort weist im Beispiel eine geringere nachfragegewichtete Gesamt-Haversine-Distanz auf (1.4016^{4} vs. 1.409^{4} Box-km).
Steiner-Weber-Modell mit Manhattan-Distanzen
Bestimme Koordinaten \((x,y)\) im Absatzgebiet, die die gewichtete gesamte Transportdistanz zu den Kundenstandorten minimieren.
\[ \min \; Z(x,y) = \sum_{i=1}^{n} a_i \left( |x-u_i| + |y-v_i| \right) = \sum_{i=1}^{n} a_i |x-u_i| + \sum_{i=1}^{n} a_i |y-v_i| \]
Algorithmus für den optimalen Standort
Bestimme für jede Dimension den gewichteten Median — hier beispielhaft für die \(x\)-Koordinate (Längengrad):

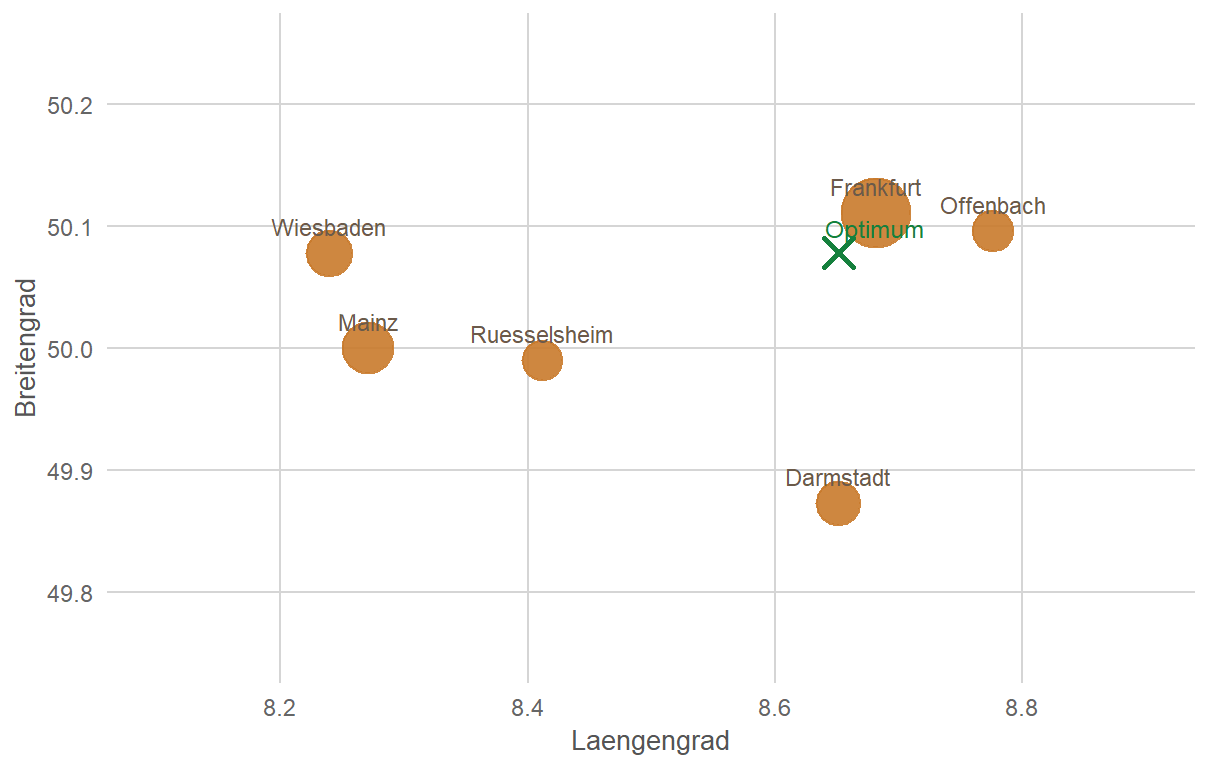
Für das SushiFresh-Beispiel ergibt sich: \[ (x^*, y^*) = (8.6512; 50.0782) \]

Supply Chain Management